在池大小大于1时保持FIFO处理方式
引言
最近新增的FIFO组功能,使得在互操作性生产环境中,即使池大小(Pool Size)大于1,也能保持先入先出(FIFO)模式的消息处理,从而在不牺牲准确性的前提下提升性能。 该功能首次出现在 InterSystems IRIS® 数据平台、InterSystems IRIS® for Health 以及 InterSystems Health Connect™ 的 2025.3 及更高版本中。
先进先出模式的消息处理在许多集成场景中至关重要,尤其是在医疗保健领域。传统上,通过将每个业务主机配置为每次仅处理一条消息(Pool Size = 1)来实现 FIFO 顺序。 尽管这种方法很有效,但可能会限制吞吐量并导致系统资源利用率不足。FIFO 组可在必要时保持 FIFO 顺序,而无需强制将 Pool Size 设置为 1。
FIFO 组:在保持 FIFO 顺序的同时实现并行处理的关键
FIFO 组提供了一种方法,既可在定义的关联消息组内保持顺序,又允许在非关联组之间进行并行处理。
与全局强制执行FIFO不同,FIFO组可让您:
- 对相互依赖的消息保持 FIFO 顺序。
- 同时处理相互独立的消息流。
FIFO 组的运作原理
- 确定 FIFO 组标识符在消息中确定一个定义依赖关系的值,例如患者的 MRN(医疗记录号)。 选择合适的 FIFO 组标识符至关重要。在医疗领域,常见的做法是使用患者标识符,但任何行业特有的标识符均可使用。
- 将消息分配到 FIFO 组使用数据转换或自定义代码,根据消息中包含的某个值,为每条消息分配一个 FIFO 组标识符。具有相同标识符的消息将确保按 FIFO 顺序进行处理。
- 启用组间并行处理属于不同 FIFO 组的消息可以同时处理。“Pool Size”(池大小)决定了可以同时处理多少个 FIFO 组。
- 控制FIFO约束何时终止可定义处理结束主机,一旦下游不再需要该顺序,即可释放FIFO约束。
何时使用 FIFO 组
在以下情况下,请考虑使用 FIFO 组:
- 当“池大小”=1无法满足性能要求时。
- 仅需对消息子集(而非整体)进行 FIFO 排序。
- CPU 使用率低于容量的 80%,且并行处理可提高吞吐量。
- 消息之间的依赖关系可以明确识别(例如通过患者ID、账户号或订单ID)。
示例:FIFO 组的标识符为患者 ID,且池大小 (Pool Size) = 2
考虑一个 Pool Size = 2 的医疗消息场景:
- 患者55、66和77各自的预入院、入院和出院消息已按此顺序发送至生产环境。
- 患者55、66和77的预入院、入院和出院消息必须按该患者的顺序依次处理。
- 患者55、66和77的消息彼此独立。
采用FIFO分组时:
- 每位患者的所有消息均按顺序处理。
- 任何一位患者的消息均可与其他患者的消息并行处理。
- 例如,患者55和66的入院前通知可以同时处理。
- 即使同时处理两条消息,也不会违反任何患者的消息顺序。
这种方法既保证了准确性,又提高了性能。
有关患者 55、66 和 77 的消息处理的更多详细信息,请参阅文末 “对 FIFO 组处理的更详细探讨”一节 。
Pool Size > 1 的 FIFO 组配置示例
生产流程描述:生产端 接收数据,根据下游系统的需求对数据进行转换,然后将数据发送至下游系统。每位患者的消息必须按接收顺序(FIFO)进行处理。

步骤 1:确定 FIFO 组的标识符
- 确定决定消息顺序的依据。该值将成为 FIFO 组的标识符,例如患者 ID、账户号或订单号。
在本例中:MRN作为FIFO组的标识符。
步骤 2:选择起始主机
- 确定 FIFO 分组应从何处开始:
- 通常是一个业务流程或路由引擎。
- 这是需要对消息进行排序的第一个业务主机。
在此示例中:Example.MessageRouter
步骤 3:创建数据转换以计算 FIFO 组
- 创建一个数据转换,其中包含:
- 源:输入消息类型
- 目标:Ens.Queue.FIFOMessageGroup.Data
- 目标消息的Create=new
- 定义以下必填属性:
- 标识符:从消息派生的字符串(例如,患者 ID)
- 如有必要,请定义可选属性(参见文档):
- Dependencies(可选):需优先处理的其他 FIFO 组
- CompletionHosts(可选):负责解除 FIFO 约束的主机
步骤 4:配置起始主机
- 在源业务主机上:
- 使用数据转换的名称定义“组计算”
- 这将启用对传入消息的 FIFO 分组
步骤 5:将“Pool Size”设置为大于 1
- 在源主机上将“Pool Size”配置为大于 1
- “池大小”决定了可以并行处理多少个 FIFO 组
- 例如,当“池大小”设为 2 时,可同时处理两个 FIFO 组,即两个独立的数据流
结论
使用 FIFO 组可安全地将池大小设置为大于 1,在可能的情况下允许并行处理,同时在必要时保持严格的顺序。这种方法对于高性能和一致性都至关重要的高吞吐量集成尤为有用。
FIFO组处理的详细分析
本节分步骤描述了基于 FIFO 组的处理机制。
在下面的示例中,路由器的消息队列按接收顺序存储消息。尽管整体顺序并非严格遵守,但每个相关消息组内部仍保持 FIFO 顺序。
示例:当池大小(Pool Size)为 2 时,同时处理患者 55、66 和 77 的消息。
开始
- 有两条消息正在处理中:患者55和患者66的入院前准备

下一步
- 患者66的入院前处理消息已完成,患者55的仍在处理中

- 下一条消息:
- 患者77的入院预登记(该患者目前无任何处理任务)

下一步
- 患者77的入院前登记已完成,患者55的登记仍在进行中

- 下一条消息:
- 无法处理患者55的消息(仍在处理中)
- 可对患者77进行处理
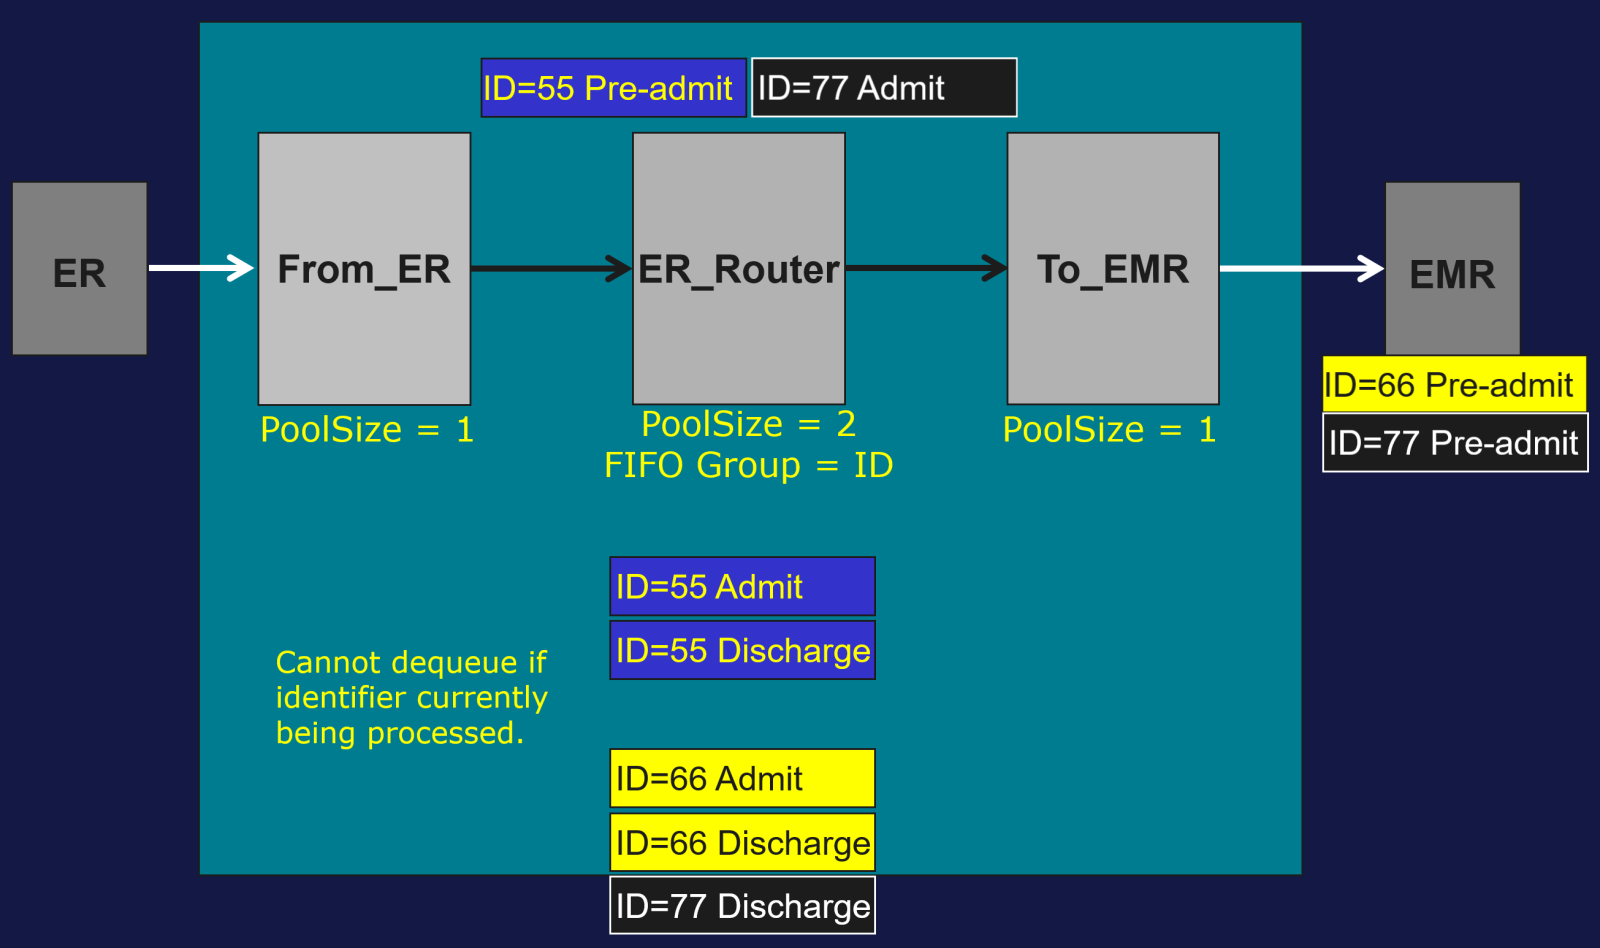
下一步
- 患者55的预入院手续已完成,患者77的入院手续正在进行中

- 下一条消息:
- 患者55已入院(该患者目前无正在进行的治疗)

下一步
- 患者77的入院手续已完成,患者55的入院手续正在进行中

- 下一条消息:
- 无法处理患者55的出院手续(仍在处理中)
- 可办理患者66的入院手续
