文章 Shengzhi Wu · 十月 28 13m read

🏆 比赛投票进行中(截止美东时间 11 月 15 日)。如果这篇文章对你有用,欢迎在 Open Exchange 上给 PaymentGuard AI 投一票——在列表里找到 PaymentGuard AI 点 Vote 即可。

在线体验:http://43.139.159.100:8082/paymentguard/

——仪表盘、REST API 与背后的互操作生产全程在线,灰色地带决策由 DeepSeek 实时作出。

本文是英文参赛文章的中文版。源码:github.com/Dylan5237/payment-guard-ai。

以下是正文:


支付授权,本质上是个决策问题。

大多数支付没什么可纠结的:老客户、熟悉的金额、常用的设备,几条确定性规则微秒级就能放行或拦下。真正难的是中间那片灰色地带——新设备、不常见的国家、比平时高出一截的金额、KYC 还没过审的客户。人工分析师的时间基本都耗在这里,而这恰恰是大模型 Agent 能帮上忙的地方——前提是它手里有真工具,查得到真数据。

PaymentGuard AI 做的事就这么直接:把一个真实的 IRIS AI Hub Agent(%AI.Agent)当成一个业务操作,塞进一条普通的互操作生产里。
0
1 32
InterSystems开发者社区
与开发者和专家交流,提出问题、寻找答案,并分享有关 InterSystems 技术、产品和解决方案的知识。 了解更多
28,980 名开发者,社区仍在不断壮大
文章 John Pan · 十月 28 16m read

为什么同一个人有两条记录,名字却不同?当相似的记录包含相互冲突的标识符时,系统应如何处理?当关键信息缺失时,系统应给出建议,还是应向来源方索取更多证据?

这些问题促使我开发了“患者身份冲突审查助手”。我希望在互操作性工作流中嵌入一个人工智能代理,供人工审查并可随时暂停。该代理负责收集证据并推荐处理方案;而人工审查员则负责授权记录之间的关联。

该应用程序使用了InterSystems IRIS Community AI Hub EAP 版本 154 中的原生 ObjectScript SDK。本文描述的是 pi-review1.1.0版本(提交编号 ab53930)。 所有案例和源数据均为合成数据,与任何医院均无关联。模型使用情况来自保存的实时呼叫记录。

项目链接:GitHub 代码库·Open Exchange 应用程序 (1.1.0)·带版本号的安装指南。下文所述的实现基于已固定的 1.1.0 源代码。

从一个缺失数据案例开始

合成案例 c6 最初缺少身份标识符和出生日期。一名操作员明确启动了调查。代理读取了该案例,验证了其来源,检索了治理规则,并返回了 NEEDS_DATA。随后,生产环境通过原生 MCP 请求了数据丰富处理。

当操作员获取数据丰富结果时,服务器在更新案例前检查了收据、来源范围和版本。随后,操作员显式地启动了另一项调查

0
1 26
文章 John Pan · 5 小时 前 3m read

这个故事已经伴随我二十多年了。

在ObjectScript的早期,$Functions的容量是有限的。
你必须将其作为程序的一部分来编写。
但这些功能通常都已实现,只是没有名字而已。
要使用它,你需要通过 $ZU() 函数进行“系统”调用。 参见参考手册

随着时间的推移,大多数 $ZU() 函数已被弃用,并被“官方”的 $Functions 所取代。
但要如何在数十年间写下的上千行代码中
——这些代码由无数早已销声匿迹的程序员编写而成。
Studio 虽然是款新工具,但性能并不理想。
因此,我开发了一个搜索工具,用于扫描所有可能的ObjectScript代码角落 
它完全采用ObjectScript编写,完全避开了所有系统方法。
这使其具有独立性,并在准备向 IRIS 迁移时发挥了重要作用

它看起来是这样的:

USER>do^rcc
  • 首先输入要搜索的字符串
  • 启用“详细模式”可查看匹配项的详细信息
  • “强制大写”功能可使扫描不区分大小写
  • “代码类型”可将扫描拆分为多个步骤
  • “命名空间”定义了扫描的执行位置
    • 对于 %SYS 以外的命名空间,%-routines 和 %-classes 始终被排除在外

实用提示

0
0 3
文章 John Pan · 5 小时 前 2m read

在测试新增的多命名空间功能时,我遇到了一个难题
,这需要人工干预。这个简单的请求产生了1000行的输出。

USER>do^rcc
  • 至于详细模式,你可以在终端上运行日志以获取详细结果
  • ,尽管真正的摘要仍然缺失。

因此,我决定在摘要行后附加一个非常简练的统计信息

1206

我附加在末尾的这份摘要展示了
90000+次点击的分布情况。

该统计同样适用于“ALL”命名空间的选择,也适用于单一代码类型

enter search string [

请在演示服务器上试用

演示服务器 SMP
演示服务器 WebTerminal
 

0
0 3
文章 John Pan · 5 小时 前 3m read

受@Eberle的个人反馈 以及
中@Michael. Braam关于向量搜索的一场精彩演讲的启发, 我想分享
——这是我个人对向量处理的方法。
当我刚开始接触256、384甚至超过1200维的向量时,曾感到无所适从。
不过,我的示例“Vector-inside-IRIS”(即对iris-vector-search 的简化版)运行得相当顺利。
为了理解其背后的运作机制,我决定从小处着手。
我们常见的3维空间足以很好地描述我们的物理世界。
即使是爱因斯坦添加的“半第四维”(不包含负数),也不难理解。
而具有0到11+维度的宇宙弦理论,对我来说确实是一道难以逾越的门槛。

所以回到起点:=> 对于初学者来说,2维就足够了。
地理坐标提供了一个很好的起点,并附有足够的测试数据。
在我的 地理向量搜索示例中,VECTOR_COSINE() 函数是我主要关注的目标

在准平坦投影地图上,-1 到 +1 的结果范围很容易理解。
这是基础数学,将其推广到额外维度并非什么奇迹。
但如果是上百个维度呢?

;#1010494301472898

为便于阅读,此处的示例已进行简化

经过一番思考后,我脑海中浮现出这样一幅画面:

  • 当我在谷歌地图上搜索一个并非近在咫尺的目的地时,系统会提供多种路线供我选择。
  • 最短路线、最快路线、油耗最低的路线、公共交通路线……
  • 我会根据自己的需求做出选择
0
0 3
文章 John Pan · 5 小时 前 3m read

最近,我遇到了一个与代码维护相关的由来已久的问题:

  • 你只能通过 ODBC/JDBC 访问 IRIS 服务器
  • 无法通过 VSCode 访问,也无法通过 Studio 访问
  • 也无法通过(Web)终端访问

但您需要查看类、子程序或全局变量!!
无论如何,SQL 都是您的得力助手。

  • 首先,你需要一个简单的表作为临时文本存储。
CREATEGLOBALTEMPORARY

这并不是什么令人兴奋的操作。

  • 接下来,将代码导出到本地文件,并将其导入到表格中
IN

使用方法:

where

结果如下:

"1"
  • 或者,如果您更倾向于使用XML输出而非UDL,请使用以下传统方法:
  • 请将$system.OBJ.Export() 作为 导出方法。

如有需要,XML 对于全局导出可能很有用

where

而所有这些操作都是通过 ODBC/JDBC 运行的

0
0 3
文章 John Pan · 5 小时 前 3m read

主机变量是许多 SQL 实现中相当常见的编程特性。 
最近在DC上看到的一个问题让我意识到,在IRIS、Caché、Ensemble等系统中…… 
主机变量仅存在于嵌入式 SQL 中

> 您只能为嵌入式 SQL查询提供主机变量。<

相关示例包含在现有文档中

以下是针对无法或不愿使用嵌入式 SQL 时的解决方法说明。
 

0
0 3
文章 John Pan · 5 小时 前 3m read

15秒简介:https://youtu.be/veKSM1THLeo

大家好,我是阿诺尔夫(Arnolf),一名独立开发者。

我正在开发Medichrona,它能将一名患者的终身医疗记录转换为运行在 InterSystems IRIS for Health 上的时序知识图谱,并允许您在浏览器中以 3D 形式逐年探索这些数据。这些数据来自 InterSystems 示例中的 Synthea 合成患者数据。

本文将详细说明数据如何从FHIR数据包呈现到3D界面。

演示视频

0
0 5
文章 John Pan · 6 小时 前 18m read

本文介绍了SHAP可解释性方法,将其作为理解机器学习“黑箱”模型预测背后原因的一种途径。文中还提供了一个简单的Jupyter笔记本,您可以使用并修改它,从而对这些概念进行实践操作:

https://www.kaggle.com/code/jorgeivnjh/explainability-in-ml-models

https://github.com/JorgeIvanJH/Explainability-in-ML-models

我们将利用这些概念,在未来将它们应用到我们的持续培训管道中:https://community.intersystems.com/post/complementing-iris-mlflow-continuous-training-ct-pipeline

在本笔记本中,我们将探讨黑盒模型可解释性的直观理解。黑盒模型是指复杂程度超出人类直接理解范围的模型,例如神经网络以及梯度提升(如 XGBoost、LightGBM、CatBoost)等集成学习方法。

在开始之前,有必要澄清可解释模型与可解释性模型之间的区别:

可解释模型是指仅通过观察模型本身,我们就能直接理解输入的变化如何影响输出的模型。 线性回归便是如此,其中每个变量都关联一个系数,该系数表明该变量如何影响预测结果。单棵决策树也是如此,通过追踪其分支,我们可以准确理解预测是如何得出的。

0
0 5
文章 John Pan · 6 小时 前 5m read

在通过集成引擎管理关键医疗数据时,您希望在队列开始积压或服务中断的瞬间立即得知。 

遗憾的是,这通常会导致收件箱被通知邮件塞得满满当当,有时甚至让人觉得根本无从处理。

好吧,我并没有解决这个问题。 

但我开发了一款可能有所帮助的工具……

0
0 6
文章 John Pan · 6 小时 前 3m read

欢迎阅读我的CI/CD 系列文章的下一章,本章将探讨利用 InterSystems 技术和 GitLab 进行软件开发的可行方案。

今天,我想分享几种能够缩短编译时间的方法(特别是当你采用增量/差异编译而非全量构建时)。

编译器标志和限定符

代码加载和编译会受到各种标志和限定符的影响。如果您正在编写针对 InterSystems 平台的部署脚本,我强烈建议您至少通读一遍相关文档。虽然大多数标志和限定符都有非常具体的用途,但了解它们的功能,将来某一天可能会为您节省大量时间。要列出所有标志和限定符,请执行以下命令:

Do$systemDo

文档中也有相关说明 。无论如何,这里最重要的标志是u(仅更新)——如果启用该标志,系统将跳过对已处于最新状态的类的编译。 在进行增量编译时,使用此标志可节省 99% 的时间,因为只有修改过的代码才会被编译。 
 

仅加载已修改的代码

递归导入固然不错,但如果你有上千个类,而上次提交中仅修改了其中两个,那么除了为了简单起见之外,其余 998 个类就完全没有必要加载了。 值得庆幸的是,Git 可以轻松回答诸如“在abc 和 xyz 这两个提交之间,哪些文件发生了变化?”之类的问题。以下是一个示例代码,它接受两个 Git 标识符(提交、分支名称、标签),并返回三个列表:

  • 新增文件
0
0 5
文章 John Pan · 11 小时 前 11m read

加入 InterSystems 已经一年了,我在开发者社区上看到过许多精彩的文章。问题在于,当我的代码真正需要用到这些文章时,却很难再次找到它们。

Claude Code 已经与我们的服务器、文档和 Perforce 紧密集成。但社区层还缺失,所以我为此编写了一个技能:一个 Python 脚本,无依赖,外加一个 SKILL.md。

我想解答的问题是:我正在编写这个类,社区对其中涉及的模式已经有哪些讨论了?

为什么不直接封装网站自带的搜索功能呢?因为它是客户端渲染的:通过 HTTP,/search?search_api_fulltext= 返回页面框架,因此任何查询都会显示相同的 11 个热门侧边栏链接。 服务器端渲染返回的内容是 /tags/ 页面、文章正文及其评论,以及 /sitemap.xml(约 17,500 个 slugs)。该技能正是基于这三部分构建的。

命令

共有九个命令,每个命令提供一种不同的访问方式。有些将关键词解析为标签,有些搜索标题,有些获取文章或作者,还有一个命令以整个类作为输入。以下是这些命令的列表,每个命令下方都配有实际示例。

所有输出均为 JSON 格式,这是助手最易处理的格式。

tags

探索词汇表。这是首要步骤,因为该网站有234个标签,且这些词并非你所能猜到的。

$ python dc_search.py tags "zen report pdf"
["zen", "intersystems-reports-logi", "data-import-and-export"]
0
0 5
文章 John Pan · 11 小时 前 10m read

在第 1 部分中,我们探讨了窗口函数的工作原理。我们了解了 PARTITION BY、ORDER BY 以及 ROW_NUMBER() 和 RANK() 等函数背后的逻辑。现在,在第 2 部分中,让我们通过实际示例深入探讨更多窗口函数。


  1. 窗口聚合函数

概述

这些函数会在定义的窗口范围内计算聚合值(例如:求和、求平均值、求最小值、求最大值、计数等),但不会合并行。 每行数据仍保持可见,并附加其分区对应的聚合值。

支持的函数包括以下内容:

  • AVG() — 窗口帧内值的平均值。
  • SUM() — 窗口帧内值的总和。
  • MIN() — 最小值。
  • MAX() — 最大值。
  • COUNT() — 行数或非空值的个数。

语法:

function(...) OVER (PARTITION BY ... ORDER BY ...)

示例 1 — 部门薪资分析

让我们分析一下每位员工的薪资

0
0 7
文章 John Pan · 11 小时 前 8m read

字符串相关问题

我正在使用 Python 通过 JDBC(或 ODBC)访问 IRIS 数据库。我想将数据导入pandas数据框中,以便对数据进行处理并生成图表。 在使用 JDBC 时,我遇到了字符串处理方面的问题。撰写这篇文章是为了帮助可能遇到同样问题的其他人。或者,如果有什么更简单的方法可以解决这个问题,请在评论中告诉我!

我使用的是 OSX 系统,因此不确定这个问题是否具有特殊性。我使用的是 Jupyter Notebooks,不过即使您使用其他 Python 程序或框架,代码通常也大致相同。

JDBC 问题

当我从数据库中提取数据时,列描述和任何字符串数据都会被返回为数据类型 java.lang.String。 如果你将 print 字符串数据作为输入,结果会显示为: "(p,a,i,n,i,n,t,h,e,r,e,a,r)",而不是预期的 。

这很可能是因为使用 JDBC 检索时,数据类型为 的字符串被作为可迭代对象或数组返回。 如果所使用的 Python-Java 桥接库(例如 JayDeBeApi、JDBC)无法在单一步骤中自动将 转换为 Python 中的 str,就会出现这种情况。

相比之下,Python 的 字符串表示法将整个字符串视为一个整体。当 Python 检索普通的 (例如通过 ODBC)时,不会将其拆分为单个字符。

JDBC 解决方案

0
0 4
文章 John Pan · 11 小时 前 3m read

每天都应该有这样一句:“我不知道你还能那样做”。

背景

我在 Linux 操作系统上使用 Neovim 文本编辑器已经有一年了,主要用 Python 开发一些新的 LLM 模型。前阵子我曾尝试将 IRIS 语言服务器与 Neovim 结合使用,但这个过程有些费时费力。今天的需求是:

  1. 在我的 Ubuntu 环境中使用 IRIS 进行编辑,但无需在主机上直接安装 VSCode。
  2. 不希望我的代码在云端进行AI训练
  3. 现在就做!!

要求

我在开发周期中已经使用了 Docker。继续沿用这一方案非常合适。

VSCode 是一款可视化编辑器,而非纯文本编辑器,因此我需要借助 Docker 来建立远程桌面会话,并运行基于图形界面的工具。

该容器为一次性容器,将在每次会话结束时被销毁。

该容器绝不能连接到云端托管的 AI 工具。

该容器严禁连接互联网上的任何其他服务。

该容器已预先安装并配置好,可用于运行 IRIS Editor。

只需执行 **docker run** 命令即可开始使用。

研发

经过半天的时间,我尝试搭建了一个搭载不同XRDP服务且采用多种连接协议的纯净版Ubuntu Docker镜像,并进行了测试。

0
0 4
文章 John Pan · 11 小时 前 3m read

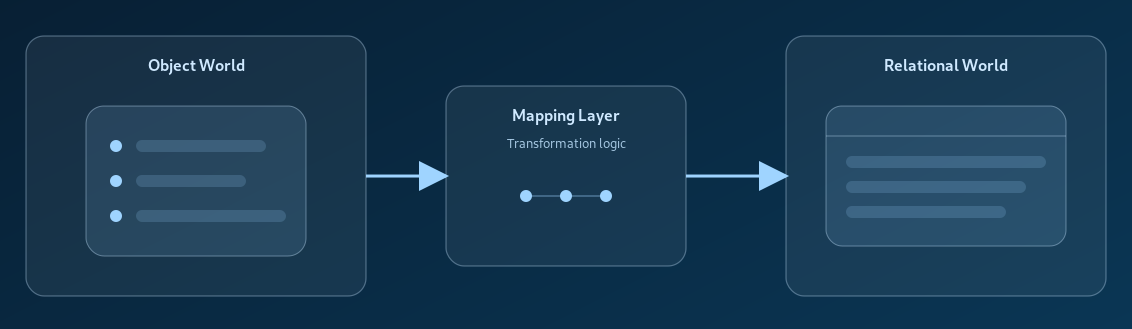
持久化类是使 InterSystems IRIS 与传统应用程序数据库区别开来的功能之一。开发人员无需将数据库表与应用程序对象分开设计,而是可以定义一个类,并让 IRIS 管理其持久化表示形式。这使得应用程序的对象模型与底层数据模型之间建立了紧密的联系。

一个基本的持久化类继承自 %Persistent:

Class MyApp.Product Extends %Persistent
{
    Property Name As %String;
    Property Price As %Numeric;
    Property Stock As %Integer;
}

编译后,该类即可作为持久化数据模型使用。每个实例代表一个产品,该产品可被存储在数据库中。但是,创建对象并不意味着数据会立即插入数据库。该对象最初仅存在于内存中。

Set product = ##class(MyApp.Product).%New()
Set product.Name = "Keyboard"
Set product.Price = 99.90
Set product.Stock = 25

Set status = product.%Save()

对于初学者而言,内存对象与持久化对象之间的这一区别非常重要。 方法用于创建对象,而 %Save() 则用于将对象的当前状态持久化。

0
0 7
文章 John Pan · 11 小时 前 3m read

持久化类是使 InterSystems IRIS 与传统应用程序数据库区别开来的功能之一。开发人员无需将数据库表与应用程序对象分开设计,而是可以定义一个类,并让 IRIS 管理其持久化表示形式。这使得应用程序的对象模型与底层数据模型之间建立了紧密的联系。

一个基本的持久化类继承自 %Persistent:

Class MyApp.Product Extends %Persistent
{
    Property Name As %String;
    Property Price As %Numeric;
    Property Stock As %Integer;
}

编译后,该类即可作为持久化数据模型使用。每个实例代表一个产品,该产品可被存储在数据库中。但是,创建对象并不意味着数据会立即插入数据库。该对象最初仅存在于内存中。

Set product = ##class(MyApp.Product).%New()
Set product.Name = "Keyboard"
Set product.Price = 99.90
Set product.Stock = 25

Set status = product.%Save()

对于初学者而言,内存对象与持久化对象之间的这一区别非常重要。 方法用于创建对象,而 %Save() 则用于将对象的当前状态持久化。

0
0 4
文章 John Pan · 11 小时 前 1m read

如果您正在将 InterSystems IRIS for Health(或 HealthShare Health Connect)升级至 v2025.3 或更高版本(例如 2026.1.x),并且正在使用我们的 FHIR 服务器,请务必注意一项可能对您的环境产生严重影响的变更。

0
0 6
文章 cheng yu · 12 小时 前 5m read

2020年,我为FHIR竞赛编写了iris-fhir-portal,并在四篇文章中对此进行了说明:

  1. 我使用 FHIR 的经验
  2. irisfhir-portal 概述
  3. 使用 fhir.js 更新患者资源
  4. 使用 SQL 获取 FHIR 信息

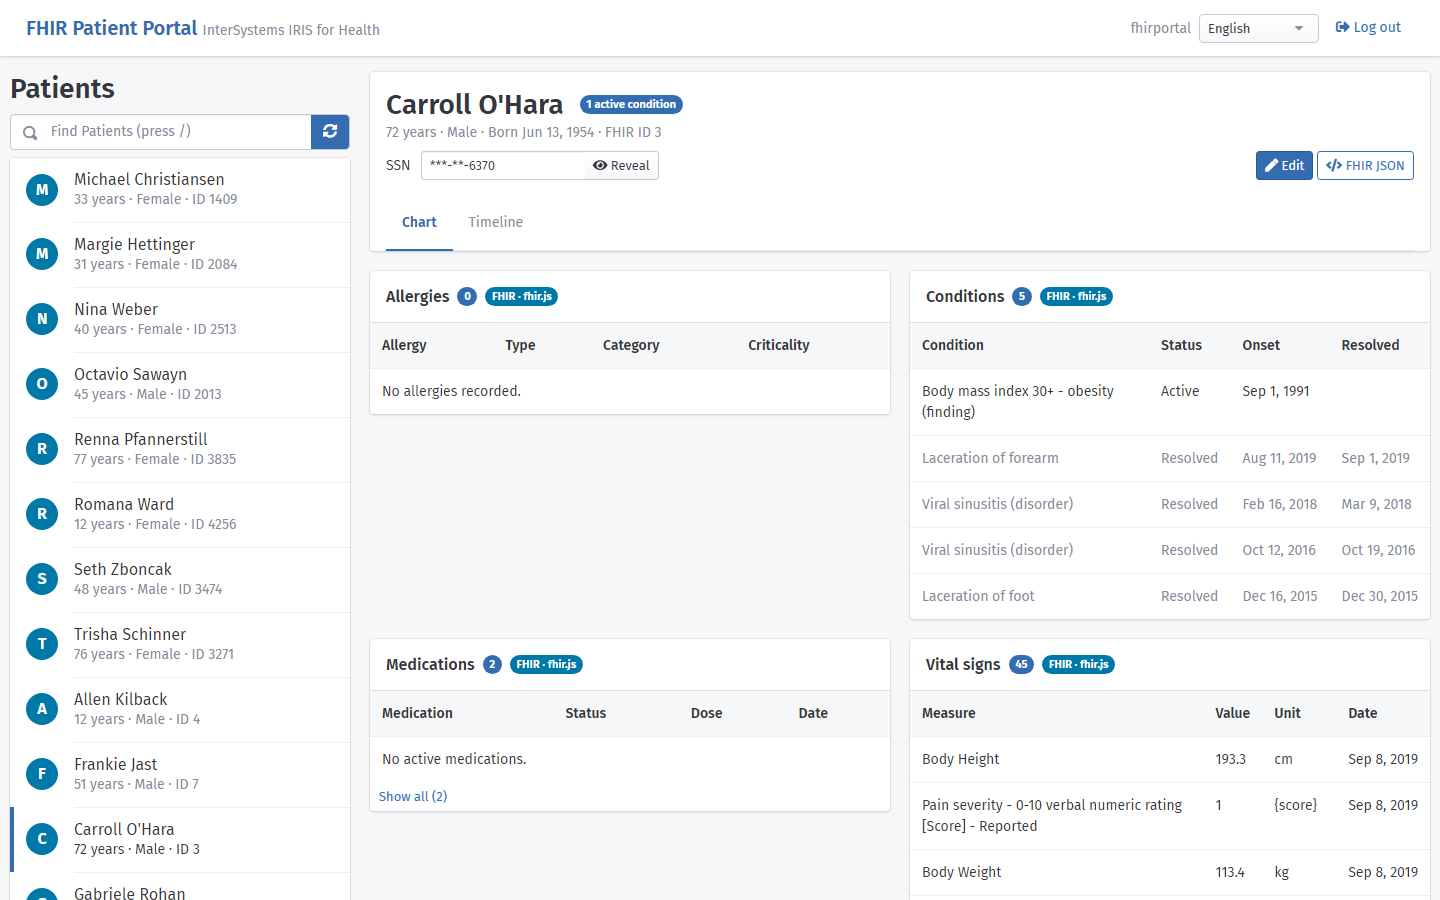
该门户仍由 iris-fhir-template (zpm "install fhir-portal") 安装,但在当前的 IRIS 系统上已无法正常运行:实验室结果页面显示为空,文章的 SQL 模式已丢失,且页面上没有登录功能。 本文将介绍如何将其迁移至 IRIS for Health 2026.2 版本,以及各文章中发生了哪些变化。

The patient chart

0
0 4
文章 cheng yu · 12 小时 前 11m read

PaymentGuard 的仪表盘如何逐步重构 AI 决策过程——以及如何将相同的视图添加到另一个 IRIS 生产环境中。

实时演示:http://43.139.159.100:8082/paymentguard/· 来源:github.com/Dylan5237/payment-guard-ai· 上一篇文章:PaymentGuard AI:作为 IRIS 互操作性生产环境中欺诈决策者的 AI Hub 代理

“黑箱”问题

一个AI代理可以在两秒内给出支付决策。棘手的问题在于,在这两秒钟内究竟发生了什么。

哪些消息在生产环境中流转过?代理看到了哪些上下文信息?它调用了哪些工具,又得到了什么反馈?谁批准了最后一步,模型的成本是多少?

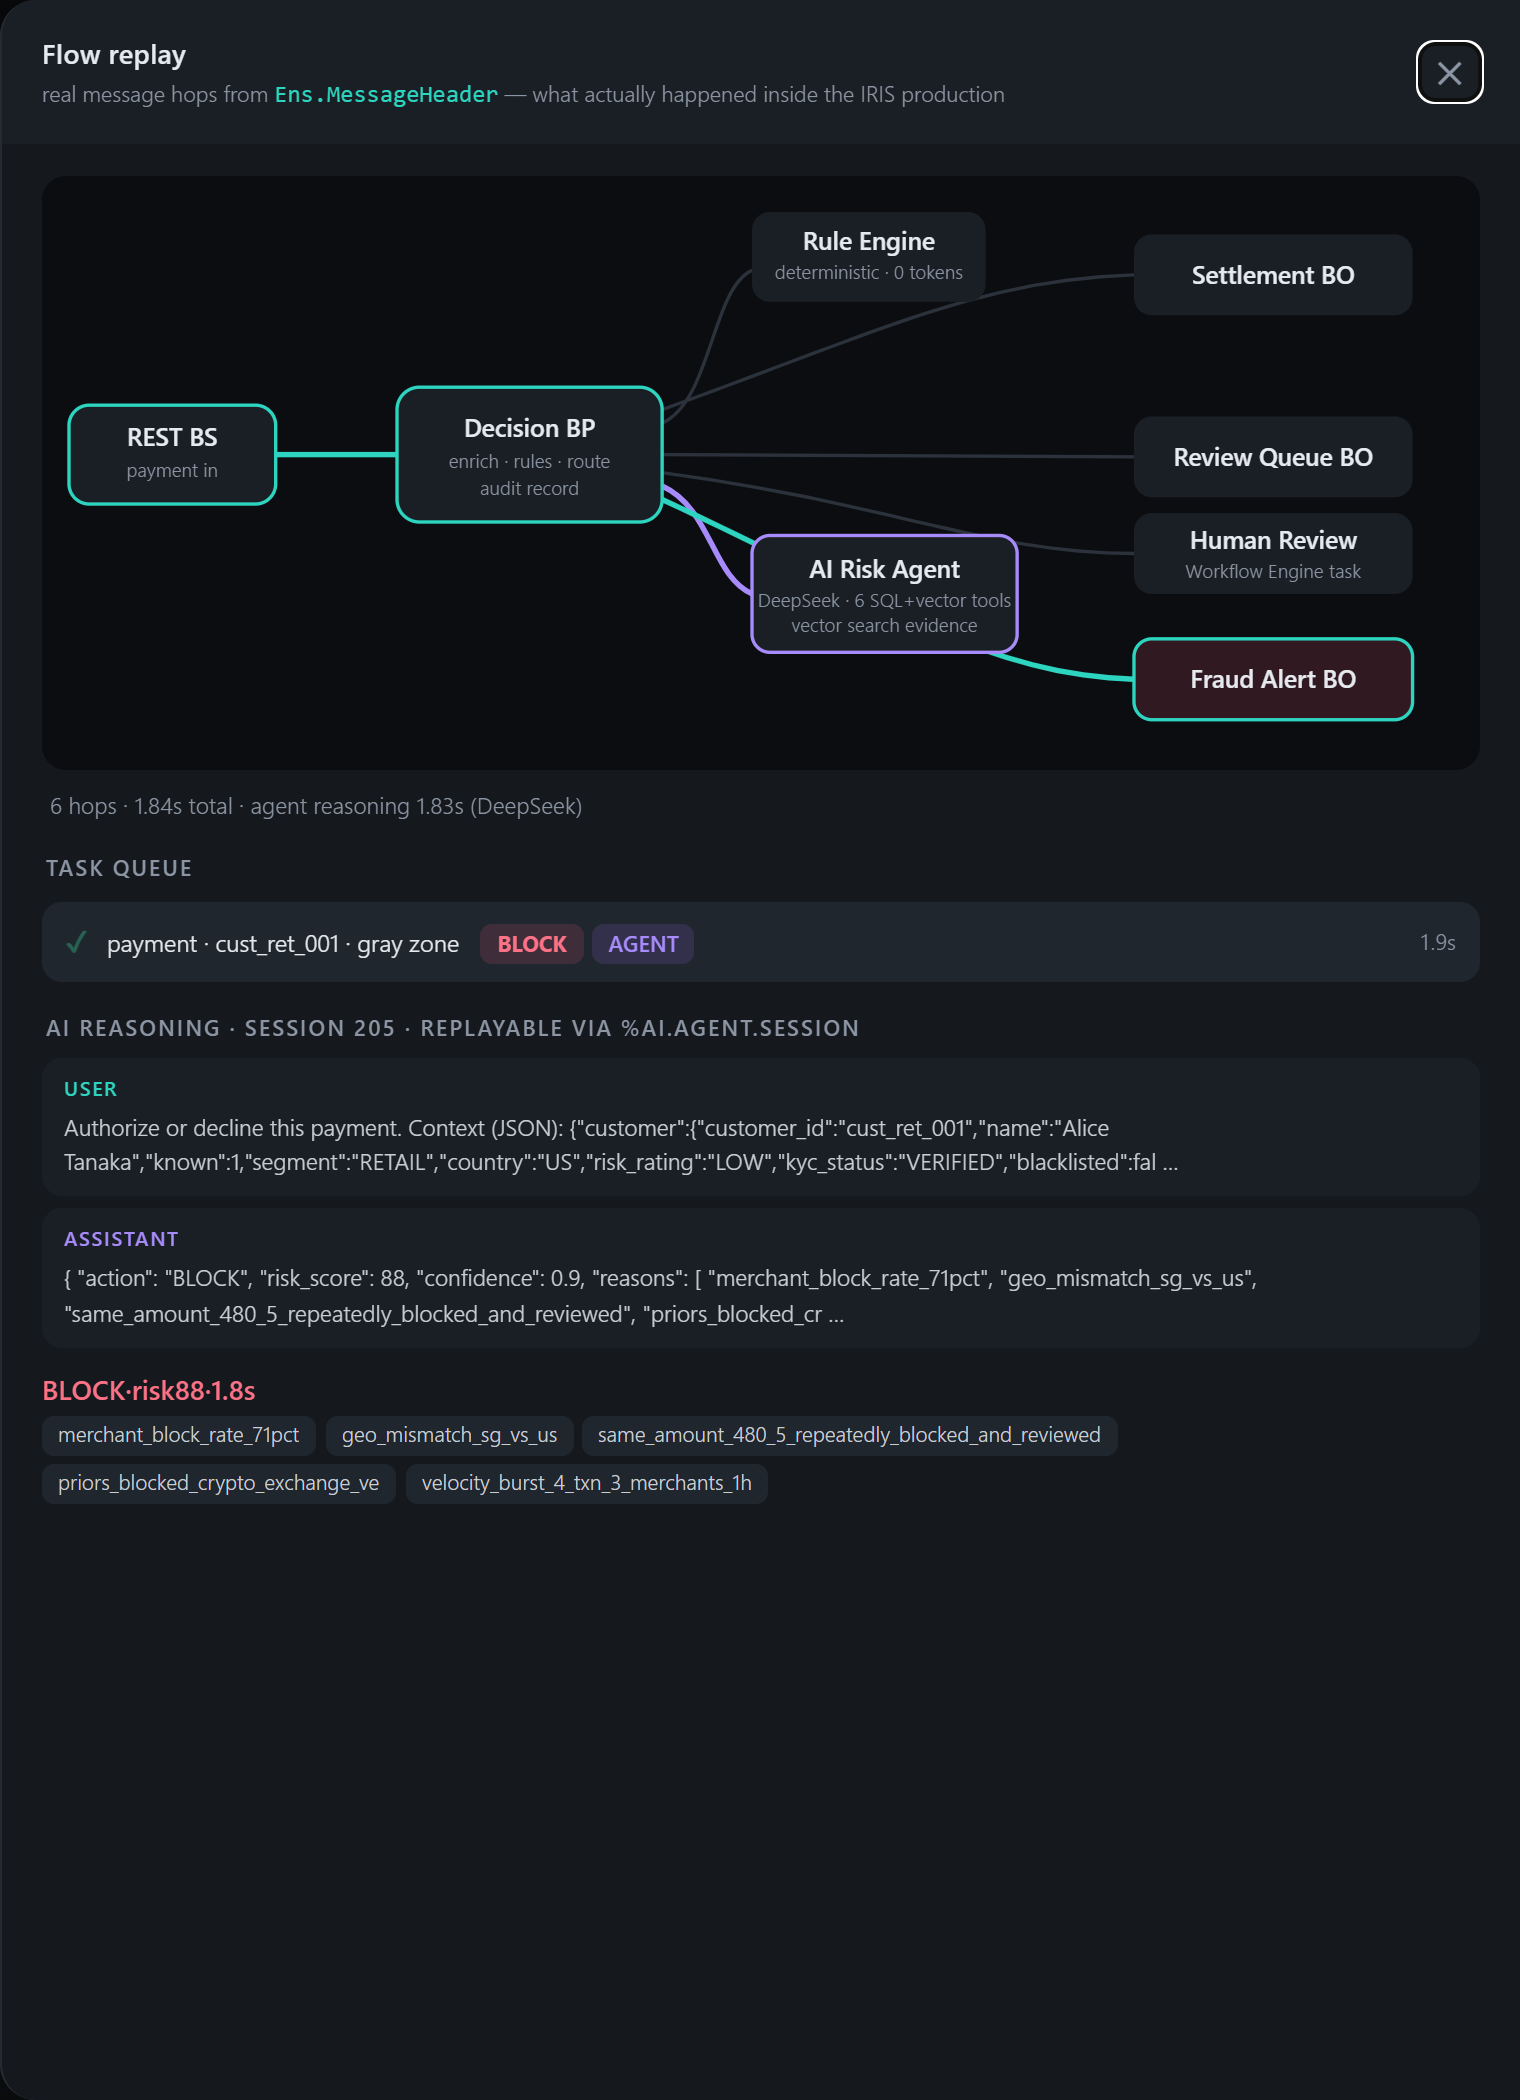
对于可能阻断支付或放行欺诈的工作流而言,“模型这么说的”并不构成审计轨迹。 PaymentGuard 的仪表盘通过“重放面板”解答了这些问题:选择一项决策,系统便会以真实的毫秒级时间戳,逐个节点回放实际的生产路径。在底层,代理的推理链会按消息顺序逐条展开。

该面板中的内容均非合成数据。每个步骤都是一行 Ens.MessageHeader。每个推理步骤都是一条持久化的 %AI.Agent.Session。该仪表盘是基于 IRIS 已记录数据构建的展示层。

0
0 7
文章 Shengzhi Wu · 17 小时 前 10m read

PaymentGuard 的仪表盘如何逐跳还原一次 AI 决策,以及如何把同样的视图加到另一个 IRIS 生产里。

在线演示:http://43.139.159.100:8082/paymentguard/ 源码:github.com/Dylan5237/payment-guard-ai 上一篇:PaymentGuard AI:让 AI Hub Agent 在 IRIS 互操作生产里管支付风控

以下是正文:


问题:决策很快,过程是黑盒

Agent 两秒内就能给出支付决策。真正难回答的是这两秒里发生了什么。

生产里走了哪些消息?Agent 看到了什么上下文?调了哪些工具、拿回了什么?最后一步是谁批的?模型花了多少 token?

对于一笔可能拦掉客户支付、也可能放过欺诈的决策,"模型说可以"不构成审计记录。PaymentGuard 的仪表盘用一个回放面板回答这些问题:选中一笔决策,真实的生产链路按毫秒逐跳播放;下方再展开 Agent 的推理链,一条消息一条消息地看。

面板里没有编造的内容。每一跳都是 Ens.MessageHeader 的一行,每一步推理都来自持久化的 %AI.Agent.Session。仪表盘只是把 IRIS 已经记录的数据拼成一个视图。

这篇文章讲它是怎么实现的,包括最花时间的几个细节,最后给一份可以套用到其他 IRIS 生产上的清单。

PaymentGuard AI 的 Flow 回放面板:任务队列、按生产拓扑逐跳回放的真实 Ens.MessageHeader 链路(含 Human Review 工作流节点),以及 Agent 推理链

0
0 6
公告 Claire Zheng · 18 小时 前

Hi 大家好!

InterSystems技术分享线上课第五期来啦!这期课程我们将聚焦“基于JSON的通用SQL组件”这一主题。

👉点击此处报名参加培训👈

以下场景,你是否熟悉?

  • 需要定时从HIS或其他业务数据库中抽取数据,不同场景往往需要进行相应的开发和配置。
  • 外部系统传入不同的查询条件,需要执行不同的SQL,接口越来越多,开发和维护工作也随之增加。
  • 面对不同的数据源和业务需求,基础的数据交互逻辑经常需要重复处理。
  • SQL查询结果已经返回,但转成JSON后,如何进一步用于业务流程和数据转换?

数据交互是系统集成中的常见需求。面对定时取数、动态查询、数据转换等不同场景,如何充分利用通用组件,减少重复开发?

这是一期聚焦基于JSON的通用SQL组件的实战分享,适用于医院信息平台数据同步、业务系统取数接口和通用查询等场景。

0
0 8
公告 Claire Zheng · 18 小时 前

Hi 开发者们,

投票时间到了!请浏览参赛作品,并在“InterSystems编程大赛:互操作性工作流中的 AI Agent”中投出您的一票:

🔥为您最喜爱的应用投票🔥


投票时间:2026年11月9日 - 11月15日 (美国东部时间)

如何投票?详情如下。

0
0 6
文章 cheng yu · 十一月 8 10m read

简介

我希望让医学影像的探索变得更加轻松,同时又不丢失赋予图像意义的关键信息。三维模型有助于人们理解解剖结构。如果能了解该模型的来源、其边界是如何定义的,以及***哪些部分实际上已经过检查,***该模型就会更加实用。

这正是我一直在开发的开源研究与教育项目DICOM3D 所致力于解决的问题。该项目现已公开发布;本文将从更个人的角度介绍该项目,以及我为何投身其中。

兴趣源于技术层面,而我之所以不断回归这个项目,原因则在于个人层面。

我为何开始思考这些问题

2025年11月,我的妻子接受了紧急剖宫产手术。我们的双胞胎女儿在孕30周时出生。当时我就在手术室里,站在麻醉师身旁,亲眼目睹了整个过程。

手术过程中,我妻子发生了严重大出血,在极短时间内失血量巨大。我曾一度濒临失去妻子和两个新生女儿的绝境。那段经历至今仍深深影响着我。

此外,我妻子还患有巨大的子宫肌瘤,尺寸约为10×8×9厘米,虽然在孕期已被记录在案,但并未有效告知我们。*(我无法确定这是否导致了紧急情况,也无法断言它是否解释了所有医疗决策。)*令我印象深刻的是,记录在案的信息与我们对其存在的认知之间存在着巨大鸿沟。

我自身经历的慢性疼痛、脊柱问题、就医过程以及影像检查,也让我有充足的时间站在了病历的另一端。我深知,当对涉及自身身体的信息心存疑问,**却又无从查证时,**那种感受是怎样的。我是一名开发者,而非医疗专业人士。

1
1 9
文章 John Pan · 十一月 9 9m read

在我的第一篇文章中,我介绍了“Readback”——这是我为*“互操作性工作流中的AI代理*”竞赛提交的参赛作品:这是一个AI Hub代理,可在IRIS for Health生产环境中对实验室结果进行分级处理,它可以将结果升级为“危急”级别,但绝不会将其降级,并且在有人核对数值之前,绝不会让“危急”级别的结果关闭。

本文要探讨的,是我认为比产品本身更值得深思的问题:**当一个AI代理运行在安全关键型工作流中时,究竟是哪一层在真正保障人员安全?**我对此进行了实测,结果令我大吃一惊。

测量内容

一个包含240条实验室检测结果的合成数据集(8个类别,每类30条,种子值2026),外加180条早期结果以构建患者病史。 每个案例都会完整运行整个产品流程:规则、检索、代理及其工具、组合以及发布保护。

0
0 7
文章 cheng yu · 十一月 8 6m read

在线演示:https://niutics.pl/interSystems(请使用 demo / demo 或 operator / 以获取受限角色) · GitHub:https://github.com/DawidKrynski/iris-admin-deck· Open Exchange:https://openexchange.intersystems.com/package/IRIS-Admin-Deck

视频,时长3分钟:https://youtu.be/gUsxZi-uAD4

IRIS 2026.2 版本新增了 SysAdmin REST API,即 。其 OpenAPI 文件包含 190 个路径和 273 个操作,涵盖了我通常在管理门户中进行的大部分操作。 为了参加*“构建你自己的管理门户*”竞赛,我基于此开发了 IRIS Admin Deck:这是一个由 IRIS 从 提供的单页应用,采用纯 ES 模块,无需构建步骤,也没有运行时依赖项。

1.0.1 版本已于今日发布。以下是该应用的功能介绍、我对该 API 的认识,以及其目前仍存在的不足之处。

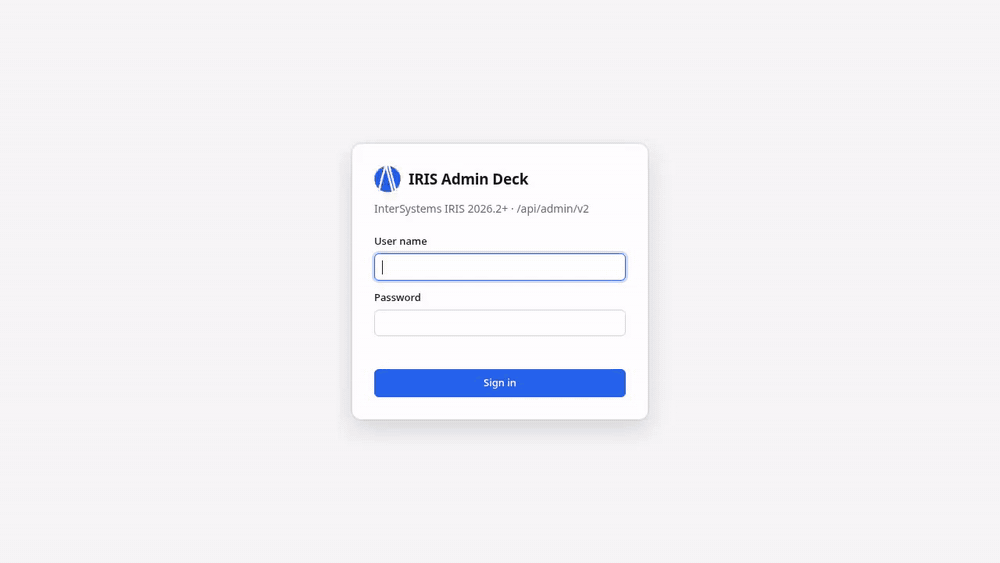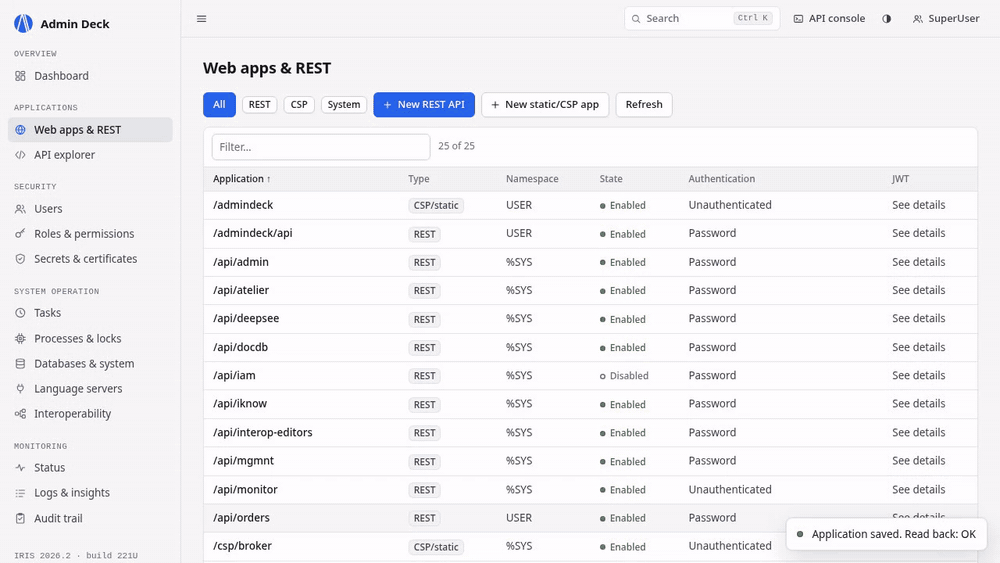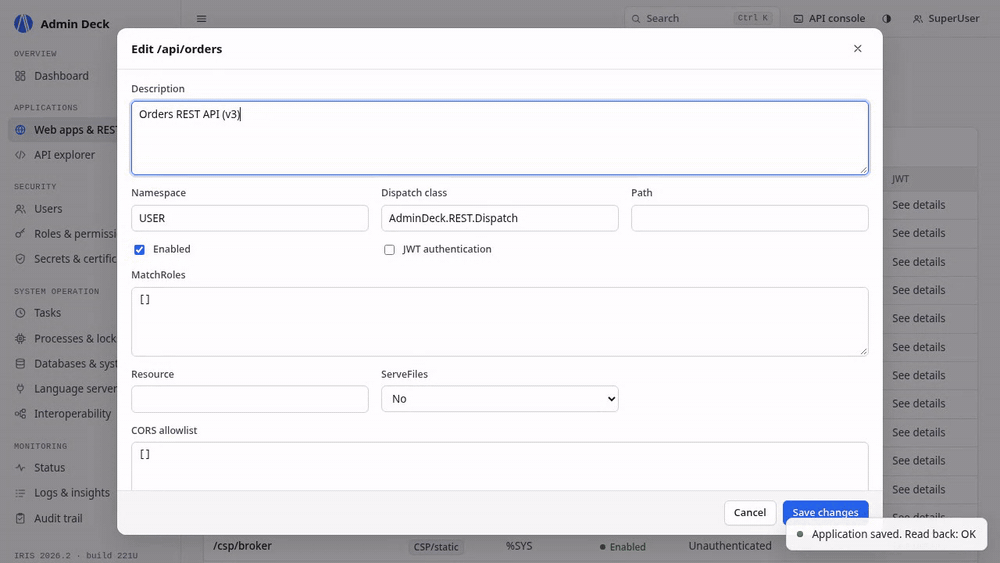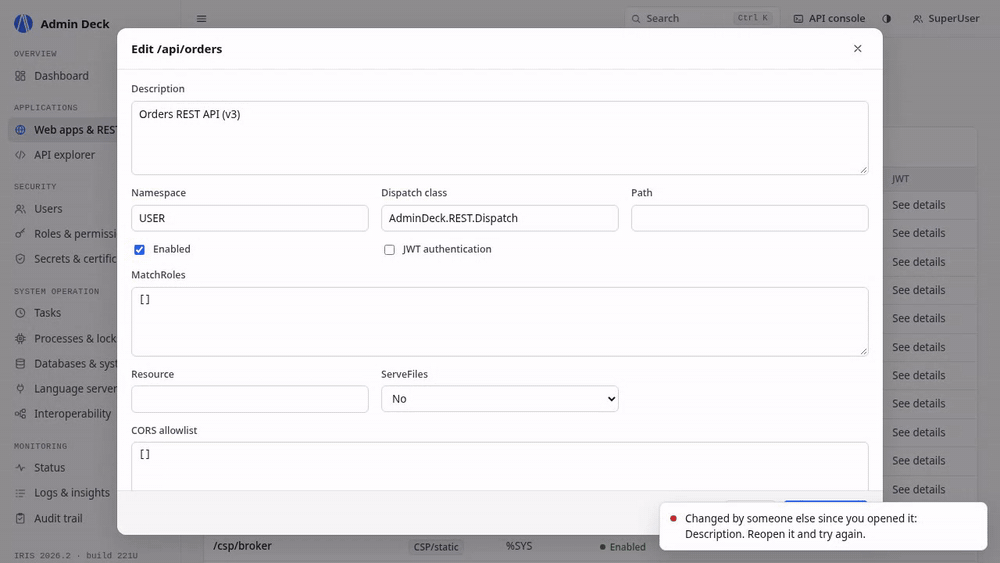
A saved edit read back, and a stale edit refused

一个值班的早晨

我开发这个工具是为了帮助那些在实例出现故障时接到通知的人。演示数据中包含一个小故障案例,您可以在在线演示中跟踪该案例:

0
0 6
文章 cheng yu · 十一月 8 3m read

PEP 578引入了 Python 审计钩子。各种事件(如模块加载、操作系统交互等)都会触发审计事件,您可以订阅这些事件。

具体操作如下。首先创建一个嵌入式 Python 钩子:

Class/// do ##class(User.Python).Audit()ClassMethod

在此示例中,我们将:

  • 如果numpy 开始 加载,则终止进程
  • 输出编译/执行事件 及其参数
  • 忽略代码事件
  • 记录所有其他事件

所有这些内容都将写入默认的 STDOUT。

要开始审计,只需调用此方法注册您的钩子即可,或者您甚至可以在任务启动时自动完成此操作:

JOBnew

以下是输出示例:

>> import json

我发现这对于调试很有帮助。

0
0 5