#Open Exchange

0 关注者 · 113 帖子

InterSystems 数据平台解决方案 Open Exchange 是一个由软件解决方案、工具和框架组成的内容库,它们使用 InterSystems 数据平台(Caché、Ensemble、HealthShare、InterSystems IRIS for Health)开发,或是旨在帮助开发、部署和支持使用 InterSystems 数据平台构建的解决方案。

您可以使用任何已发布的资产,也可以发布自己的工具、技术示例或解决方案。

探索 Open Exchange。

文章 Nicky Zhu · 十月 12 11m read

LLM 可以建议把某个源字段映射到某个目标字段。这很有用,但还不能称为完成了一次数据集成。

接下来,还需要建立连接、理解目标约束、选择并连接组件、启动管道,以及检查数据到底有没有正确到达目标。

Quickstart 介绍了运行在 InterSystems IRIS for Health 上的 DataPipelineDemo。这一篇往前走一步:解释集成需求与平台能力,如何共同变成一条可运行、可验证的数据管道。

核心并不是“让 AI 写出所有东西”,而是:

让 AI 在明确边界内做集成决策,再让这些决策能够被执行、被观察、被验证。

1. 一个系统,三个阶段

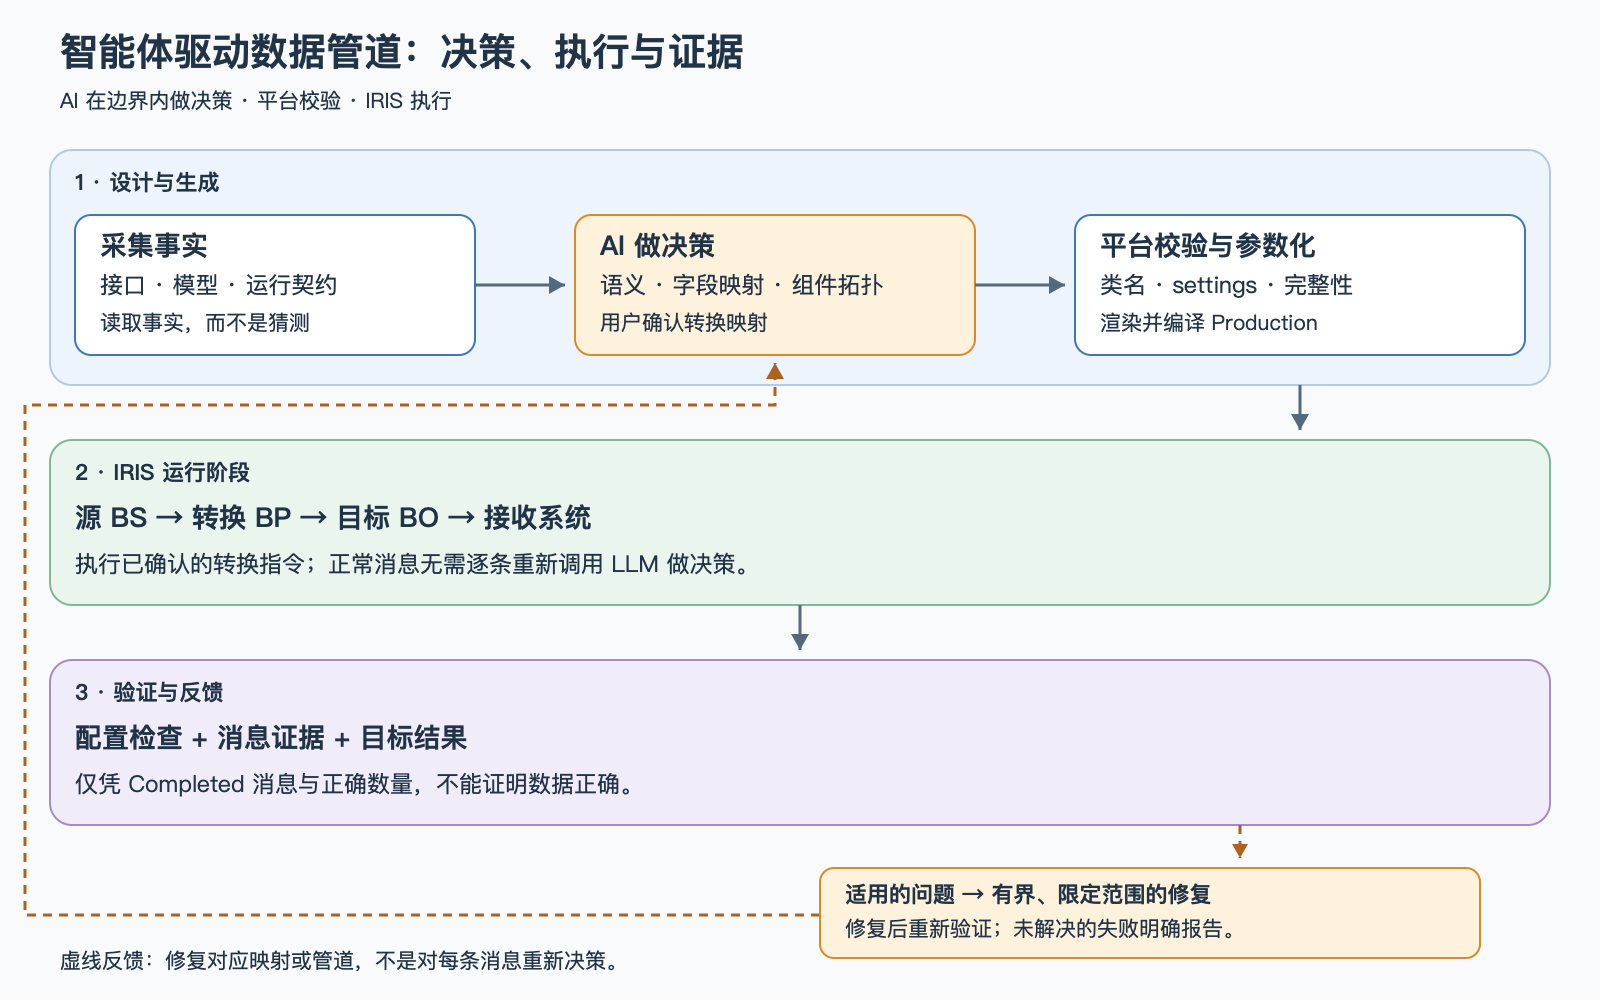
整体链路可以概括为:

设计、运行与验证反馈

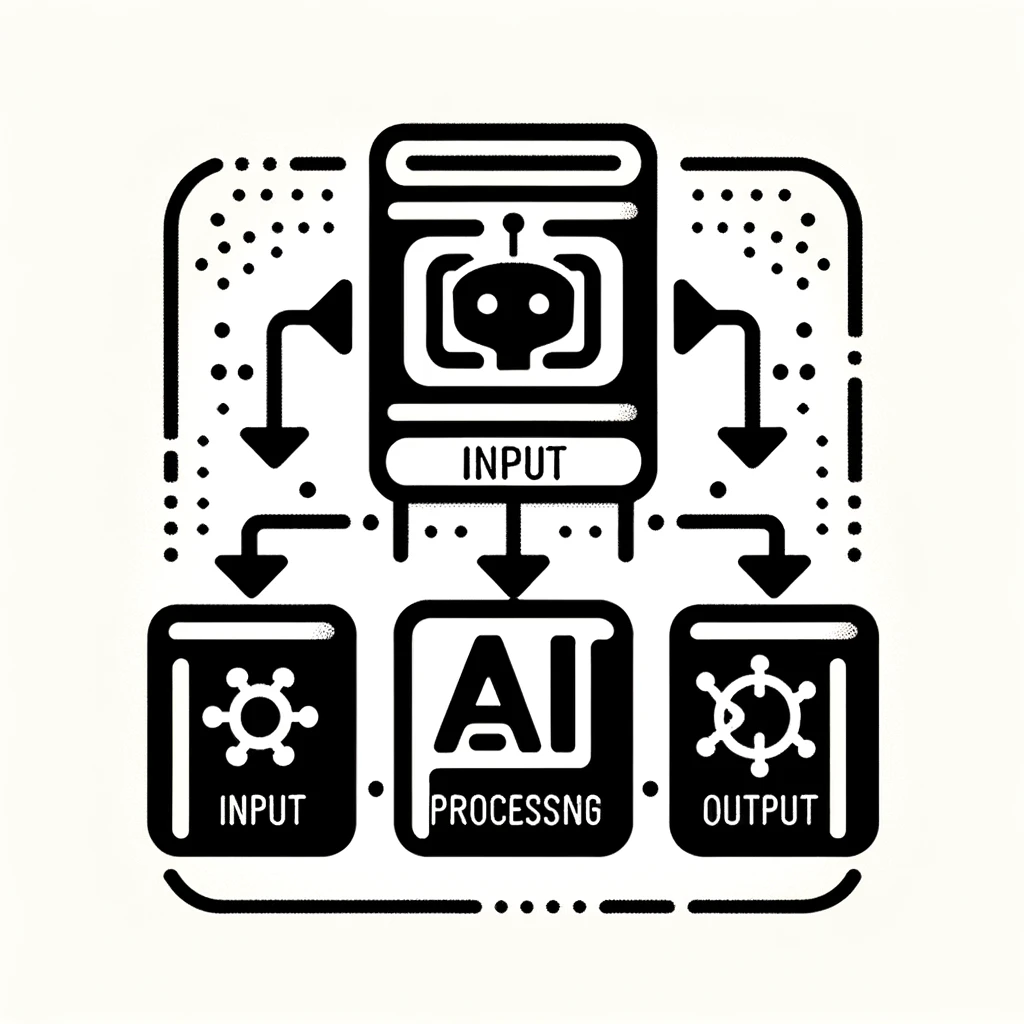
图 1:三个阶段;虚线反馈表示按适用路径做限定范围的修复,然后重新验证。

但这条链路包含三个不同的阶段。

设计与生成阶段,产出接口模型、字段映射、组件拓扑和 Production 定义。AI 参与语义分析、转换映射与管道规划。

运行阶段,源数据通过业务服务、转换流程和目标操作流转。已有组件执行确认后的转换指令,正常数据链路不会为每一行数据或每一条 FHIR 资源重新调用 LLM 做语义判断。

验证与反馈阶段,检查生成配置与运行证据;发现问题后,按适用路径修复映射或管道,再次验证。

这一区分很重要:AI 参与决策,IRIS 承担运行。例如,消息处理过程中查询术语映射,查的是术语服务器,并不是每次都让 LLM 重新判码。

2.

0
0 10
文章 Nicky Zhu · 十月 11 7m read

让 AI 接手数据集成:几分钟里跑起来

一句话速览:登记数据源、选择目标,再让 LLM 设计数据集成流程。一条命令启动演示环境,再运行一条命令,就能端到端复现完整的数据管道。

git clone --recurse-submodules https://github.com/zlnick/DataPipelineDemo.git
cd DataPipelineDemo
bash tools/setup.sh && python3 tools/e2e_ui_flow.py

↑ 一次干净克隆环境中的实测:、验证通过,数据已写入目标 FHIR 仓库。


这是什么

这是一个运行在 InterSystems IRIS for Health 上的完整演示:由数据源出发,自动生成并运行互操作性数据管道,其中的关键决策由 AI 完成。

  • 数据源(2 种):FHIR 接口、SQL 表
  • 转换目标(3 种):数据库表、SOAP 服务、FHIR 仓库
  • 支持多种源与目标组合,也支持在同一个 Production 中运行多条数据管道
  • 提供中英双语界面:默认中文,英文界面位于 /en


一套 IRIS 实例同时承担多个角色:FHIR 服务器(包含相互独立的源与目标两个仓库)、互操作性引擎(Production)、SQL 数据库,以及平台自身的元数据存储。

0
0 10
文章 Kelly Huang · 十月 11 3m read

在基于 InterSystems IRIS 数据平台开发解决方案的这些年里,我已实现了数百个与 REST API 的集成。而 IRIS 端涉及的 API 数量也不在少数!但在本文中,我想专门谈谈 REST 客户端。更确切地说,我想分享我尝试创建一个适用于所有 API 的通用客户端的经历。

0
0 12
文章 Jeff Liu · 九月 28 19m read

正在进行的选举

时间是2026年8月,巴西的大选竞选活动正在进行中。 10月4日,158,745,463名符合条件的选民将投票选举总统、各州州长、参议员、联邦众议员以及各州或联邦区众议员。总统和州长选举的第二轮投票(如有)定于10月25日举行。上述日期和选民人数数据均来自巴西最高选举法院。

在这个时间节点上,随着数百万民众试图了解候选人背景、竞选主张及公共履历,公共信息已成为当务之急。巴西虽公开了大量选举和立法数据,但这些记录仍分散在各类文件、API、标识符及政府门户网站中。

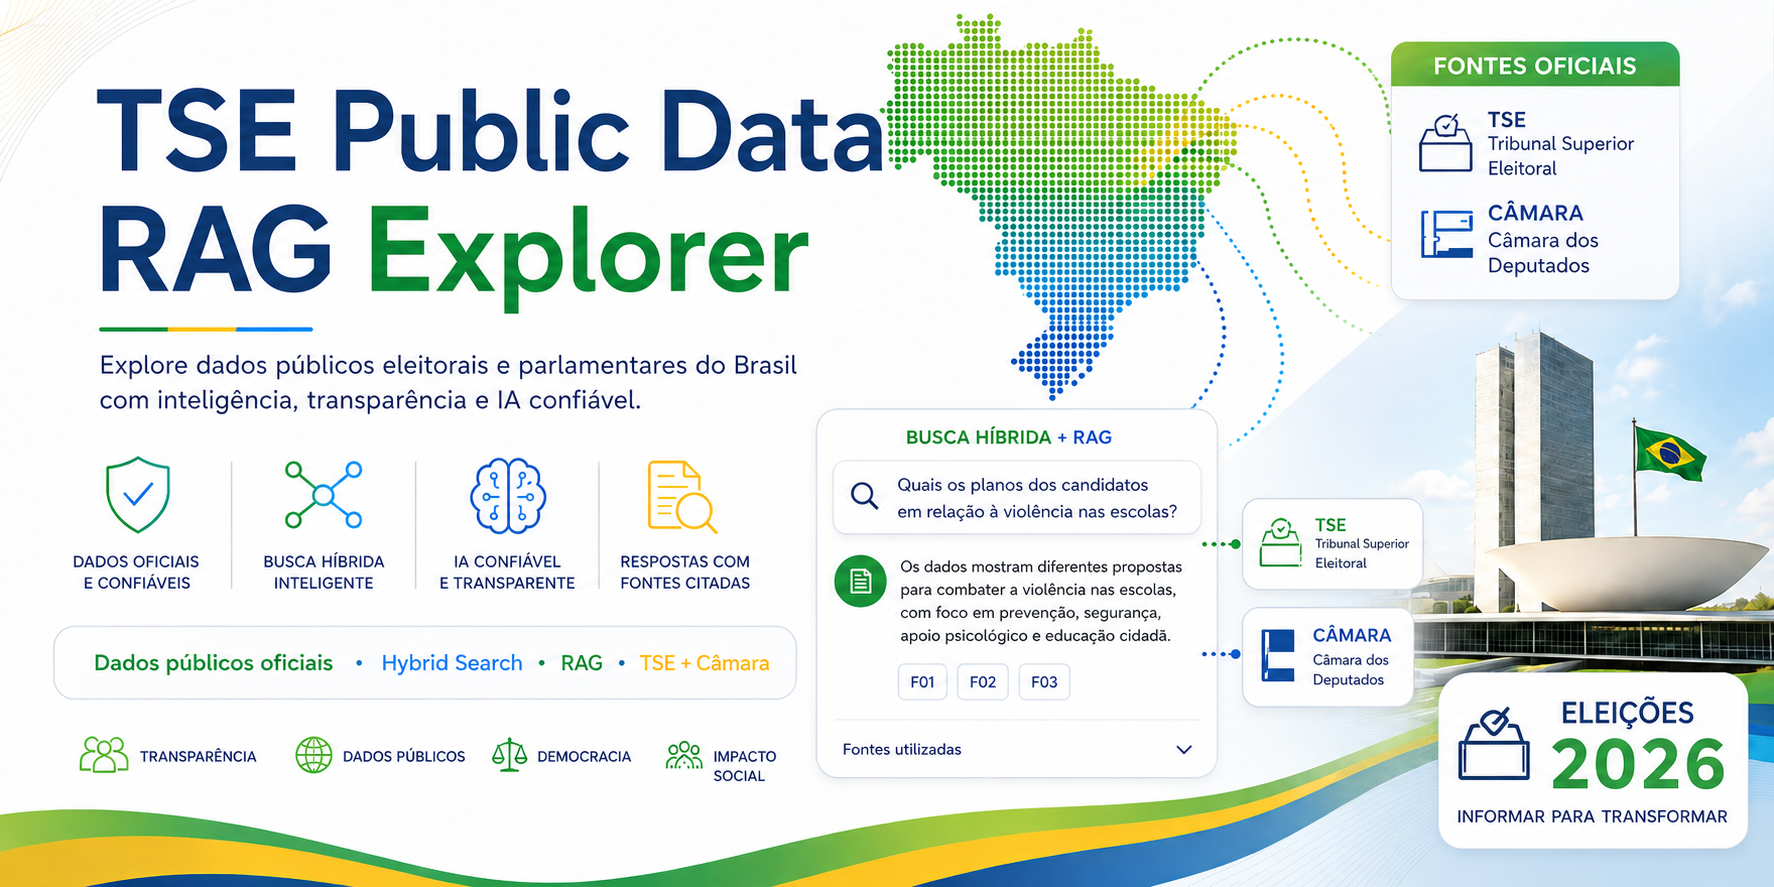
正是在这样的背景下,我们开发了“TSE公共数据RAG探索器”。

Banner do TSE Public Data RAG Explorer

开放数据丰富,但要得出答案却并非易事

一个看似简单的问题,可能需要有人先找到一个API,然后进行分页操作,下载ZIP压缩包,解码Latin-1格式的CSV文件,从PDF中提取文本,理解两个机构的标识符,在它们之间建立个人关联,最后阅读冗长的文档。

主要障碍在于数据访问:定位、关联并解读通过不同来源发布的记录。

该项目始于一个问题:

在选举年,我们如何将关于候选人和当选官员的海量公共数据转化为任何公民都能探索的信息?

该解决方案在孤立的过滤器以及语言模型的内部记忆之外,增添了一层基于证据的研究层。在敏感领域,可检索的证据是每个流畅回答的必要条件。

基于官方证据的自然语言处理层

TSE 公共数据 RAG 探索器与其说是一个选举聊天机器人,不如说是一个公共数据智能平台。

0
0 29
文章 Jeff Liu · 八月 25 5m read

大约25年前,我曾在当地一所顶尖的高科技职业学校/学院担任讲师。👨‍🏫

我曾教授多门课程,包括“C语言入门”以及“C语言进阶”。我承认,从那以后我几乎没怎么碰过C语言,接触得也相当少。 

自然,我大量使用ObjectScript,也接触过其他语言,比如SQL(包括一些厂商专有的变体)、Java和C#,最近还用了不少Python,而在前端开发中则主要使用各种基于JavaScript的框架。

但 C 语言呢?或许在过去一年里,我曾稍微帮过女儿一点忙——当时她正在大学攻读计算机科学专业的大一,我指导她处理指针、内存分配与释放等内容,但也就仅此而已。

就在这时,首届InterSystems员工编程挑战赛来了——任务是处理欧洲航天局(ESA)GAIA项目的数据🛰️,而对于“基准测试”这一赛项,我知道自己将不得不重新温习C语言的知识和经验……

0
0 60
文章 Jeff Liu · 八月 16 6m read

大家好,

我在 IRIS for Health 上构建了一个小型临床 AI FHIR 代理网络,想和大家分享让它正常运行的关键组件。

本文将涵盖以下内容:

  • 基于代理的AI技术栈
  • 代理路由逻辑
  • FHIR 读写访问(工具)
  • 带备用方案的 RAG 加载
  • 肿瘤学智能体:从配置到检测结果
  • 双智能体路由示例
0
0 96
文章 Lilian Huang · 七月 27 2m read

动机

为什么我们需要这个?

  1. 缺乏编译后上下文:AI 工具只能看到源代码;它们不知道最终编译后的例程是什么样子的。

  2. 宏幻觉:由于 AI 无法看到我们的 #include 文件或系统宏,它常常会凭空编造这些内容,从而在调试过程中浪费时间。

  3. 文档缺口:深度逻辑优化通常需要理解内部宏,而公开文档中并未对此进行全面说明。

  4. 手动开销:目前,解决此问题的唯一方法是手动使用 IRIS VS Code 扩展来查找例程中的“真实情况”。

解决方案:这款 MCP 服务器为我们的 AI 提供了窥探 IRIS 实例内部的“眼睛”,使其能在向您建议代码之前自动读取例程并展开宏。

快速入门

请使用 ObjectScript 项目apiPub 试用此 MCP 服务器。

获取 api.cls 的例程:
alt text

按 ctrl+shift+v 查看编译后的例程。在编译器术语中,这被称为可读中间代码。大型语言模型(LLMs)缺乏这种上下文——这就是为什么即使是前沿模型也会“发明”宏,因为它们不知道展开后的代码是什么样子的。

它们也不知道哪些 .inc 文件被导入了,也不知道其中 $$$xxx 宏展开后会变成什么样。

例如,一个 .inc 文件可能会显式包含系统宏:

如果您已连接到 IRIS 实例,则可以直接导航到这些宏文件:

如果不显式包含这些系统宏,就无法访问这些文件——而 LLM 对此完全无法察觉。

在 文件夹下,向 mcp.json

0
0 54
文章 Lilian Huang · 七月 26 12m read
  1. 引言

流行病学监测是公共卫生的基石之一。 Régis Júnior等人(2026)将其定义为一个针对健康事件的持续性数据收集、分析、解读和传播系统——该功能的有效性在很大程度上取决于信息系统的质量、数据分析能力以及不同医疗层级之间的协调。 在新冠疫情期间,这一职能的战略重要性已毋庸置疑:世界卫生组织(2021)的记录显示,拥有更健全监测系统的国家始终表现得更好,而监测能力方面的区域差异则直接导致了应对措施的不一致,并在发病率和死亡率方面产生了可测量的差异。

尽管医疗系统如今能够收集海量的标准化临床数据,但挑战在于如何将这些数据转化为及时且可付诸行动的洞见。传统的流行病学报告往往依赖于人工分析和定制数据库查询,由此产生的延迟可能会阻碍公共卫生部门的快速响应。

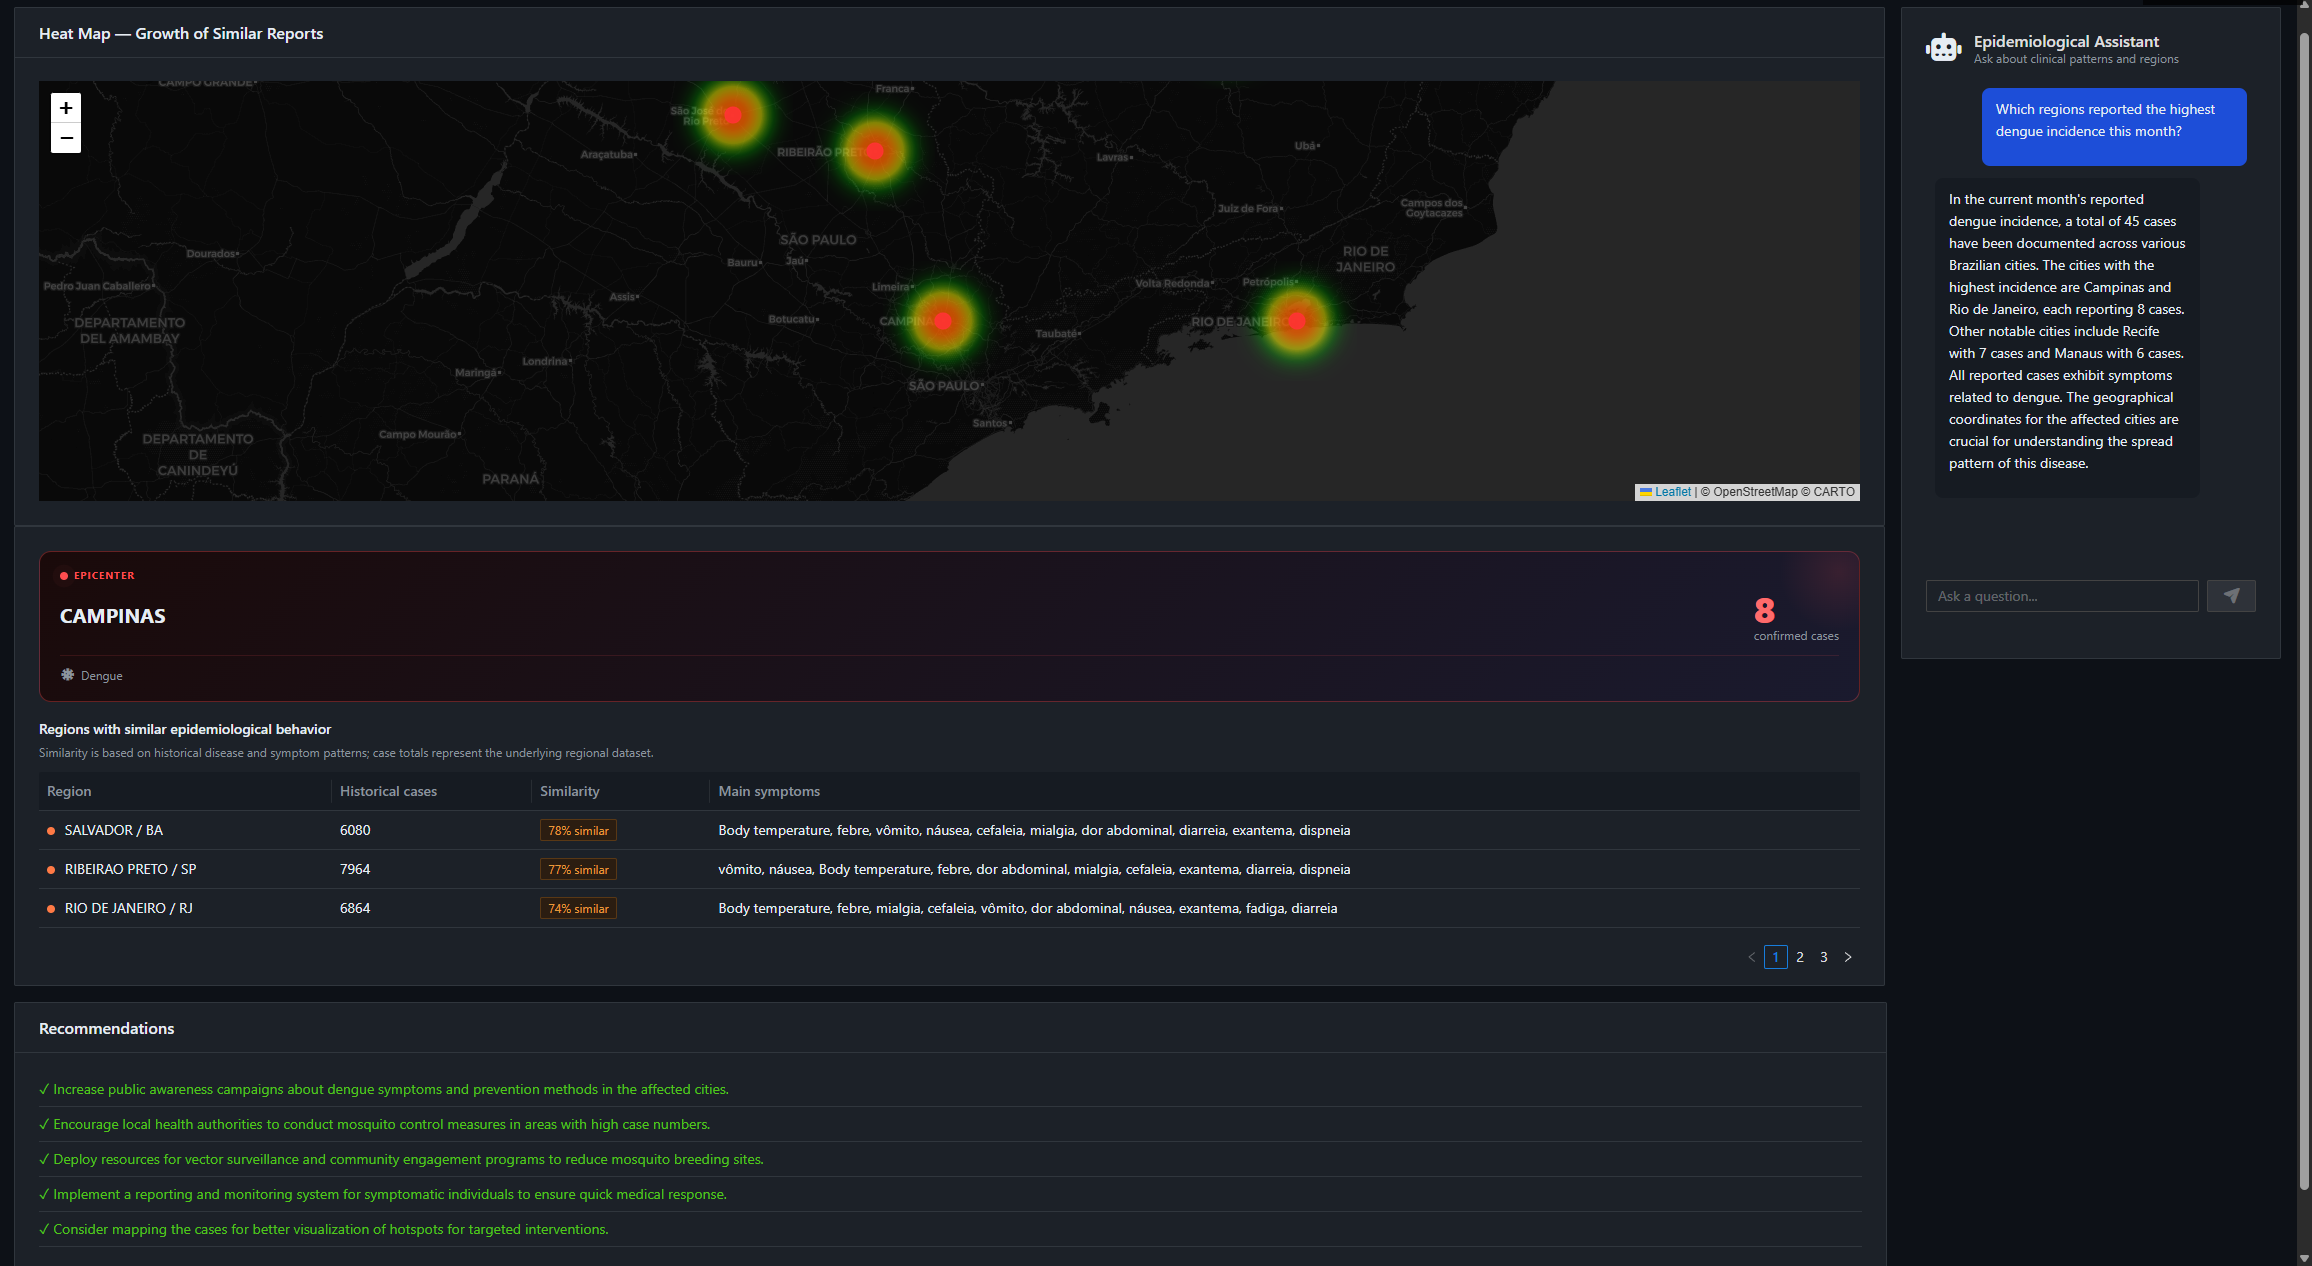
EpInsights通过整合 InterSystems IRIS for Health、嵌入式 Python 临床向量化技术、IRIS Vector Search 以及 LangChain4j 对话式智能助手,填补了这一空白。 该平台使流行病学家和卫生管理者能够提出自然语言问题,并即时获得基于真实FHIR数据的地理空间热力图、区域排名、相似聚类检测以及AI生成的建议,所有结果均在数秒内呈现。


  •  
  1. 架构概述

EpInsights 采用三层架构,各层职责划分明确。

0
0 64
文章 Kelly Huang · 七月 19 2m read

要成功构建和部署人工智能代理以应对医疗保健领域的各种用例,关键在于高质量的数据和API,以及有效的治理与管理。 InterSystems IRIS FHIR 服务器不仅能满足上述所有需求,还精通 Python、向量搜索和互操作性。结合强大的大型语言模型(LLM),患者、医生、护理人员和管理者将能够利用最先进的技术来改善个人健康和公共卫生。

本文利用 InterSystems IRIS FHIR 存储库、FHIR API、嵌入式 Python 以及向量搜索作为数据服务和 API,从而使部署在 Ollama 上的 LLM lhama3 能够处理以下用例:临床摘要、 通过API使用自然语言探索FHIR数据、AI生成的患者临床指标图形分析,以及利用向量搜索进行病例相似性比较等用例。

安装

1. 访问 Open Exchange 并查找应用程序 fhir assistant(https://openexchange.intersystems.com/package/fhir-assistant)

2. 将代码库克隆/通过 Git 拉取到任意本地目录:

$ git clone https://github.com/yurimarx/fhir-assistant.git

3.

0
0 65
文章 Nicky Zhu · 七月 15 4m read

项目链接

概述

FHIR 患者快照代理(FHIR Patient Snapshot Agent)是一款专为 InterSystems AI 代理和 FHIR 编程竞赛开发的小型开源应用程序。

该项目实现了建议的“智能患者摘要生成器”构想:它检索所选患者的结构化 FHIR 资源,并生成一份简明扼要、针对特定角色的患者摘要。

其目的并非进行诊断或推荐治疗方案。该代理仅作为摘要生成助手,所有生成的内容都必须与源FHIR数据进行核对验证。

InterSystems IRIS for Health 的应用方式

该应用程序使用 InterSystems IRIS for Health 作为 FHIR 互操作性层。

在本地部署环境中,IRIS for Health 提供了一个 FHIR R4 API。Python 应用程序通过查询该 API 来获取与患者相关的资源,包括:

  • 患者
  • 病情
  • 用药请求
  • 过敏与不耐受
  • 观察
  • 就诊
  • 护理计划

该 Python 应用程序不会直接读取本地临床文件。

0
0 87
文章 Kelly Huang · 七月 12 20m read

在问诊前,人工智能助手会先阅读FHIR患者病历,根据已掌握的信息提出恰当的问题,识别关键的警示信号,并将分析结果反馈给医生——这样医生就能做好充分准备。

该项目灵感源自InterSystems编程大赛“FHIR人工智能代理”中建议的第10项任务(对话式FHIR分诊助手)。


解决的医疗痛点

在患者走进诊室之前,一个关键的疏漏已经发生:没有人阅读过他们的病史。医生只有15分钟的时间。患者不得不第三次向医生重复自己的病情、用药情况和过敏史——这已经是今年第三次了。 诸如华法林治疗期间的出血、心力衰竭伴随的胸痛、抑郁症伴随的自杀意念等“危险信号”,要么直到为时已晚才被询问,要么根本未被提及。

这并非技术上的缺口。 数据是存在的。它们存储在分布于不同系统中的数据仓库中,其中包含患者的纵向病历,涵盖病情、用药情况、实验室检查结果、过敏史及就诊史。真正的缺口在于诊疗现场的智能辅助——一个能在就诊前阅读病历、根据已知信息提出恰当问题,并将分析结果反馈给医生,使医生做好充分准备的智能助手。

在技术示例应用TriageAide中,我们以具体场景为切入点,探索如何将 InterSystems IRIS FHIR 服务器、模型上下文协议(MCP)和生成式人工智能(Generative AI)结合使用。该应用是一款人工智能助手,旨在优化患者接诊流程和临床交接工作。

0
0 107
文章 Lilian Huang · 七月 10 8m read

大多数“AI 代理 + FHIR”项目最终都呈现出相同的架构:这边是一个 FHIR 服务器,那边是一个向量数据库,中间则是一个 Python 服务,其职责是调用嵌入 API、在两端之间转换浮点数数组,并保持两个数据存储库的同步。 三个活动组件、两次网络跳转,以及一个你从此永久拥有的嵌入式客户端。

Triage Park:我们 提交给InterSystems 编程大赛:FHIR AI Agent的参赛作品,完全没有这些复杂结构。该代理从不计算嵌入向量,也从未导入过 OpenAI 嵌入向量客户端。 没有向量数据库。它将原始文本发送给 IRIS,剩下的工作由 IRIS 完成:它在服务器端计算嵌入向量,并通过针对与 FHIR 存储库位于同一数据库*中的表执行单条 VECTOR_COSINE SQL 语句来响应检索请求。

这就是 IRIS for Health 的“AI Hub”模式,一旦我采用该模式,我自己的代码中整整一层就消失了。以下是它的具体工作原理。

问题在于:分诊人员需要快速获得指导方针

Triage Park 是一款对话式分诊助手。患者描述症状(“我上楼梯时胸口发紧”),由大型语言模型(LLM)支持的助手会读取患者的真实 FHIR 病历,并生成分诊决策:自我护理 / 看全科医生 / 急诊护理 / 急诊科,同时附上依据说明。

“引用依据”(Cited rationale)是关键所在。

0
0 85
文章 Kelly Huang · 七月 9 5m read

在开始开发“智能出院导航器(Smart Discharge Navigator)”时,我遇到了一个常见的难题:FHIR 数据以 JSON 数据包的形式存储,但我所需的分析需要将多个资源进行关联,而这正是 SQL 所擅长的领域。

InterSystems FHIR SQL Builder 彻底解决了这一问题。我无需在应用程序代码中解析 JSON 数据包,而是能够直接在 IRIS for Health 中针对 FHIR 资源投影编写纯 SQL 语句。本文将详细介绍我如何利用该工具构建了该应用程序核心——基于人群的再入院风险评分引擎。


临床问题

30 天内的医院再入院是医疗保健领域成本最高且本可预防的问题之一,每年给美国医疗系统造成 170 亿美元的损失。挑战并不在于事后识别风险因素,而在于在恰当的时机——即患者出院前——及时发现这些风险因素。

为了评估再入院风险,我需要针对每位患者同时回答以下五个问题:

  • 该患者近期住院过几次?
  • 该患者是否患有多种活动性慢性病?
  • 该患者目前是否正在服用五种或更多种药物(多药联用)?
  • 病历中是否有任何异常实验室检查结果?
  • 是否有缺席随访的情况?

如果通过 Python 解析 FHIR 数据包来回答这五个问题,不仅速度慢,而且容易出错。而 FHIR SQL Builder 则让这一切变得简单明了。


0
0 141
文章 Claire Zheng · 四月 20 4m read

大家好。又是我!!😀

最近,我试图整理InterSystems IRIS😆的一些学习材料,并意识到这些资源实际上非常分散。

因此,我在这里列出了一个按类别分组的列表,供以下人员使用:

  • 是 InterSystems 的新手
  • 或想深入了解某个特定领域的人

此外,我还补充了一些自己的经验,说明哪些有用(哪些没用,可能只是对我没用🤫🤐)。


1.对于初学者

如果您不知道从哪里开始,请从这里开始:

我的体验 从 Developer Hub + 入门开始效果很好。它提供了快速运行的足够条件(无需安装,直接测试!!!!ᾒ)。

不适合我的地方 一开始就直接进入文档→正如我常说的...我知道句子中的每个单词,但就是不理解🥲。


2.设置/安装/工具

当你想真正开始工作时:

0
0 412
文章 Lilian Huang · 十二月 11, 2025 2m read

在当今的医疗数据领域,FHIR 已成为结构化临床数据交换的标准。然而,虽然 FHIR 擅长互操作性,但其 JSON 格式却给分析带来了挑战——包括FHIR QuestionnaireResponse数据。

本项目演示了如何将 FHIR QuestionnaireResponse 数据从嵌套 JSON 转换为关系 SQL 表和向量嵌入。通过集成 InterSystemsIRIS FHIR SQL 生成器和向量搜索,我们揭开了患者回答背后的语义。

构建的三个步骤

1.设计和收集问卷

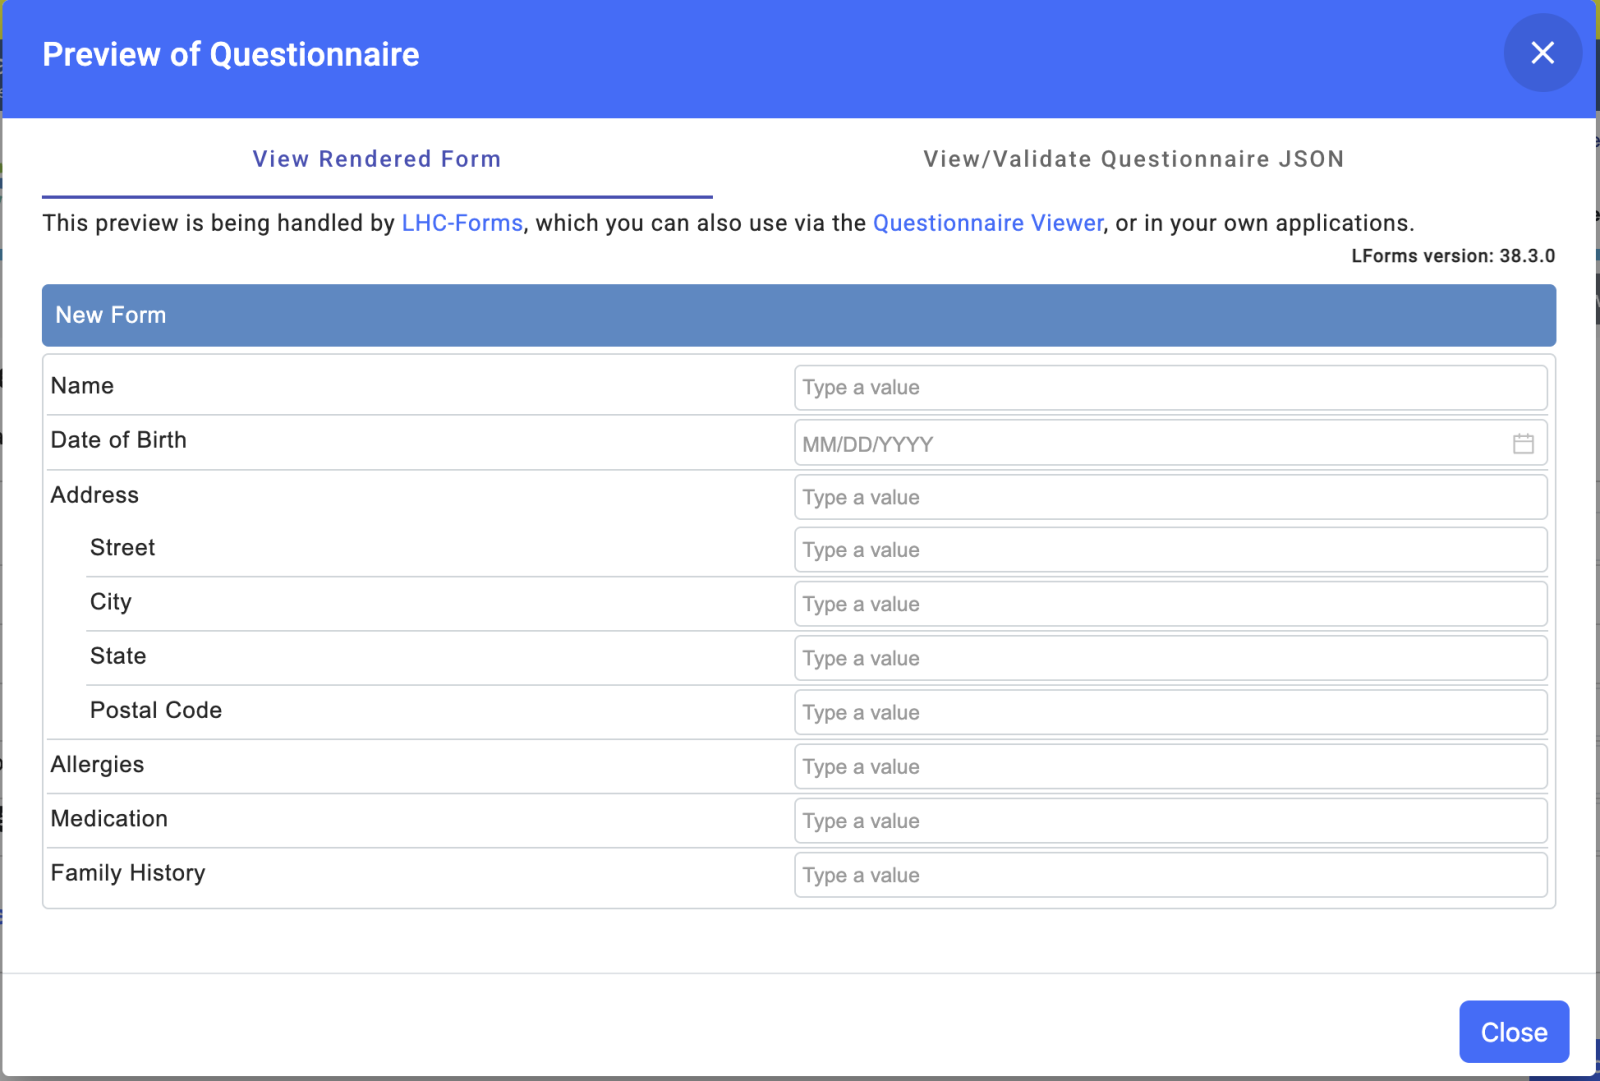
首先使用 美国国家医学图书馆(NLM)表格生成器。该工具有助于设计符合 FHIR 标准的结构化临床表格。在本项目中,收集了 100 份合成患者回复,并将其保存为 FHIR QuestionnaireResponse JSON 文件,准备导入 FHIR 服务器。

2.通过 SQL 转换和查询问卷数据

将 FHIR QuestionnaireResponse 资源加载到服务器后,使用InterSystems IRIS FHIR SQL 生成器自动创建关系 SQL 表。这将使嵌套的 JSON 结构扁平化,从而能够使用标准 SQL 轻松分析问卷数据——所有配置只需点击几下即可完成。

  • 有关 FHIR SQL 生成器的完整配置,请参阅README。
0
0 354
文章 Nicky Zhu · 十月 28, 2025 9m read

技术文档 — Quarkus IRIS Monitor System

1. 目的与范围

此模块支持在基于 Quarkus 的 Java 应用程序与 InterSystems IRIS 的原生性能监控功能之间进行集成。
它使开发者可以通过 @PerfmonReport 对方法添加注释,这样可以在执行方法时自动触发 IRIS 的 ^PERFMON 例程,以生成性能报告,而无需人工干预。


2. 系统组件

2.1 注释:@PerfmonReport

  • 定义为 CDI InterceptorBinding。
  • 可应用于方法或类。
  • 指示使用 IRIS 监控逻辑包装方法执行的框架。

2.2 拦截器:PerfmonReportInterceptor

  • 拦截对带注释的方法的调用。

  • 执行流程:

    1. 记录启动事件 (LOG.infof("INIT: …"))
    2. 调用 monitorSystem.startPerfmon()
    3. 继续执行 context.proceed()
    4. 在 finally 块中:
      • 调用 monitorSystem.generateReportPerfmon(...)
      • 调用 monitorSystem.stopPerfmon()
      • 记录结束事件及执行时间
  • 确保即使抛出异常,监控也始终结束。

0
0 134
文章 Lilian Huang · 四月 16, 2025 7m read

Hi 大家好
在本文中,我讲介绍我的应用 iris-AgenticAI .

代理式人工智能的兴起标志着人工智能与世界互动方式的变革性飞跃--从静态响应转变为动态、目标驱动的问题解决方式。参看 OpenAI’s Agentic SDK ,  OpenAI Agents SDK使您能够在一个轻量级、易用且抽象程度极低的软件包中构建代理人工智能应用程序。它是我们之前的代理实验 Swarm 的生产就绪升级版。

该应用展示了下一代自主人工智能系统,这些系统能够进行推理、协作,并以类似人类的适应能力执行复杂任务。

应用功能

  • Agent Loop 🔄 一个内置循环,可自主管理工具的执行,将结果发回 LLM,并迭代直至任务完成。
  • Python-First 🐍 利用本地 Python 语法(装饰器、生成器等)来协调和连锁代理,而无需外部 DSL。
  • Handoffs 🤝 通过在专业代理之间委派任务,无缝协调多代理工作流程。
  • Function Tools ⚒️ 用 @tool 修饰任何 Python 函数,可立即将其集成到代理的工具包中。
  • Vector Search (RAG) 🧠 原生集成向量存储(IRIS),用于 RAG 检索。
  • Tracing 🔍 内置跟踪功能,可实时可视化、调试和监控代理工作流(想想 LangSmith 的替代方案)。
  • MCP Servers 🌐 通过 stdio 和 HTTP 支持模型上下文协议(MCP),实现跨进程代理通信。
  • Chainlit UI 🖥️ 集成 Chainlit 框架,可使用最少的代码构建交互式聊天界面。
  • Stateful Memory 🧠 跨会话保存聊天历史、上下文和代理状态,以实现连续性和长期任务。
0
0 354
文章 Lilian Huang · 四月 10, 2025 6m read

社区朋友们好,

传统的基于关键词的搜索方式在处理具有细微差别的领域特定查询时往往力不从心。而向量搜索则通过语义理解能力,使AI智能体能够根据上下文(而非仅凭关键词)来检索信息并生成响应。

本文将通过逐步指导,带您创建一个具备代理能力的AI RAG(检索增强生成)应用程序。

实现步骤:

  1. 添加文档摄取功能:
    • 自动获取并建立文档索引(例如《InterSystems IRIS 2025.1版本说明》)
    • 实现向量搜索功能
  2. 构建向量搜索智能体
  3. 移交至主智能体(分流处理)
  4. 运行智能体

1. Create Agent Tools 添加文档摄取功能

Implement Document Ingestion: Automated ingestion and indexing of documents 


1.1 - 以下是实现文档摄取工具的代码:

    def ingestDoc(self):
        #Check if document is defined, by selecting from table
        #If not defined then INGEST document, Otherwise back
        embeddings = OpenAIEmbeddings()	
        #Load the document based on the fle type
        loader = TextLoader("/irisdev/app/docs/IRIS2025-1-Release-Notes.txt", encoding='utf-8')      
        
        documents = loader.load()        
        text_splitter = RecursiveCharacterTextSplitter(chunk_size=400, chunk_overlap=0)
        
        texts = text_splitter.split_documents(documents)
                       
        #COLLECTION_NAME = "rag_document"
        db = IRISVector.from_documents(
            embedding=embeddings,
            documents=texts,
            collection_name = self.COLLECTION_NAME,
            connection_string=self.CONNECTION_STRING,
        )

        db = IRISVector.from_documents(embedding=embeddings,documents=texts, collection_name = self.COLLECTION_NAME, connection_string=self.CONNECTION_STRING,)

向量搜索智能体(Vector Search Agent)能够自动完成文档的摄取(ingest)与索引构建(index), 该新功能在InterSystems IRIS 2025.1的数据资源文件夹里) 至 IRIS 向量存储, 只有当数据尚未存在时,才执行该操作。


运行以下查询以从向量存储中获取所需数据:

SELECT
id, embedding, document, metadata
FROM SQLUser.AgenticAIRAG


1.2 - 实现向量搜索功能


以下代码为智能体提供了搜索能力:

 def ragSearch(self,prompt):
        #Check if collections are defined or ingested done.
        # if not then call ingest method
        embeddings = OpenAIEmbeddings()	
        db2 = IRISVector (
            embedding_function=embeddings,    
            collection_name=self.COLLECTION_NAME,
            connection_string=self.CONNECTION_STRING,
        )
        docs_with_score = db2.similarity_search_with_score(prompt)
        relevant_docs = ["".join(str(doc.page_content)) + " " for doc, _ in docs_with_score]
        
        #Generate Template
        template = f"""
        Prompt: {prompt}
        Relevant Docuemnts: {relevant_docs}
        """
        return template


分流代理处理传入的用户查询,并将其委托给矢量搜索代理,后者执行语义搜索操作,以检索最相关的信息。
0
0 271
InterSystems 官方 Michael Lei · 一月 7, 2025

我们已经有一段时间没有在开发者社区上发表关于嵌入式 Git 的文章了,我想借此机会更新一下今年我们完成的大量工作以及未来的工作计划。

背景信息

如果您要在 IRIS 上构建解决方案,并想要使用 Git,那就太棒了! 只需将 VSCode 与本地 Git 仓库结合使用,并将更改推送到服务器上即可,就是这么简单。

但在以下使用场景中该怎么办:

  • 您与其他开发者在共享的远程开发环境中合作,并想要避免因同时编辑同一文件而影响彼此的工作
  • 您使用位于管理门户中的编辑器来实现互操作性或业务智能,并希望对您的工作直接进行源代码控制,即使在本地容器中也希望如此
  • 您仍在使用 Studio 处理一些任务并且/或偶尔会再次从 VSCode 跳转回 Studio;或者您的团队还没有完全接受 VSCode,一些团队成员仍想使用 Studio,而其他人在使用 VSCode
  • 您同时在同一命名空间中处理多个独立的项目,例如使用 InterSystems Package Manager 定义的多个软件包,并想仅通过一个 isfs 编辑视图使用所有软件包(而不是在多个单独的项目中使用),同时在合适的本地 git 仓库中自动跟踪更改

在以上任何情况下,您都非常需要嵌入式源代码控制。

0
0 381
文章 Louis Lu · 一月 26, 2022 2m read

许多使用InterSystems IRIS的用户在调试代码的时候习惯使用命令行的方式,比如运行一个函数查看输出或者查看代码运行过程中保存在global中的数据等等。

对于将 InterSystems IRIS 安装在 Windows 操作系统的用户,只需要点击右下角图标选择Terminal 就可以很方便的使用。

但是对于将其安装到 Linux 或者Docker 容器中的用户,要使用命令行却不那么方便,下面我将会介绍在我们 Openexchange 中的一个应用 -- Web Terminal。

也就是说可以在网页中直接执行Terminal中的命令。

2016-09-18_212035

或者查看SQL执行结果:

可以在其中输入 /help ,获取更多帮助信息

安装

1. 点击进入项目下载页面,选择下载最新的版本。

2. 在任意的命名空间下导入下载的xml文件。

注意在这里选择导入文件的同时也要勾选上 “编译导入的项”

3. 之后会出现下面提示导入成功的提示

如果出现类似于下面的错误提示:

请将下载的 WebTerminal-v4.9.3.xml 文件编辑做下面修改

1 . 第1611行:修改为 

set requiredRole = "%DB_IRISSYS"

2. 第1730行:修改为

set dbPrefix = "IRIS"

重新导入就可以了。

3
0 514
文章 Michael Lei · 八月 6, 2024 5m read

数据收集

这篇分步说明指南将讲解如何创建任务来收集 InterSystems 数据库及其全局变量的相关数据(如关联的 Open Exchange App 所示,其中包含所有相关代码)

免责声明:此软件仅用于测试/演示目的。 InterSystems 不支持将此代码作为任何发布产品的一部分。 它由 InterSystems 提供,作为特定产品和版本的演示/测试工具。 用户或客户全权负责此软件交付后的维护和测试,InterSystems 对此代码的错误或误用不承担任何责任。

  1. 首先,通过管理门户导入文件“DataCollection.xml”,并确保没有错误。 如果存在错误,则可能是版本问题,请发送电子邮件至 ari.glikman@intersystems.com 联系 Ari Glikman 获取适合你的版本的支持。 另外,确保将数据导入到你想要收集其内部数据以供后续检查的命名空间中。

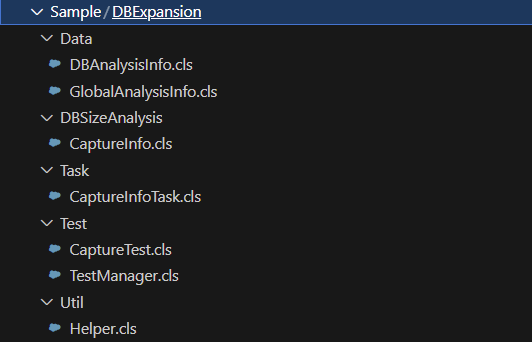
  2. 导入完成后,应该看到 Sample 软件包以及几个子软件包 image

如果服务器上已经存在 Sample 软件包,那么你仍然应该可以看到新的子软件包以及先前存在的其他文件夹。

  1. 现在,运行单元测试以确保一切正常运行。

a. 创建可以被 InterSystems Terminal 读取的名为 Unit Tests 的文件夹,例如,由于我有一个本地安装,我需要在 C 盘中创建一个文件夹。

b.

3
0 249
文章 Michael Lei · 四月 9, 2024 7m read

人工智能不仅限于通过带有说明的文本生成图像,或通过简单的指示创建叙事。
您还可以制作图片的变体,或为已有图片添加特殊背景。
此外,您还可以获得音频转录,无论其语言和说话者的语速如何。
让我们来分析一下文件管理是如何工作的。

0
0 263
文章 Lilian Huang · 三月 14, 2024 6m read

人工智能(AI)最近受到广泛关注,因为它可以改变我们生活的许多领域。更好的计算机能力和更多数据帮助人工智能完成了许多惊人的事情,例如改进医学测试和制造自动驾驶汽车。人工智能还可以帮助企业做出更好的决策,提高工作效率,这也是人工智能越来越流行和广泛应用的原因。如何将 OpenAI API 调用集成到现有的 IRIS 互操作性应用程序中?

0
0 371
文章 Claire Zheng · 一月 17, 2024 1m read

第一步

您需要在Open Exchange中提交并发布您的应用。

第二步

通过您的个人主页/Open Exchange页面进入您个人的开发者页面

在这里您可以找到自己提交成功的全部应用

第三步

您可以通过以下几个方式参赛:

方式一

访问编程大赛页面,点击申请按钮,选择您想要提交的App进行提交。

方式二

在您的App页面查看可参加的比赛进行提交 
 

方式三

找到您的所有的App,找到想投赛的App,按下图所示进行申请

如果您有更多疑问,欢迎留言提问,或者访问此链接进行了解。

0
0 706