#InterSystems IRIS for Health

0 关注者 · 1K 帖子

InterSystems IRIS for Health™ 是全球第一个也是唯一一个专门为医疗应用程序的快速开发而设计的数据平台,用于管理全世界最重要的数据。它包括强大的开箱即用的功能:事务处理和分析、可扩展的医疗保健数据模型、基于 FHIR 的解决方案开发、对医疗保健互操作性标准的支持等等。所有这些将使开发者能够快速实现价值并构建具有突破性的应用程序。了解更多信息。

文章 cheng yu · 十一月 8 10m read

简介

我希望让医学影像的探索变得更加轻松,同时又不丢失赋予图像意义的关键信息。三维模型有助于人们理解解剖结构。如果能了解该模型的来源、其边界是如何定义的,以及***哪些部分实际上已经过检查,***该模型就会更加实用。

这正是我一直在开发的开源研究与教育项目DICOM3D 所致力于解决的问题。该项目现已公开发布;本文将从更个人的角度介绍该项目,以及我为何投身其中。

兴趣源于技术层面,而我之所以不断回归这个项目,原因则在于个人层面。

我为何开始思考这些问题

2025年11月,我的妻子接受了紧急剖宫产手术。我们的双胞胎女儿在孕30周时出生。当时我就在手术室里,站在麻醉师身旁,亲眼目睹了整个过程。

手术过程中,我妻子发生了严重大出血,在极短时间内失血量巨大。我曾一度濒临失去妻子和两个新生女儿的绝境。那段经历至今仍深深影响着我。

此外,我妻子还患有巨大的子宫肌瘤,尺寸约为10×8×9厘米,虽然在孕期已被记录在案,但并未有效告知我们。*(我无法确定这是否导致了紧急情况,也无法断言它是否解释了所有医疗决策。)*令我印象深刻的是,记录在案的信息与我们对其存在的认知之间存在着巨大鸿沟。

我自身经历的慢性疼痛、脊柱问题、就医过程以及影像检查,也让我有充足的时间站在了病历的另一端。我深知,当对涉及自身身体的信息心存疑问,**却又无从查证时,**那种感受是怎样的。我是一名开发者,而非医疗专业人士。
1
1 9
文章 John Pan · 6 小时 前 9m read

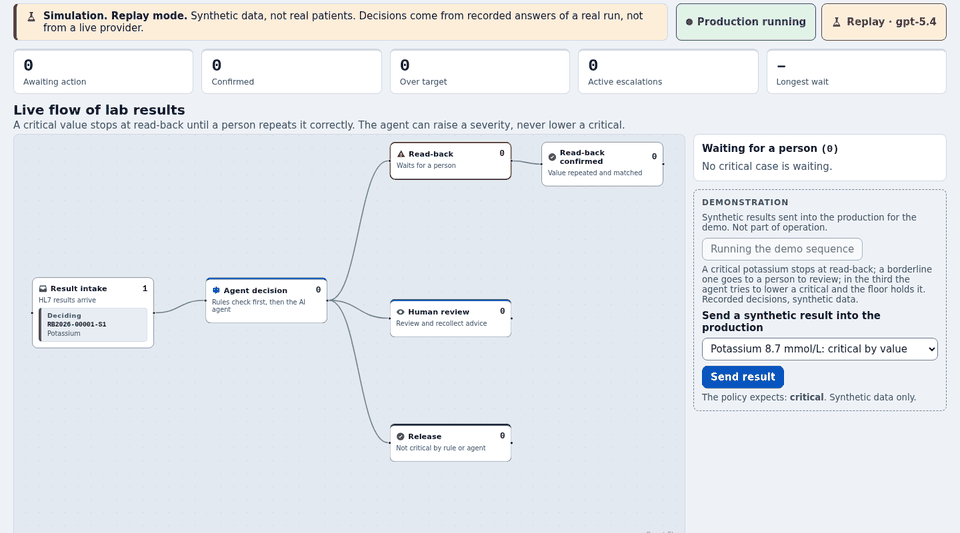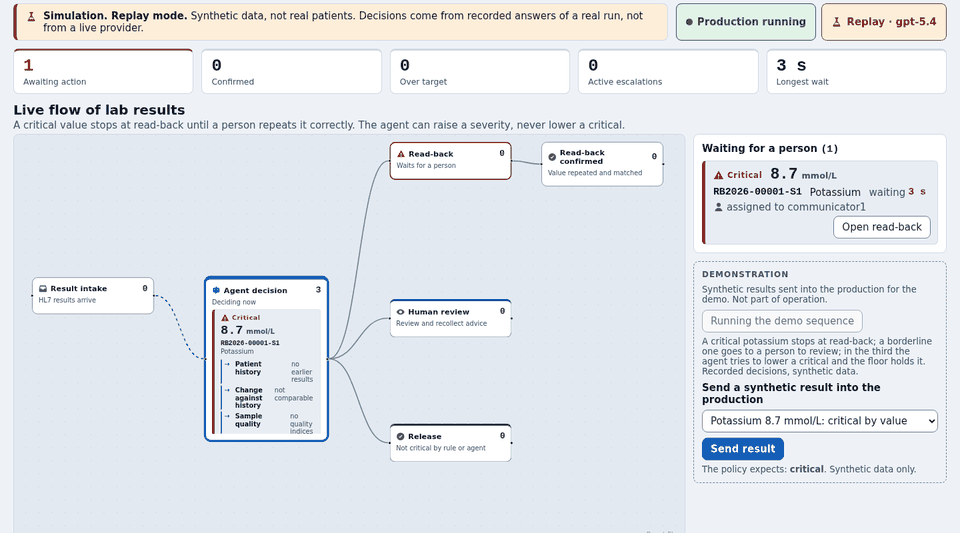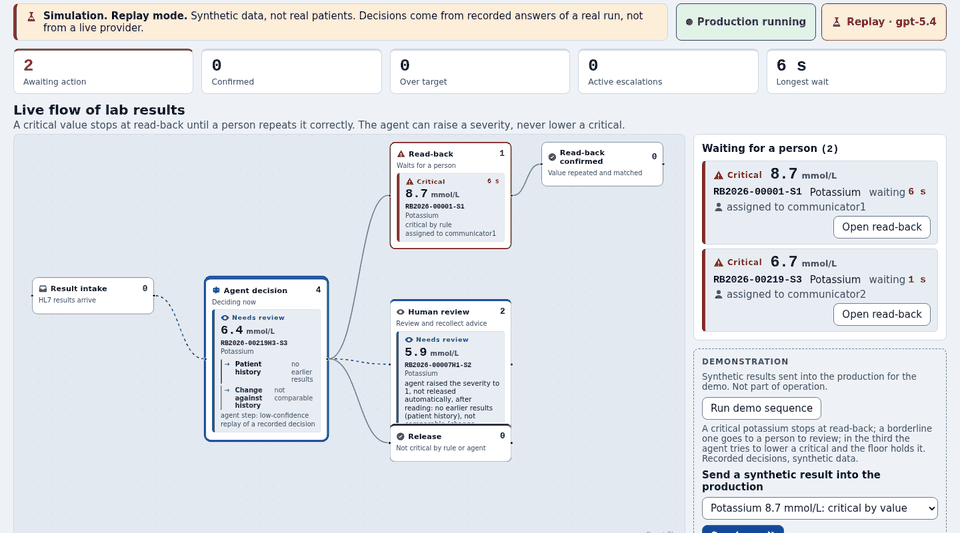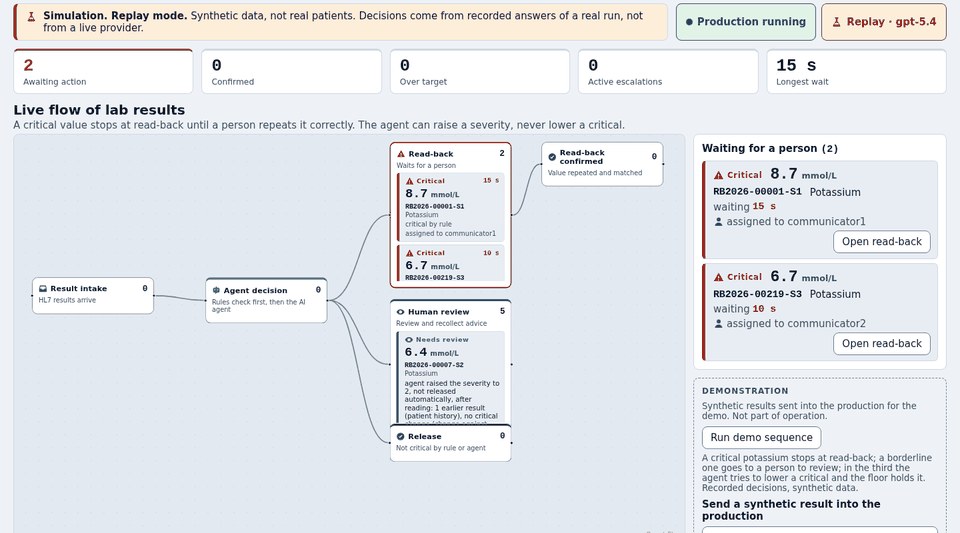
在我的第一篇文章中,我介绍了“Readback”——这是我为*“互操作性工作流中的AI代理*”竞赛提交的参赛作品:这是一个AI Hub代理,可在IRIS for Health生产环境中对实验室结果进行分级处理,它可以将结果升级为“危急”级别,但绝不会将其降级,并且在有人核对数值之前,绝不会让“危急”级别的结果关闭。

本文要探讨的,是我认为比产品本身更值得深思的问题:**当一个AI代理运行在安全关键型工作流中时,究竟是哪一层在真正保障人员安全?**我对此进行了实测,结果令我大吃一惊。

测量内容

一个包含240条实验室检测结果的合成数据集(8个类别,每类30条,种子值2026),外加180条早期结果以构建患者病史。 每个案例都会完整运行整个产品流程:规则、检索、代理及其工具、组合以及发布保护。

0
0 5
文章 cheng yu · 十一月 8 4m read

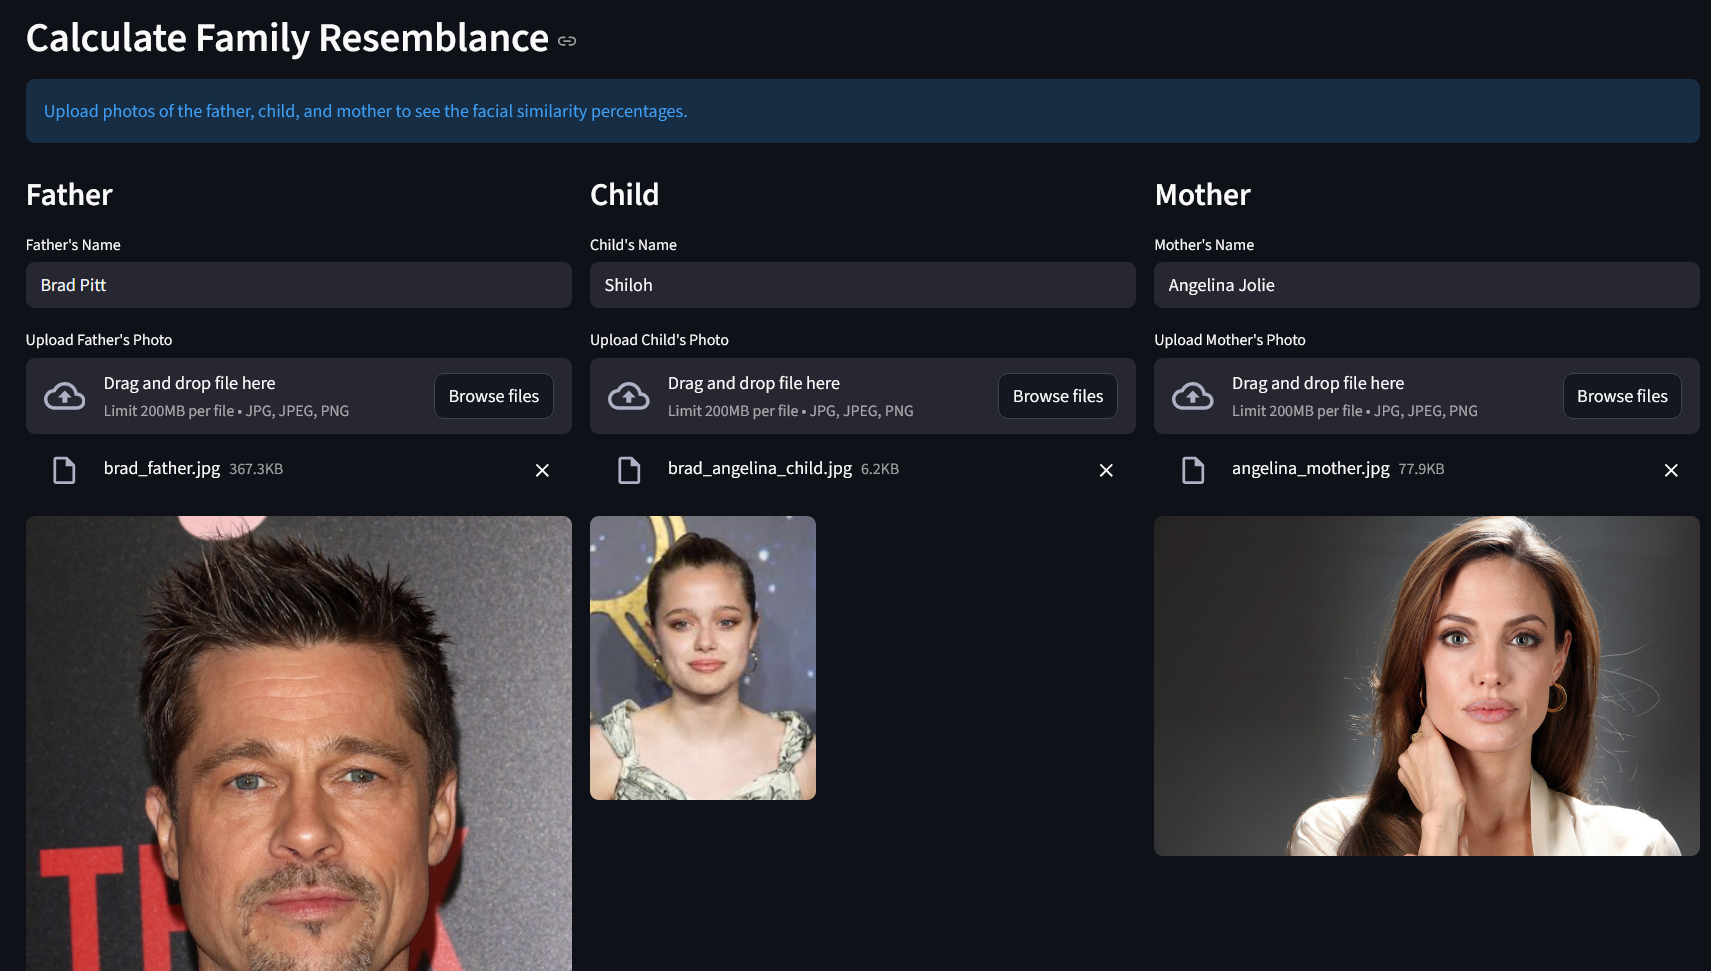
人脸识别已成为验证个人身份最广泛采用的方法,从而能够实现系统访问、个人及文件数据的核验,以及对操作和文件的审批。
相关挑战主要涉及数据库规模庞大时的性能表现、识别准确率,尤其是生物特征面部数据的隐私保护。面对这些挑战,InterSystems Vector Search 无疑是最佳解决方案,因为它能够:

  1. 在数百万条记录中执行向量搜索,响应速度远快于传统方法。
  2. Vector Search 所采用的向量和数学模型在保证高准确性的同时,不会牺牲性能。
  3. 无需存储人脸图像,仅需存储图像嵌入向量,从而使逆向工程成为不可能。这确保了完全符合《通用数据保护条例》(GDPR)、《巴西数据保护法》(LGPD)及其他个人数据隐私法规的要求。

本文详细介绍了收集、处理、存储以及执行向量人脸搜索的分步流程。文中使用了Deepface(一款用于处理人脸并将其转换为嵌入向量的非常流行的Python库),并结合InterSystems IRIS Vector Search对存储的嵌入向量进行向量比较,从而实现近乎实时的人脸识别。

解决方案的安装与使用

请按照以下步骤安装人脸识别系统(基于 Deepface 和 IRIS 的开源解决方案):

  1. 将代码库克隆或通过 git pull 拉取到任意本地目录

    $ git clone https://github.com/yurimarx/facial-matching.git
    $ cd facial-matching
    $ docker-compose build
    $ docker-compose up -d
0
0 9
文章 cheng yu · 十一月 8 4m read

本文中的观点和见解基于我的个人经验。在起草和润色文本的过程中,我借助了大型语言模型(LLM)的协助,并亲自对内容进行了审阅和定稿。

对于熟悉代码且打字速度快的开发者来说,编写文档未必困难。对我而言,真正具有挑战性的部分其实是润色文档、梳理说明逻辑、修正语法,并确保其他团队成员能够准确理解具体实现方式。 

本文旨在分享我作为驻曼谷的实施团队成员,借助 Claude 获得帮助的经验。在处理 InterSystems IRIS 和 TrakCare 定制化项目时,我利用它来辅助文档结构设计和提升可读性,同时由我自己对最终内容进行审核。

开始之前,请遵循贵组织的 AI 政策。使用公司批准的 AI 工具,并确认您被允许提供哪些源代码和客户信息。对于 InterSystems 员工,请先向 AI 赋能团队申请批准,并务必阅读相关政策。拥有 AI 工具的使用权限并不意味着所有内容都可以与之共享。

为 Claude 准备上下文

文档的质量在很大程度上取决于所提供的上下文。我的工作流程整合了三类输入:

  1. 自定义代码:例如,TrakCare API 扩展接口、LogiReport 使用的 ObjectScript 存储过程,或自定义 JavaScript 功能。如果某个类从自定义辅助类继承了方法,在相关的情况下我会将该辅助类包含进来。否则,Claude 可能会看到方法调用,却缺乏解释其行为所需的足够信息。
0
0 9
文章 cheng yu · 十一月 8 6m read

Hugging Face 为从事机器学习、自然语言处理、数据分析和人工智能领域的开发者提供了数千个数据集。InterSystems IRIS 则为数据的存储、查询和处理提供了一个强大的平台。将这两个生态系统结合起来,为希望直接在 IRIS 内对真实世界数据集进行实验的开发者创造了令人兴奋的可能性。

然而,导入数据集绝非仅仅是下载文件并将行插入表中那么简单。一个切实可行的解决方案需要处理数据集配置与分割、模式映射、分类标签、可重复性、大规模导入以及数据完整性等问题。

为应对这些挑战,我开发了IRIS HF Loader——这是一个开源的数据集资源管理器和导入工作室,可通过 Web 界面、ObjectScript、SQL、REST 以及 Python 将 Hugging Face 数据集导入 InterSystems IRIS。

在本文中,我将阐述该问题、解决方案背后的设计决策,以及开发人员如何利用它直接在 IRIS 中处理 Hugging Face 数据集。

1. 导入前的数据集探索

首要挑战之一是在决定导入之前,识别合适的数据集并理解其结构。

IRIS HF Loader 提供了一个数据集发现界面,支持按名称或关键词搜索 Hugging Face Hub。用户可以按下载量、点赞数、热门指数或最近更新对结果进行排序,并按任务、大小和语言进行筛选。

0
0 7
文章 cheng yu · 十一月 8 10m read

上午10:47— 何塞·加西亚的肌酐检测结果传送至医院的FHIR服务器。 2.1 mg/dL— 比上月上升了35%。

接下来会发生什么?

  • 大多数系统:❌ 检测结果会滞留在队列中,直到临床医生手动审核——这可能需要数小时甚至数天。
  • 本系统:👍 人工智能代理会评估趋势,参考临床指南,并生成循证建议——仅需几秒钟,且完全自动完成。

没有聊天机器人。没有手动提示。没有“黑箱”推理。

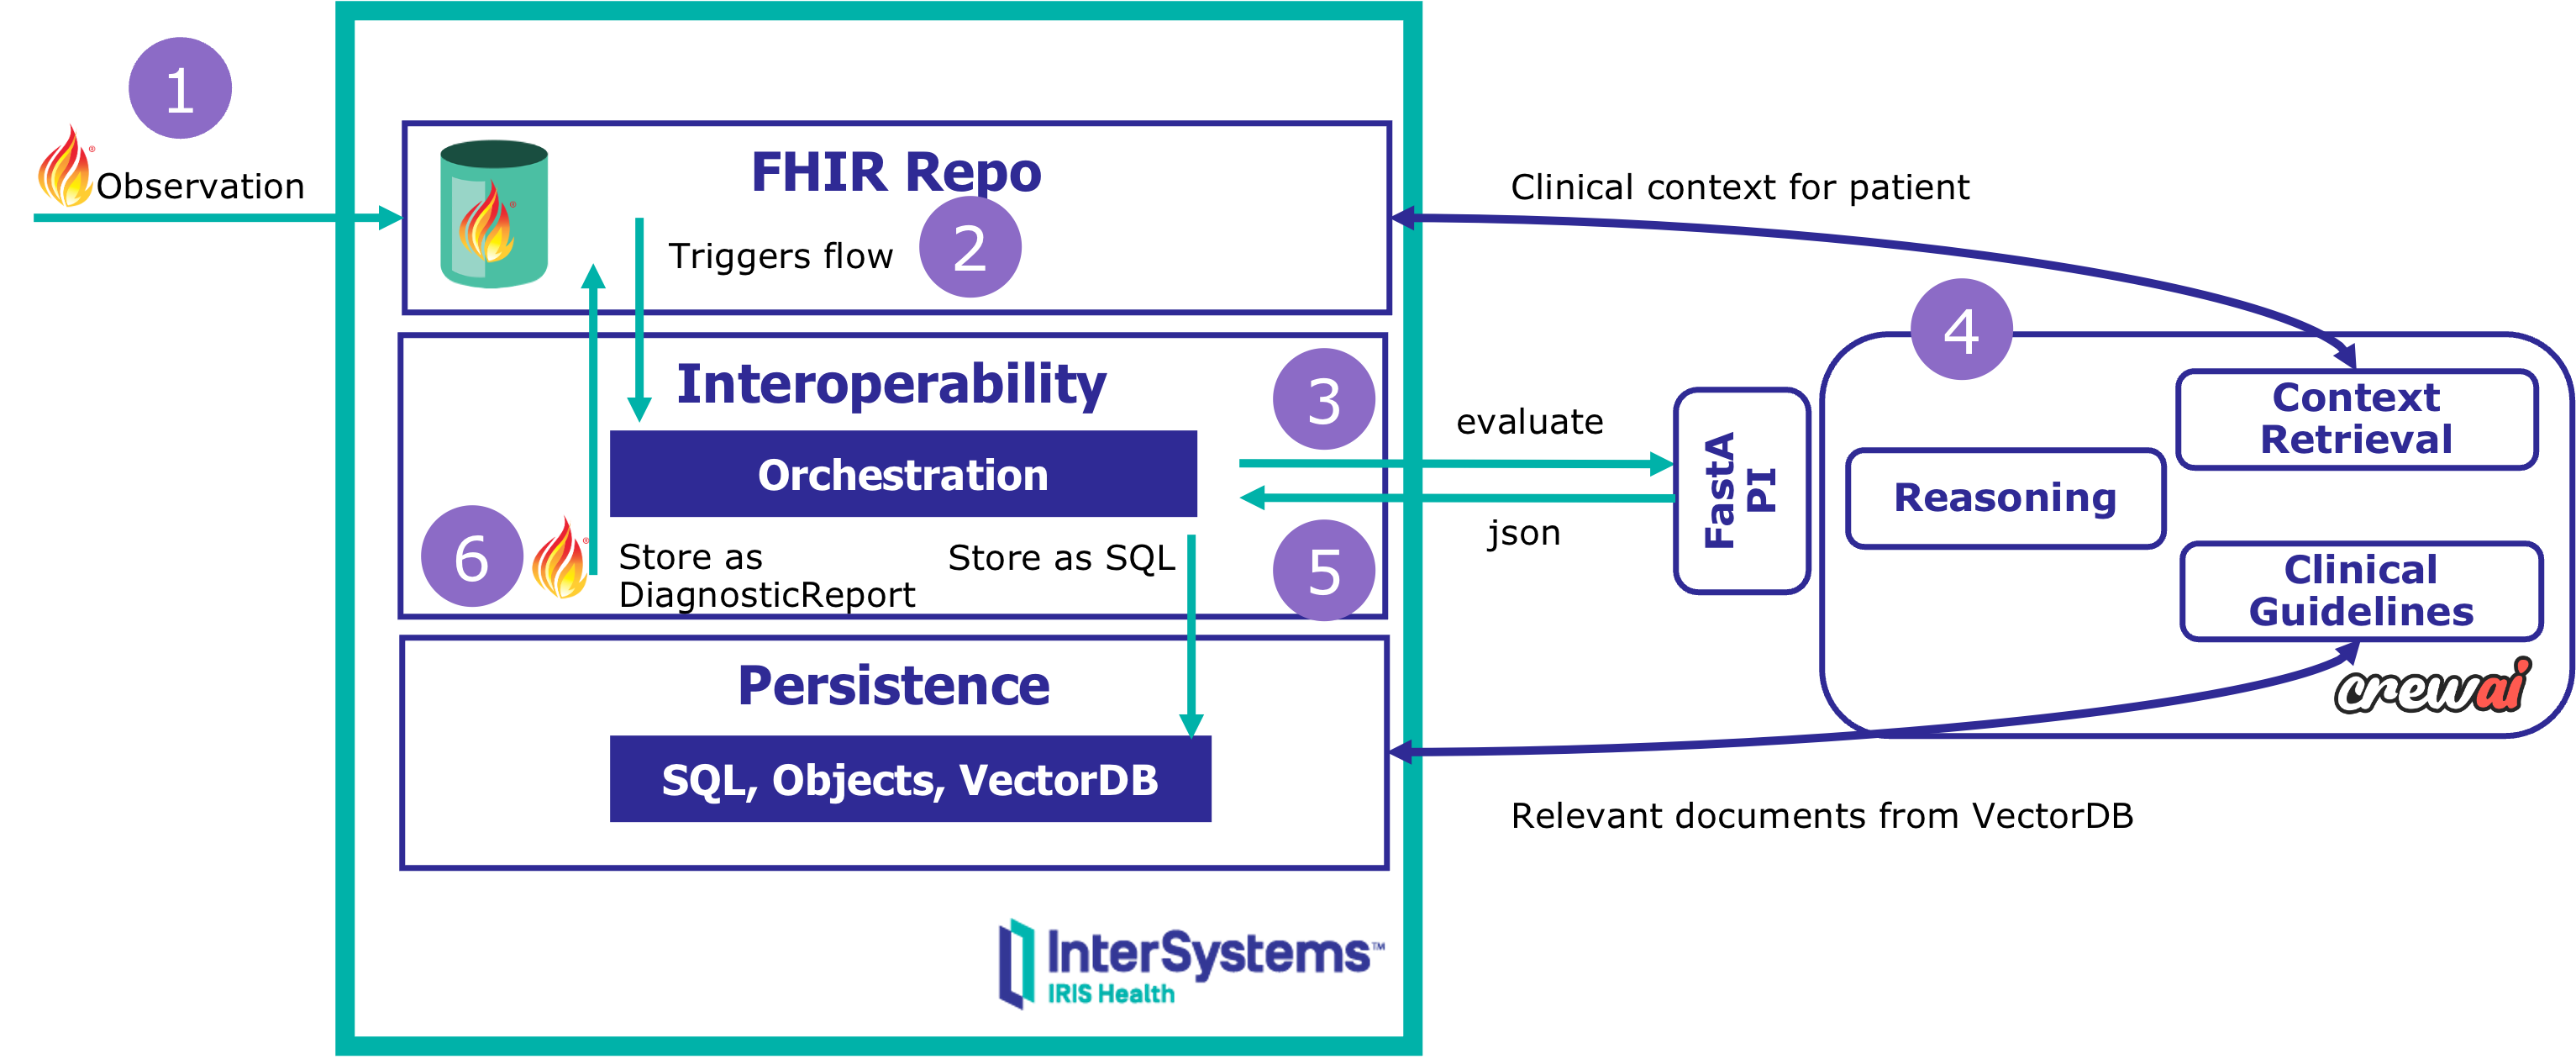
这是一种具有完全可解释性的事件驱动型临床决策支持系统:

image

✅由FHIR事件自动触发✅多智能体推理(上下文、指南、建议) ✅完整的SQL审计日志(每项决策、每个证据来源) ✅FHIR原生输出(将DiagnosticReport发布到服务器)

构建技术:

  • InterSystems IRIS for Health— 编排、FHIR、持久化、向量搜索
  • CrewAI— 用于结构化推理的多智能体框架

您将学习:🖋️ 如何在生产级互操作性系统中协调基于代理的人工智能工作流——以及为何可解释性比单纯的准确性更为重要。

YouTube 视频播放器


🎬 本演示的输出内容

当收到何塞的肌酐异常检测结果时,系统会自动生成:

**输入:**FHIR 观察结果(肌酐 2.

0
0 8
文章 cheng yu · 十一月 8 13m read

IRIS 2026.2 提供了一个用于管理的、已文档化的 REST API——即位于 /api/admin 下的 SysAdmin API,其 273 个操作均附有 OpenAPI 规范。 在**“构建您自己的管理门户”竞赛中,我基于该 API 构建了名为 Aperture** 的管理门户,并根据已发布的规范生成了其 TypeScript 类型定义。编译器会检查门户发送的每个请求以及读取的每个字段。

这使得规范承担了关键职责。当规范与服务器状态不一致时,门户会出现编译器无法检测到的错误:某列保持空值、某项服务显示为禁用状态、列表过早终止。 因此,我对 Aperture 进行了实际实例测试:在自己服务器上的容器中运行 IRIS for Health 2026.2(Build 221U),并在每次代码推送时通过持续集成测试 IRIS Community 2026.2。

共发现了二十处差异。其中大部分是明显的矛盾:字段名称或类型不一致、限制条件与文档不符、操作路径不同。其余则是规范中未提及但客户端必须了解的行为,其中有一处会导致监控系统将一个运行正常的实例误判为降级状态。

针对每处差异,我列出了规范中的规定、IRIS 2026.2 的实际行为,以及客户端可采取的应对措施,并附上了相关记录答案的链接。

0
0 8
文章 cheng yu · 十一月 8 7m read

Kaggle 数据集虽然很有用,但将其导入 InterSystems IRIS 并不总是那么简单。 您可能只有一个 CSV 文件,也可能有多个相关文件、包含多个工作表的 Excel 工作簿,甚至是大小达数 GB 的文件。在导入任何数据之前,您需要了解手头的数据情况,以及这些数据应如何存储在 IRIS 中。

正因如此,我开发了iris-kaggle-loader。它允许您探索数据集、检查其结构、审查导入方案,并将数据加载到 IRIS 中。您可以通过 Web 界面,或借助 ObjectScript、SQL、REST 和 Python 进行操作。即使没有 Kaggle 账户,您也可以处理公开的数据集。

本文将通过一个真实数据集进行演示,并重点说明其中最费思量的部分。

Kaggle 的独特之处

在编写任何代码之前,我列出了 Hugging Face 加载器无需处理的内容:

  • 文件,而非数据分割。一个数据集可能同时包含 CSV、TSV、Parquet、JSON、JSON Lines 和 Excel 文件,此外还有完全无法导入的图像和 PDF 文件。
  • 相关表。许多数据集实际上是一个分散在多个文件中的小型数据库。
  • CSV 中没有数据类型。每个列的数据类型都必须根据其值来确定。
  • 超大文件。有些文件大小达几千兆字节,而你通常只想提取前几千行来尝试一些操作。
  • 版本编号。
0
0 8
文章 cheng yu · 十一月 8 8m read

在这篇文章中,我让 Claude Code 根据三条通俗易懂的英文提示,在我的 IRIS 实例上构建了一个 LLM 配置、一个代理、一个工具和一项技能,然后我自己对结果进行了验证。以下两个社区项目使这一切成为可能:

  • iris-agentic-dev是一个 MCP 服务器和命令行工具(CLI),它为 Claude Code、VS Code + Copilot、Cursor 或任何其他 MCP 客户端提供了 90 多种 IRIS 工具:读取类、编写和编译代码,以及在运行中的实例上执行 ObjectScript 和 SQL。
  • iris-ai-hub是随其附带的一项技能。它会告知助手 AI Hub 文档的位置,指示其在编写任何代码前先读取已安装的 %AI 类,并列出 AI Hub 的相关事实。

开始之前我已准备好的环境

本文仅讨论构建过程。我已在实例上配置了以下内容:

内容 详情
IRIS InterSystems IRIS 2026.3.0AI,构建版本 154(早期访问版),运行于我的 Mac 上
命名空间 AIHUBLAB,这是我为本次实验创建的命名空间。其代码存储在数据库 AIHUBLABCODE 中,数据存储在 AIHUBLABDATA 中。任何命名空间均可使用。
密钥 我的 OpenAI API 密钥,存储在“钱包”中,名称为 LabSecrets.LLMKey。
0
0 6
文章 cheng yu · 十一月 8 15m read

本文介绍的是 v1.0.0 版本,即本文撰写时的公开发布版本。

当 HL7 传输失败时,必须有人决定是否重发。如果重发过期的传输数据,就会覆盖更新的数据;如果保留当前数据,患者在另一系统的屏幕上就会被显示在错误的病床上。Shutter 将每次传输失败都转化为一个案例。 由 IRIS AI Hub 代理组成的委员会会读取密封证据并提出处理建议。一个确定性门控机制会核查该方案。最终由人工或该机构自身的书面政策予以批准。随后,Shutter 执行一次有条件写入操作,并在接收系统的收据和历史记录中进行验证。 恢复写入需要通过门控并获得批准。之前的预演仍信任接收方会遵守 dry_run:如果接收方当时进行了写入,Shutter 就无法撤销该操作。

Shutter 是我参加“互操作性工作流中的 AI 代理”竞赛的参赛作品。本文按照 InterSystems 的顺序,涵盖了竞赛的四个主题:AI Hub 体验、模型与成本、追踪以及 IRIS Agentic Dev。

AI Hub 体验

此处所有内容均基于构建版本 2026.3.0AI.154.0 进行测试。在 2027.1.0AI.109.0 版本(即早期访问门户自 11 月 2 日起提供的构建版本)中,我重新检查了配置存储描述符,包括 %LogExecution、的三个参数、基础的以及缺失的IPM:这些均保持不变。

0
0 8
文章 cheng yu · 十一月 8 4m read

只有当测试证明某个研究步骤已完成时,实验室才会为此支付费用。

Knos 助力研究跨越“死亡谷”。

仅限模拟资金。本文探讨的是,当 InterSystems IRIS 平台内的人工智能代理读取证明时,其中一项验证的成本是多少。

在让智能代理协助做出任何涉及资金的决策之前,实验室会向我提出两个问题:每项决策的成本是多少?这个数字从何而来?在 IRIS 上的 Knos 中,答案来自对生产环境自身消息的 SQL 查询。

这个数字从何而来?决策的每一步都是决策自身会话中的一条互操作性消息,即 Knos.Iris.Msg.Span。因此,它会在 Visual Trace 中与证明和裁决结果并列显示。 相同的行会被记录到一张表中,即 Knos_Iris_Data.Span,其中包含 Model、 、 、 和 。没有任何事后估算:令牌数量即为模型给出的答案所报告的数值,而成本则是令牌数量乘以该模型的单价。

模型。该代理运行在 qwen2.5:1.5b-instruct 上,这是一个位于 IRIS 旁边的 Ollama 容器中的小型开源模型,通过 AI Hub 的 openai 提供商运行,无需密钥。 评估标准通过 snowflake-arctic-embed-s(3300 万个参数,384 个数值)以嵌入式 Python 形式实现。

测试结果。

0
0 8
文章 cheng yu · 十一月 8 12m read

大家好,

AI Hub 是 IRIS 的新组件,用于构建能够与您的数据和生产环境无缝协作的人工智能代理。代理即为一个类。 您可以为其提供指令、一组可调用的工具,以及可选的技能(仅在需要时加载的额外指令)和可供搜索的知识库。随后,它将进入循环运行:模型请求工具,IRIS 执行您的 ObjectScript 方法,结果返回给模型,如此循环往复,直至模型给出答案。 策略决定代理可以使用哪些工具,并可记录每次调用。会话会将整个对话记录在 IRIS 中,因此您可以稍后打开它,查看代理为何会给出这样的回答。

互操作性是应用此方案的天然首选场景。每个生产环境都会出现消息发送失败的情况,而每条失败的消息都像是一道小谜题,需要人工阅读、理解并修复。只要您能控制代理的权限范围,这正是代理可以协助完成的工作。

本文将展示正确构建该系统后的实际效果。这是我参加 InterSystems 编程大赛的参赛作品iris-agentic-production:一个 AI Hub 代理,用于在 IRIS 生产环境中对失败的 HL7 实验室消息进行分诊,并附带一个用于构建和添加自定义代理的工作台。 我将按照您今天安装后所看到的界面,逐屏为您详细讲解。第二篇文章将提供分步教程,指导您亲自构建同类系统。

应用程序的功能

凌晨2点,一条实验室结果在接口引擎中出现错误。可能是时间戳格式不正确,或者某个本地检测代码从未映射到LOINC。

0
0 12
文章 cheng yu · 十一月 8 7m read

大家好,

上一篇文章介绍了FlightDeck的功能。本文将探讨在开发过程中发现的发现,无论您是否关注我的应用程序,其中大部分内容都很有用,因为这涉及平台本身。

InterSystems 在本次竞赛中发布了 SysAdmin API 规范:/api/admin,190 个路径,273 个操作,六个域。全面覆盖这些内容时,我发现了一些规范中未提及的问题,同时也获得了一项关于我自身代码的测量结果——我宁愿将其公布于众,也不愿隐瞒。

规范存在缺失的三个方面

**没有日志端点。**竞赛要求提供“所有日志,即各个子系统向用户报告的内容”。对全部 190 个路径进行搜索后,只发现了审计日志和日志文件,别无其他。 没有 messages.log,没有警报,也没有互操作性事件日志。任何想要妥善覆盖该领域的人,都必须编写原生提供程序。

其中有一项是我刻意没有实现的。日志会向每位用户隐藏其无权读取的数据库记录。若要原生重构该功能,就意味着需要在 IRIS 之外决定授权规则,因此源代码会以该理由显示为不可用,而非出现细微的错误。一个经过选择并明确说明的限制,比事后才发现的限制更有价值。

社区版镜像不提供 v2 服务。intersystemsdc/iris-community:latest 是 2026.1 维护分支,仅支持版本 1。

0
0 8
文章 John Pan · 十一月 8 3m read

初次接触 ObjectScript 确实令人兴奋,但如果你习惯了其他编程语言,可能会觉得它有些不同寻常。许多初学者都会遇到同样的障碍,因此这里列出了一些需要注意的“陷阱”。(还有一些友好的建议,帮助你避免这些陷阱)


随意命名

我们都曾有过这样的经历:为了尽快推进工作,把某个东西命名为 Test1 或 MyClass。但一旦项目规模扩大,这些名称就会变成一场噩梦。 

➡ 从一开始就选择清晰、一致的命名。不妨将其视为给未来的自己和团队成员留下的“面包屑”。


混淆全局变量与局部变量

全局变量(^GlobalName)起初可能会让人感到困惑。它们不仅仅是普通的变量。它们存在于数据库中,即使代码停止运行后仍会保留。

➡ 仅在真正需要持久化数据时才使用它们。其他情况下,请坚持使用局部变量。(这也能节省存储空间。)


忽略事务

试想一下,你在更新患者记录时,会话却中途崩溃了。如果没有事务,你将只得到半成品的数据。

➡ 将重要的更新操作封装在 TSTART/TCOMMIT 中。这就像同时点击“保存”和“撤销”一样。


在字符串中构建 SQL

直接将 SQL 嵌入字符串中并执行虽然很诱人,但很快就会变得混乱且难以调试。

➡ 使用嵌入式 SQL。它更简洁、更安全,也更容易维护。

0
0 7
文章 John Pan · 十一月 8 4m read

Knos 帮助研究项目跨越“死亡谷”。这意味着,只有当测试证明某个研究步骤已完成时,实验室才会为此步骤支付费用。我是在 InterSystems IRIS 中构建了负责验证该证明的组件。以下是其工作原理,以及如何通过四条命令进行尝试。

举个例子。某家医院实验室出资支持一家初创公司,为其检测试剂盒搭建在线商店。第一步的120美元资金将在商店结账响应时间低于300毫秒时支付,该响应时间由初创公司自己的GitHub测试进行测量。测试通过。 IRIS 中的 AI 代理读取结果并给出“是”的答复。由于金额超过 50 美元,实验室的审批人点击“批准”,该步骤便以虚拟货币支付。测试失败则不会支付任何款项。

为何要设计一个只能说“不”的AI?实验室不能允许模型向任何人付款。因此,我的代理没有转移资金的工具。它最坏的情况就是本不该批准时却批准了,但此时仍有一条书面规则和一个人作为障碍。

只需四条命令即可尝试。你需要 Docker 以及来自 InterSystems 早期访问门户的 AI Hub 镜像文件(版本 154)。

git clone https://github.com/drexthealpha/Knos && cd Knos/iris
bash scripts/load-image.sh ~/Downloads/irishealth-community-2026.3.0AI.154.0-docker.tar.gz
bash scripts/env-secrets.sh && docker compose up -d --build
bash scripts/ready.sh
0
0 5
文章 cheng yu · 十一月 7 6m read

每个医院集成引擎都有一个失败消息队列。其中大部分只需重新发送即可。但其中也有少数是因系统故障而滞留的关键实验室结果,或是即将发送给错误患者的数据。在凌晨3点区分这些情况才是难点。

Interop Medic 能在 InterSystems IRIS 内部完成这种分诊工作。这是我参加“互操作性工作流中的 AI 代理”竞赛的参赛作品,基于 AI Hub 早期访问版(版本 154)构建。 对于每条失败的 HL7 v2 或 FHIR 消息,它会决定采取五种操作之一:重发、修复后重发、重新路由、隔离或上报。

本文将介绍其工作原理、实际记录显示的情况,以及这些记录所引发的政策变更。

无需安装,直接在浏览器中体验:运行录屏回放

代码:GitHub·视频:[YouTube 制作中] ·Open Exchange:interop-medic-ai-hub

Replay of the critical result case: the agent says resend, the policy holds it for a person

工作原理

整个处理流程是典型的互操作性生产环境:

  1. 首先由快速决策模型给出响应。Jev、Nimble 或 Inception 的 Mercury 会提供一个操作建议及其置信度。
  2. 一个闸门会验证该响应。如果置信度较低、严重程度较高,或者该案例属于转诊情况,则将任务转交给人工客服。
  3. AI Hub %AI.Agent 负责核查事实。它通过 IRIS Vector Search 检索历史决策,验证 HL7 数据,查询路由表并读取端点的队列。
0
0 6
文章 John Pan · 十一月 7 15m read

一项实验室检测结果可能是一个完全有效的 HL7 消息,但传输起来仍可能存在安全隐患。本文介绍了我是如何构建CareBridge AI 的——这是一个基于 InterSystems IRIS for Health 的互操作性解决方案,其中IRIS AI Hub 代理负责排查异常,而确定性策略闸门则决定实际应采取的行动。 这是我参加*“互操作性工作流中的AI代理*”竞赛的参赛作品。

0
0 8
文章 John Pan · 十一月 6 4m read

引言

最近新增的FIFO组功能,使得在互操作性生产环境中,即使池大小(Pool Size)大于1,也能保持先入先出(FIFO)模式的消息处理,从而在不牺牲准确性的前提下提升性能。 该功能首次出现在 InterSystems IRIS® 数据平台、InterSystems IRIS® for Health 以及 InterSystems Health Connect™ 的 2025.3 及更高版本中。

先进先出模式的消息处理在许多集成场景中至关重要,尤其是在医疗保健领域。传统上,通过将每个业务主机配置为每次仅处理一条消息(Pool Size = 1)来实现 FIFO 顺序。 尽管这种方法很有效,但可能会限制吞吐量并导致系统资源利用率不足。FIFO 组可在必要时保持 FIFO 顺序,而无需强制将 Pool Size 设置为 1。

0
0 6
文章 cheng yu · 十一月 6 1m read

这是我的SQLgateway系列文章的第6篇。作为InterSystems的产品,Caché
,自然成了一个相当自然的选择。除了其他技术之外,SQLgateway还提供了
多种迁移至 IRIS 的途径之一。如果只是部分
且需要反复更新

这次,获取正确的JDBC驱动程序非常容易,因为它已包含在安装包中。
 相关文档内容详尽且清晰。 

注意:
要与 Caché 建立网络连接,您需要相应的许可证。
Caché 默认仅支持单用户且不支持网络连接。 
请添加有效的许可证,并在 /cache/Dockerfile 中启用复制功能。

构建完成后,容器运行完美,迁移过程
十分顺利。DDL 版本方面未出现任何问题。我使用默认的 SAMPLES 命名空间
作为数据源。此外,您还有丰富的选择。

但与其他所有情况一样,请注意跨依赖关系。

警告:这只是经典技术
——IRIS仅支持SQL、Java和ISOS 
——没有机器学习、没有人工智能、没有 Python,也没有其他花哨的工具。
您可能会期待看到更多关于 SQLgateway 的演示。

0
0 8
文章 cheng yu · 十一月 6 1m read

这是我的SQLgateway系列文章的第7篇。 
最后但同样重要的是,作为 InterSystems 旗下产品,IRIS 本身也自然而然地成为了目标。 
除了其他变体外,SQLgateway 还提供了一种与 
。无论是部分迁移,还是需要 
重复更新(归档?)

这次,获取正确的JDBC驱动程序非常容易,因为它已包含在安装包中。
 相关的文档内容详尽且清晰。 

我面临的主要挑战是让 Docker-Compose 运行同一个 Docker 构建
,但需要使用不同的配置——这些配置必须在容器启动时进行设置。

我使用了Caché-SAMPLES中广为人知的Sample.*类子集 
中广为人知的 Sample.* 类的一个子集,并控制其规模适中,以确保启动和测试速度达到可接受的水平。

按要求配置完成后,容器运行完美,模拟的
“迁移”过程十分顺利。DDL 版本无问题,也无依赖关系问题。

警告:这只是经典技术
——仅使用 SQL、Java 和 ISOS 的 IRIS 
——没有机器学习、没有人工智能、没有 Python,也没有其他花哨的工具。

0
0 8
文章 cheng yu · 十一月 6 1m read

这是我关于 IRIS SQLgateway 系列文章的最后一篇。

                         
在介绍了7个将DB_Migration迁移到IRIS的示例后,我实在忍不住将 
将围绕 IRIS 的各个独立包整合到一个包中。
将8个容器整合到1个 Docker-Compose 文件中,感觉就像驾驶一辆八缸发动机汽车一样。

  • sqlgateway-magnificent-7 > IRiS1
  • 1 个 oracle21c
  • 2 个 MySQL
  • 3 个 PostgreSQL
  • 4 IBM DB2
  • 5 MS SQL
  • 6 Caché
  • 7 IRIS2

各个映射的同步是最大的挑战。
其次是提供的测试数据量。下载部分
GB数据的下载过程令人煎熬,还引发了一些麻烦。

再次衷心感谢@Yuri Marx提供的这套出色的数据集。
测试系列与独立软件包中的完全一致
可能只有IP端口发生了变化。尝试连接其他数据库是一次有趣的体验
接触其他数据库。MSSQL 带来了最多的麻烦。
提示:
此外,我的 Docker Desktop 在单个 Compose 文件中同时启动 8 个容器时似乎遇到了困难。
通过 Docker 控制台手动重启容器解决了该问题:
若缺少 Cache.Key,则需重建镜像或手动添加。

在我个人的评分中,IRIS 毫无疑问是赢家。 
你感到惊讶吗?

0
0 8
文章 cheng yu · 十一月 6 2m read

我之前关于SQLgateway 迁移的系列文章,是一篇篇幅较长的文章,介绍了
了可用的各种方案。不过它既不易操作,又难以追踪。
因此,我的挑战是:如何“吃掉一头大象”?>> 把它切成小块!!

我的目标是兼顾两点:既能独立创建每个容器,又能
同时支持一键构建整个集合。因此现在可以
在不影响其他容器的情况下修复单个容器的问题。

结果证明,这变成了一次关于 Docker 网络和脚本编写的实践,

  • 每次执行 Docker-Compose Up 都会创建一个独立的网络。因此,与
    前面的示例那样简单地启动,也会生成8个彼此隔离的网络。
    解决方案:定义一个公共网络并将容器加入其中。
    现在 TCP/JDBC 可以找到服务器,而且我们再也不会遇到端口冲突了
  • 为了启动所有容器而连续执行 8 次 `docker-compose up -d` 实在不太好玩 
  • 解决方案:Docker Compose 提供了一个 INCLUDE 指令。只需点击一下,一切就搞定了。
include:   
  - ./iris1/docker-compose.yml   
  - ./cache/docker-compose.yml    
  - ./ibmDB2/docker-compose.yml   
  - ./iris2/docker-compose.yml    
  - ./MSsql/docker-compose.yml   
  - ./mysql/docker-compose.yml   
  - ./ORACLE/docker-compose.yml   
  - ./postgres/docker-compose.yml
0
0 7
文章 cheng yu · 十一月 6 2m read

通过邮件发送信息是网络中历史最悠久的技术之一
。邮件传输标准于1980年正式发布。
SMTP 代表简单邮件传输协议。
IRIS自诞生之初乃至更早之前就已支持SMTP。
随着时间的推移,各种功能不断演进,特别是与
安全、编码、身份验证、多部分邮件等方面……
相关文档在各个细节上都十分详尽。您可以在
类、方法、实用程序和示例。

本示例提供了一个非常简单的入门起点。
如果您要发送电子邮件,就需要一台能够接收邮件的 SMTP 服务器。
这可以是你选择的某个外部服务器,但同样,IRIS
已做好充分准备为您提供服务。互操作性功能可满足您的所有需求。
因此,该软件包为您提供了一个用于测试的最小规模生产环境。
该服务不会将数据写入真实的生产环境,而是将输入写入一个全局
,您可以立即查看。
因此,该演示程序可以在单个实例中运行,以发送和接收邮件。
提供了一个涵盖所有必要步骤的精简测试例程。

所有操作均通过一个包含 5 个操作的命令行会话进行控制

  • do mail; 编写一封包含2行的简单邮件
    若需更多文本,请向字符流 %mail.TextData 中添加内容
    ,同时别忘了调整文本大小
  • do start ; 启动 SMTP 服务器生产环境
    • 17:27:37.285:Ens.Director: Production 'mail.Receive' starting...
      17:27:37.332:Ens.Director: Production 'mail.Receive' started.1
0
0 7
文章 cheng yu · 十一月 6 2m read

IRIS 在处理和管理表格中的数据方面表现非常出色。
但正如您在标准包中所见,它在逻辑处理方面同样表现出色
分析、互操作性、所有与健康相关的处理,最重要的是,
来自我们全球合作伙伴的庞大应用程序集合。

所有这些应用程序都有一个共同的需求:
总有一些中小规模的信息需要处理,
,这些数据根本无法适应任何重复的表格结构。我常举的例子 
就是一串文本行,比如我从妻子那里收到的购物清单。

  • 它具有有限的生命周期, 
  • 维度有限, 
  • 结构难以预测
  • ,且每一条都是独一无二的作品 

将此类信息强行塞入表格是可行的,且这种情况经常发生。
但这种做法效率低下,特别是对于易变信息而言。

一种典型的做法是将信息保存在本地数组中:
但这可能会导致处理分区的内存达到极限。
因此,请将原始信息保存到一个全局数组中,该数组应采用与
处理机制的 GLOBAL 数组中保存原始信息。
这种方法速度很快,而且作为一名经验丰富的ObjectScript开发者,你会使用
“进程私有全局变量”(Process Private Global)来规避日志处理的开销
,一旦工作完成,它就会随你的进程一同消失,不留痕迹。

下一个挑战:  
由于处理过程可能耗时较长,可能会阻塞进程中的交互式
用户界面。那么,你可以将处理任务移交给一个 
后台作业,其优势在于可以预先选择要
:食品购物清单可能与园艺购物清单有所不同。
此时,您的“流程私有全局变量”将无法正常工作。它在后台环境中不可用。

0
0 9
文章 cheng yu · 十一月 6 1m read

OEX半持久化表中的前一个示例与一篇 
,该文发表于2020年, 题为《半持久类与表》,其内容 侧重于传统的 
存储模型,并通过间接引用实现存储全局变量的动态变更。
这种方法存在局限性和风险,而本文则避免了这些问题。  

描述

基类(User.Common)是一个模板,可应用于
USER、CLERKS、CUSTOMERS、PPG……等类,这些类彼此独立
。 
区别在于:User.Common 类使用了[NoExtent]参数
,因此不包含存储定义。
随后,将在各个类中指定要使用的存储。 
现在,它是一个静态值,用于定义要使用的全局变量。 
而且这是一个非常简单的定义。例如:

Class User.USR Extends User.Common [ Not NoExtent ]
{
Parameter DEFAULTGLOBAL As STRING = "^USR";
}

其余所有工作均由编译器完成。
副作用:POPULATE 现在针对每个类/表都是特定的。

0
0 7
文章 cheng yu · 十一月 6 2m read

大家好

对于感兴趣的朋友,这里分享一个我在某个项目中使用的实现示例,该示例利用 pymongo 包实现了与 MongoDB 的互操作。

iris-mongodb

通过 pymongo 包实现 InterSystems IRIS 与 MongoDB 的互操作(包括出站适配器)

请务必导入pymongo包。

此处提供用于测试的实现示例

NAMESPACE> do ##class(custom.python.pymongo.test).TestMongoDBCrud()

为了实现互操作性,请在业务操作中使用以下适配器:

Parameter ADAPTER = "custom.python.pymongo.outboundAdapter";

Parameter INVOCATION = "Queue";

查询示例:

/// parameters: (dbName, collectionName, query, fields, sort, limit) => query, fields and sort are %DynamicObjects
/// resultset is an array of objects (%DynamicArray)
set resultset = ..Adapter.Query("mydb","mycollection", {"_id":(tId)})
0
0 9
公告 Claire Zheng · 十一月 5

InterSystems Reports 26.2 版本现已在 InterSystems 软件分发网站的“组件”部分发布。该软件以“InterSystems Reports Designer”和“InterSystems Reports Server”的名义列出,支持 macOS、Windows 和 Linux 操作系统。

此版本对通过 Reports Server 提供的 Page Studio 和 Web Studio 的焕新用户界面进行了进一步优化。(请参阅下文的许可更新。)其他增强功能包括通过 TrueType 字体扩展了字体支持,新增了 2D 条形码,以及来自我们的合作伙伴 insightsoftware 的众多修复、安全更新和其他增强功能。

InterSystems Reports 26.2 基于 Logi Report 26.2 Service Pack 2 构建。如需了解更多信息,请参阅 insightsoftware 提供的发布说明。

2026 年的许可更新

自 2026 年 1 月起,InterSystems 增加了对Page Report Studio和Web Report Studio 的访问权限。这些功能使客户能够直接在报告服务器上执行更多报告编辑操作,从而减少了许多报告设计任务对安装 Report Designer 的需求。

0
0 6
文章 John Pan · 十一月 5 9m read

《Readback》是我参加 InterSystems 编程大赛*“互操作性工作流中的 AI 代理*”主题的参赛作品。 一个 InterSystems AI Hub 代理在 IRIS for Health 互操作性生产环境中对实验室结果进行分级处理。它可以将结果升级为“危急”级别,但绝不会将规则已判定为“危急”的结果降级,且在有人正确复核该数值之前,系统不会向任何人发送“危急”结果的通知。

通过构建该代理,我总结出的核心经验是:**规则保障安全,而代理负责解释。**我对此进行了测试,相关数据如下。

问题

一项关键的实验室检测结果——例如钾离子浓度为6.9 mmol/L,或血红蛋白在一天内下降了4 g/dL——如果相关人员未能获知并复述该结果,那么这些数据便毫无用处。以下两个环节的失误至关重要:

  • **遗漏:**危急结果被误报为正常。
  • **开环:**通知已发出,但无人确认。
0
0 10
文章 John Pan · 十一月 5 5m read

Hugging Face 提供了一个庞大的数据集集合,涵盖自然语言处理、分类、问答以及其他机器学习任务。要在 InterSystems IRIS 中使用这些数据集之一,开发人员通常需要下载该数据集,将其字段映射到 SQL 数据类型,创建表,并加载数据行。

iris-hf-import简化了这一流程。它允许您通过单个 ObjectScript 调用,将 Hugging Face 数据集导入到 IRIS SQL 表中。

该项目实现了Ideas Portal 中的 DPI-I-543 提案:将 Hugging Face 数据集加载到 IRIS 中,并为社区赏金计划的第三轮而创建。

导入数据集

安装包后,打开 IRIS 终端并运行:

write ##class(dc.hfloader.Loader).Load("hitorilabs/iris", "train")

该命令将加载数据集 hitorilabs/iris 的 train 分割集,创建目标表,并插入相关行。

在我的测试环境中,该调用返回了如下结果:

{
  "status": "success",
  "error": "",
  "dataset": "hitorilabs/iris",
  "config": "default",
  "split": "train",
  "table": "HFData.iris",
  "rowsWritten": 150,
  "columns": 5
}
0
0 10