#SQL

0 关注者 · 527 帖子

SQL 是在关系数据库中存储、操作和检索数据的标准语言。

文章 John Pan · 4 分鐘 前 5m read

您的应用中有一些自由文本输入框,您是否希望能够高效地对其进行搜索? 之前尝试过一些方法,却发现它们根本无法满足客户的性能需求? 我是否有一个奇招能解决您所有的问题? 您难道还不知道吗!? 我所做的,就是为您解决性能方面的难题,提供绝佳的解决方案!

照例,如果您想要“TL;DR”(太长;没读)版本,请跳到文末。 不过要知道,这样会伤我的心。

如果你在最新版本(2015.1 或更高)的 Caché/Ensemble/HealthShare 中,打开 SAMPLES 命名空间下的 Sample.Company 文件,你会看到一个名为“Mission”的字段,其中包含伪随机生成的文本。 假设我们要搜索这个文本字段。 为了进行本练习,我生成了大约 256,246 家公司——你可以自行添加一些数据并跟着操作。那么,你可能会运行以下查询:

SELECT * FROM Sample.Company WHERE Mission LIKE ‘% agile %’

这是一个相当合理的查询,但其性能如何呢?显然,在没有索引的情况下,系统必须读取每一条记录,因此我们返回的 7854 行数据产生了 256,277 次全局引用。这表现并不理想! 让我们为 Sample.
0
0 0
文章 John Pan · 8 分鐘 前 6m read

Health Connect 中的高性能消息搜索

问题

您是否曾在繁忙的界面中尝试使用“消息查看器”进行搜索,却因查询超时而失败?随着数据量的增加,这可能会成为一个相当严重的问题。举个例子,我正在处理的 Health Connect 实例每天处理约 1.55 亿条消息头,且消息保留期为 21 天。 为提升搜索性能,我们扩展了内置的 SearchTable,添加了常用字段,希望通过为这些字段建立索引来加快查询速度。尽管如此,某些查询仍然无法完成。

更多信息:定义搜索表类。

image

对于我们这些从事 HL7 集成工作的人员来说,我们深知日常的故障排查和问题响应是我们工作的重要组成部分。 快速识别并解决这些问题,对于确保数据流的稳定和准确至关重要。由于搜索性能不佳,我们不得不针对每个具体问题收集非常详细的信息,才能在 Health Connect 中找到相关示例。 如果没有非常严格的时间限制(几分钟内),我们往往无法在超时之前让“消息查看器”搜索返回任何结果。这导致在确定实际问题以及后续解决问题方面都出现了显著延迟。

解决方案

这种情况是不可接受的,因此我们必须找到解决方案,以更好地服务客户。WRC应运而生。

我们提交了一份工单,我很高兴地报告,已经找到了修复方案。该方案需要遍历我们自定义的 SearchTable 字段,并识别出哪些字段的唯一性不足,因此不应被“消息查看器”搜索功能作为索引处理。

0
0 1
文章 cheng yu · 35 分鐘 前 2m read

我之前关于SQLgateway 迁移的系列文章,是一篇篇幅较长的文章,介绍了
了可用的各种方案。不过它既不易操作,又难以追踪。
因此,我的挑战是:如何“吃掉一头大象”?>> 把它切成小块!!

我的目标是兼顾两点:既能独立创建每个容器,又能
同时支持一键构建整个集合。因此现在可以
在不影响其他容器的情况下修复单个容器的问题。

结果证明,这变成了一次关于 Docker 网络和脚本编写的实践,

  • 每次执行 Docker-Compose Up 都会创建一个独立的网络。因此,与
    前面的示例那样简单地启动,也会生成8个彼此隔离的网络。
    解决方案:定义一个公共网络并将容器加入其中。
    现在 TCP/JDBC 可以找到服务器,而且我们再也不会遇到端口冲突了
  • 为了启动所有容器而连续执行 8 次 `docker-compose up -d` 实在不太好玩 
  • 解决方案:Docker Compose 提供了一个 INCLUDE 指令。只需点击一下,一切就搞定了。
include:   
  - ./iris1/docker-compose.yml   
  - ./cache/docker-compose.yml    
  - ./ibmDB2/docker-compose.yml   
  - ./iris2/docker-compose.yml    
  - ./MSsql/docker-compose.yml   
  - ./mysql/docker-compose.yml   
  - ./ORACLE/docker-compose.yml   
  - ./postgres/docker-compose.yml
0
0 2
文章 cheng yu · 1 小时 前 2m read

与图片中提到的电影(对于不了解的人来说,就是1999年的《黑客帝国》)不同,在动态SQL和嵌入式SQL之间做出选择,并非在现实与幻想之间抉择,但这仍然是一个需要做出的决定。下面,我将尝试帮助您更轻松地做出选择。

如果您的需求是客户端与应用程序(进而与数据库)之间的交互,那么动态 SQL 可能更合适,因为它能非常轻松地“适应”这些查询变化。然而,这种动态性是有代价的:每次新的查询都会重新构建,这可能会导致更高的执行成本。下面是一个简单的 Python 代码片段示例。

0
0 2
文章 cheng yu · 十一月 4 8m read

这是两篇系列文章中的第二篇,我将带您逐步了解:

  • 第一部分——简介与快速导览(上一篇文章)
    • 这是什么?
    • 部署 InterSystems IRIS Cloud Document
    • 通过服务用户界面快速浏览该服务
  • 第二部分——示例(基于 Docker 的)Java 应用程序(本文)
    • 获取连接详细信息和 TLS 证书
    • 审阅一个简单的 Java 示例,该示例用于创建集合、插入文档并查询文档
    • 配置并运行 Java(Docker 化)端到端示例

如前所述,我们的目标是为您提供流畅的“首次运行”体验。

0
0 7
文章 John Pan · 十一月 4 7m read

Supabase 是一款基于 Postgres 的流行后端即服务(BaaS)平台。它为您的数据表提供了 API、身份验证、Studio 以及 Edge Functions 功能。然而,大量有价值的数据存储在InterSystems IRIS中, 且不会迁移。 本文将介绍iris-supabase-fdw,这是我针对社区奖励计划*“从创意到应用”(第三轮)*中Ideas Portal 创意“为 Supabase 添加 InterSystems 封装层”(DPI-I-663)所做的实现。 它使 IRIS 表在 Supabase 中以普通 Postgres 表的形式呈现,因此您可以对其进行查询、连接和 更新操作。

select p.name, a.startsat, a.doctor
from iris.appointment a
join iris.patient p on p.id = a.patient
where p.city = 'Roma' and a.status = 'scheduled';

iris.appointment 和 iris.patient 是 IRIS 表。数据绝不会被复制。

0
0 8
文章 Nicky Zhu · 十一月 3 6m read

在上一篇中,Agent B 根据集成需求提出了组件拓扑。但这份设计还不是 IRIS Production,也不是正在运行的配置。它还需要参数化、渲染、编译并启动。

本文沿着这段转换过程展开,并以 SQL→SOAP 管道为例说明。需要先划清边界:Production 能编译并启动,并不能单凭这一点证明每条消息都能正确转换并持久化到目标端。

1. 拓扑是设计,不是运行配置

拓扑描述管道中应该有哪些组件,以及它们之间的关系。一个组件条目可以包含组件类型、名称、IRIS 类、所属类别和设置。Agent B 提出组件构成与顺序;平台代码负责解析已登记的实现类,并补充与连接相关的配置。

以 SQL→SOAP 为例,拓扑可能包含 SQL Service、转换 BP 和 SOAP Operation。拓扑还必须提供 IRIS 实例化这些组件所需的配置:例如 SQL 端的 JDBC DSN 和查询语句、目标 WSDL 导入生成的 BO 类,以及目标端点。

平台不会要求 Agent B 凭空发明这些部署细节。它会对 AI 输出进行归一化,根据已登记的模板和当前连接信息补充参数,检查完整性,并在适用时补齐必需组件。多管道请求会将各组整合到 Production 拓扑中,同时保留仍符合并入条件、且本次未替换的既有管道组。

2. 根据拓扑渲染一个 Production

后端会保存供 IRIS 使用的有效拓扑。demo.PipelineGenerator

0
0 10
文章 John Pan · 十一月 3 5m read

在构建应用时,我们可能同时使用 Supabase 和 InterSystems IRIS:前者为应用提供基于 PostgreSQL 的后端服务,后者保存现有业务系统中的数据。如何让 PostgreSQL 查询到 IRIS 中的数据,是两套系统协作时经常遇到的问题。

iris-wasm-fdw 是一个面向这一场景的实验性项目。它使用 Supabase Wrappers 的 WebAssembly 外部数据包装器机制,通过 IRIS Atelier HTTP/JSON API 执行预先配置的 SQL,并将结果映射为 PostgreSQL 外部表。

项目目前适合结果集可控的只读查询和小规模试用。本文介绍它的工作方式、基本配置以及使用时需要注意的限制。

什么是 Wasm FDW?

PostgreSQL 的外部数据包装器(Foreign Data Wrapper,简称 FDW)允许用户将外部数据源映射为外部表。应用查询外部表时,包装器负责访问数据源并返回结果。

Supabase Wrappers 为这一机制提供了 WebAssembly 支持。开发者可以构建 Wasm 组件,由 Wrappers 扩展在 PostgreSQL 中加载;组件通过宿主提供的接口访问 HTTP API,并将数据交还给 PostgreSQL。

0
0 6
文章 cheng yu · 十一月 3 2m read

InterSystems IRIS 和 IRIS for Health 2026.1 的新功能

InterSystems IRIS 2026.1现已发布,其中包含众多强大的增强功能,旨在帮助组织以前所未有的方式扩展其数据管理能力。 无论您是处理海量数据集的管理运营工作,还是希望优化存储成本,此版本都提供了一系列功能,旨在简化您的数据管理流程,并应对超大规模数据集带来的日益严峻的挑战。 

扩展的数据库容量

得益于扩展的块寻址机制,我们将最大数据库容量从 32 太字节 (TB) 大幅提升至令人惊叹的 8 拍字节 (8 PB,采用 8k 块),远超以往的上限。 我们采用的方法无需进行中断服务的迁移,即可将您的数据库透明地切换到新的“扩展数据库大小”格式——只需进行例行完整性检查,即可确保系统平稳运行。不过,旧版实例无法识别新的块编号方案,因此我们将此功能作为可选功能推出。更多详情请参阅发布说明。

多卷数据库

告别笨重且庞大的数据库文件。借助多卷数据库(MVDB),IRIS 会随着数据增长自动创建新的物理文件,因此您无需担心管理巨型文件或手动放置数据。 该功能无缝、透明且设计简洁,将逻辑数据库大小与物理文件限制解耦。特别是当您需要使用上述“扩展数据库大小”功能时,MVDB 是保持文件规模可控的必备功能。

0
0 13
文章 John Pan · 十一月 2 6m read

向InterSystems西班牙语开发者社区的所有尊贵成员问好!

虽然我经常查阅开发者社区的内容,也偶尔在这里提问,但这将是我发表的第一篇文章,而参加第三届技术文章大赛无疑是发表首篇文章的最佳契机。

本文将探讨 InterSystems IRIS 为我们提供的各种工具,这些工具既能优化数据库,也能优化我们执行的查询,同时还将介绍新型存储和数据类型。

优化我们的 SQL 查询

为了撰写本文,我在一个 InterSystems IRIS Community 实例中搭建了一个小型示例,导入了一个 CSV 文件,其中包含 500 万条记录,这些记录模拟了多年来在不同城市进行的假想销售数据。

表结构将非常简单,但足以满足我们所需的测试。请原谅这些名称,但您也知道,没有什么比临时解决方案更持久的了。

Sales.Record

Sales.Record

月销售额 城市代码 Anyo 月份
454323 1 1995 3
... ... ... ...

竞赛.地点

城市代码 城市 自治区代码 自治区
1 巴利亚多利德 1 卡斯蒂利亚-莱昂
... ...    

我们将尝试提取像巴利亚多利德这样的城市在某一年的历史平均销售额:

让我们看看查询返回月平均销售额需要多长时间:

结果显示,返回月平均销售额耗时略超过8秒。

0
0 7
文章 John Pan · 十一月 2 30m read

一个基于FHIR的自然语言代理,完全构建于IRIS for Health之上:数据处理采用FHIR SQL, 术语处理采用向量搜索,并以互操作性生产环境作为代理的运行时环境。 一个真实的问题,通过18条消息的追踪记录,以及该追踪记录揭示了这些 代理在哪些方面真正成功、又在哪些方面失败。


  1. 临床文本到SQL技术的发展历程

这项任务看似已成定局。临床医生用英语提出问题,模型生成SQL语句, 数据库给出答案。相关基准测试已存在多年,该领域通过这些测试取得的进展 值得关注,因为每一步都将难点推向了新的领域。

EHRSQL [5]确立了基准——这是一个基于真实 电子健康记录(EHR)模式的大型实用文本转SQL基准测试,其问题均来自医院工作人员的实际提问。该基准证实, 难点不在于SQL语法,而在于对模式的掌握:只要知道 上百张表中哪一张存储了什么数据,这些问题就能得到解答。

随后,目标转向了FHIR。FHIR-AgentBench [6]针对真实的FHIR资源重新提出了EHRSQL风格的 问题,并报告称,回答每个问题平均需要 14.5个FHIR资源。 难点已从*“该选哪个定制表”转变为“如何遍历一个标准化但深度嵌套的模型”*。 而EHR-ChatQA [7]则实现了多轮交互,同时指出了那些 SQL 风格的基准测试 一直以来默默隐藏的难点:术语不匹配。

0
0 9
文章 Nicky Zhu · 十月 28 6m read

上一篇讨论了 AI 如何提出源数据到目标字段的映射建议。但映射本身并没有说明:运行中的集成如何读取一行数据、转换一条消息,或把请求投递到目标。

接下来要回答的是:应该由哪些组件来完成集成?这些组件又该如何组合?

在 DataPipelineDemo 中,管道规划师 Agent B 并不是从空白开始设计。平台会向它提供一组受控的组件类型、相关的管道设计知识,以及当前请求的集成需求。Agent B 根据这些上下文提出拓扑,平台再补充配置并检查结果是否可用。

本文沿着这条运行时路径展开。如何由开发者构建和登记组件定义、设计 Skill,将留给后续的开发者专题。

1. 映射和拓扑回答不同问题

已确认的转换映射描述信息应该如何对应。例如,如何把 SQL 中的 FamilyName 和 GivenName 组合成 SOAP 请求中的 FullName。

管道拓扑描述执行集成所需的组件,以及它们之间的关系。典型的 SQL→SOAP 数据流中,SQL Service 读取数据行,转换流程准备请求,SOAP Operation 再将请求发送到目标。

这两者缺一不可。映射合理,不代表已经具备数据流转路径;组件连接有效,也不能证明映射后的值符合业务语义。

2. 两类能力上下文

Agent B 会接收两类预先准备好的能力信息,它们回答的是相关但不同的问题。

类型注册表:有哪些可用组件类型?

0
0 14
文章 Nicky Zhu · 十月 20 7m read

如果源表里有一列 FamilyName,而目标接口需要 FullName,集成程序应该怎么办?

可以因为两者都是文本,就把一个字段直接复制给另一个字段;也可以因为名称不同,就认为它们无法对应;还可以判断目标值可能需要由两个源字段组合而成——再确认这种理解是否符合当前集成场景。

这正是“匹配字段名称”和“设计数据映射”的区别。在 DataPipelineDemo 中,AI 会提出源数据与目标之间可能的对应关系;验证流程根据已有事实和约束检查这些建议;用户再审阅结果,并决定是否保存供后续管道生成使用。

1. 一条映射究竟说明什么?

这里有两个相关但不同层次的匹配:

  • 资产匹配:哪个源对象应该对应哪个目标对象?例如,哪张 SQL 表或哪类 FHIR 资源应输入某个目标实体或资源。
  • 字段映射:哪个源值应提供给某个目标字段?传递过程中是否需要转换?

因此,字段映射不只是两个名称的配对。它可以表示直接传值、组合多个值、提供常量,或执行术语映射等受控转换。源路径和目标路径固然重要,映射表达的意图同样重要。

2. 从相似名称到有意义的数据对应

字段名称是有用线索,但不能证明两个字段含义相同。两个都叫 Code 的字段可能属于不同编码体系或业务概念;名称不同的字段也可能表达同一个标识符。

结构和约束能补充更多上下文。目标可能要求必须提供某个值;字段可能需要日期、编码、引用或特定的 FHIR 路径。

0
0 45
文章 Nicky Zhu · 十月 15 8m read

连接测试可以告诉我们服务器有响应,数据库结构可以告诉我们某列名叫 Code。但仅凭这两点,我们仍不知道这个编码代表什么,也不知道它是否应该映射到某个目标字段。

可靠的数据集成设计,要从这里开始。在决定哪个源资产对应哪个目标、哪些组件应组成一条数据管道之前,我们需要先理解接口——不只是接口的结构,还要理解这些结构在具体场景中的含义。

本文介绍 DataPipelineDemo 在 InterSystems IRIS for Health 上如何处理这个问题。核心原则是语义优先:先理解接口表达的含义,再做映射与管道设计决策。

这里的“语义优先”指的是下游决策顺序,并不是先让 AI 凭空猜测、再去看接口。实际流程是先采集结构和运行事实,再由大语言模型(LLM)基于这些事实进行解释,最后将分析结果作为后续决策的上下文。

1. 端点可达,不等于接口已理解

连通性是必要条件,但它回答的问题很有限:当前应用能否访问这个端点?

它无法证明:

  • 某张源表或某类 FHIR 资源在业务领域中代表什么;
  • 某个字段是标识符、状态、编码值,还是显示名称;
  • 某个操作用于读取数据,还是用于接收并写入数据;
  • 端点是否支持增量读取或特定的投递机制;
  • 结构上合法的映射是否保留了原本想表达的业务含义。

这些问题不同,需要的证据也不同。

0
0 55
文章 Nicky Zhu · 十月 12 11m read

LLM 可以建议把某个源字段映射到某个目标字段。这很有用,但还不能称为完成了一次数据集成。

接下来,还需要建立连接、理解目标约束、选择并连接组件、启动管道,以及检查数据到底有没有正确到达目标。

Quickstart 介绍了运行在 InterSystems IRIS for Health 上的 DataPipelineDemo。这一篇往前走一步:解释集成需求与平台能力,如何共同变成一条可运行、可验证的数据管道。

核心并不是“让 AI 写出所有东西”,而是:

让 AI 在明确边界内做集成决策,再让这些决策能够被执行、被观察、被验证。

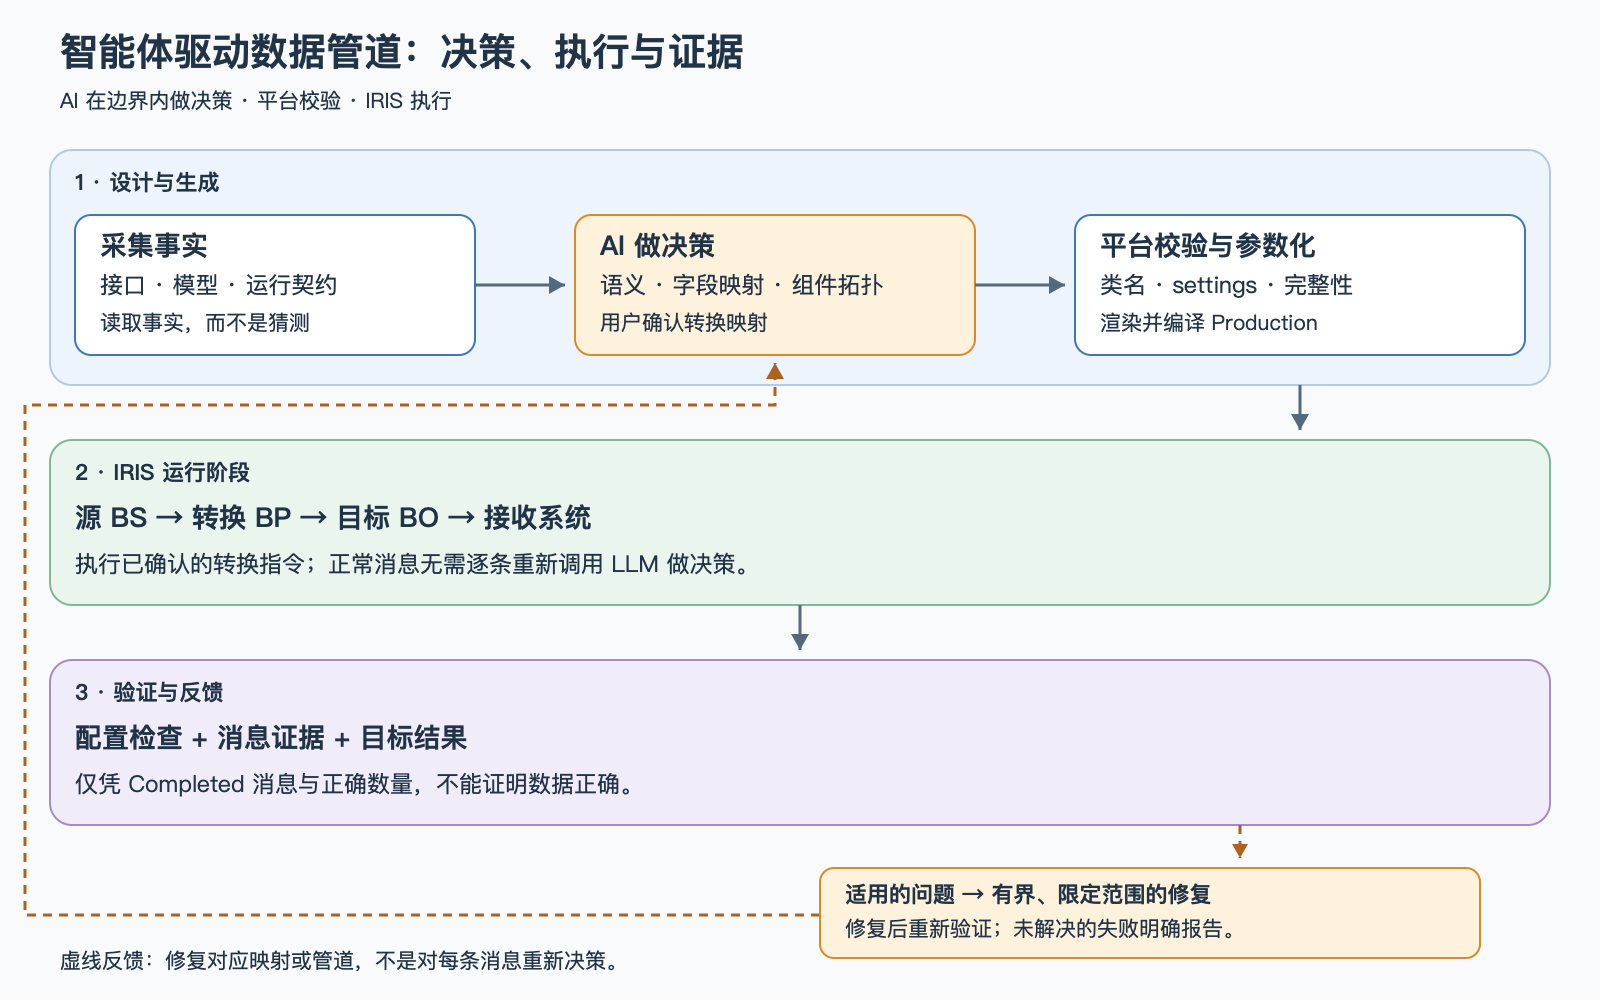
1. 一个系统,三个阶段

整体链路可以概括为:

设计、运行与验证反馈

图 1:三个阶段;虚线反馈表示按适用路径做限定范围的修复,然后重新验证。

但这条链路包含三个不同的阶段。

设计与生成阶段,产出接口模型、字段映射、组件拓扑和 Production 定义。AI 参与语义分析、转换映射与管道规划。

运行阶段,源数据通过业务服务、转换流程和目标操作流转。已有组件执行确认后的转换指令,正常数据链路不会为每一行数据或每一条 FHIR 资源重新调用 LLM 做语义判断。

验证与反馈阶段,检查生成配置与运行证据;发现问题后,按适用路径修复映射或管道,再次验证。

这一区分很重要:AI 参与决策,IRIS 承担运行。例如,消息处理过程中查询术语映射,查的是术语服务器,并不是每次都让 LLM 重新判码。

2.

0
0 36
公告 Jeff Liu · 九月 27

本次发布的目标很简单:让使用 InterSystems IRIS 和 Caché 的日常工作变得更轻松一些。
以下是五大主要变更。
- Query Cloud 现可在单个查询中连接多个数据库
SQL Data Lens 利用 Apache Calcite 实现跨不同数据源的联合查询,同时尽可能将过滤、连接和聚合操作下推至各系统。
IRIS + PostgreSQL + 一个装满 CSV 文件的文件夹。
一条 SQL 语句。
- 现在可以搜索 SQL 历史记录
旧式的按日分类树形结构已不复存在。
历史记录条目支持排序、筛选、置顶和导出。失败和已取消的语句现也已包含在内,这使得故障排查变得更加容易。
- SQL 扫描器能检测出更多问题
外键分析现已支持 IRIS 和 Caché。
新增的统计信息检查功能可帮助识别过时的优化器统计信息,且索引建议会考虑实际列的基数。
每项检测结果均附有说明及建议的 SQL 语句。
- 一键从表导航至类和全局变量
类名和全局变量名现已成为超链接。
微小的改动,却出乎意料地实用。
- 执行计划终于变得易于阅读
纯文本形式。可选中。可搜索。可复制。
支持 DuckDB、PostgreSQL 和 SQL Server,Query Cloud 还能通过“显示联合执行计划”功能解释其自身的联合执行策略。

0
0 63
InterSystems 官方 Claire Zheng · 九月 21

InterSystems 宣布推出第四个预览版,作为 2026.3 版本开发者预览计划的一部分。该版本将包含 InterSystems IRIS® 数据平台、InterSystems IRIS® for Health™ 以及InterSystems Health Connect™。

亮点

2026.3 版本中已新增多项更新和增强功能:

  • 对 更多 SQL 表类型提供了更广泛的 表分区支持 。 
  • 新增 Config Store 功能,可通过安全钱包管理应用程序配置和密钥。
  • 优化了云原生运维能力,并对容器相关可观测性进行了调整。 

初始文档可通过以下链接查阅。这些文档将在未来几周内持续更新,直至正式发布(一般可用版 - GA):

未来的预览版本预计每两周更新一次,我们将根据功能开发进度陆续添加新特性。请通过开发者社区分享您的反馈,让我们共同打造更优质的产品。

早期访问计划 (EAP)

目前有多个 EAP 项目可供选择。请访问此页面,并注册您感兴趣的项目。

可用性与软件包信息

此版本提供了适用于所有受支持平台的经典安装包,以及 Docker 容器格式的容器镜像。完整列表请参阅《受支持平台》文档。

0
0 49
文章 Lilian Huang · 九月 14 14m read

简而言之

我们将基于 insightsoftware 的 Logi Report(包含 Designer 和 Server)构建的 InterSystems Reports 连接到生产环境中的 InterSystems IRIS 实例,从而能够基于 IRIS SQL 视图生成带有品牌标识的、按计划生成的 PDF 和 Excel 报表。 本文是一份我们希望在项目启动之初就拥有的分步指南:基于最小权限原则的 IRIS 配置、可靠的 JDBC 配置、作为 IRIS 与报表层之间接口的 SQL 视图,以及通过 CSS 集中管理品牌样式并配合报表模板。 关于工具本身,我们的主要经验是:尽管报告文件可以作为代码进行编辑,但 Designer 用户界面应作为默认选择——直接文件编辑应仅用于您已深入理解的功能。每个步骤都包含使我们能够重复进行设置的实用技巧。


本文适用对象

本指南面向需要通过第三方报表工具公开 IRIS 数据(以我们的案例为例,即医疗保健付款数据)的 IRIS 开发人员和集成工程师,且希望在开始之前就明确连接、建模和模板化的相关决策。


关于我们方法的说明:代码编辑与 Designer 的对比

InterSystems Reports 将报告、目录和样式表存储为可编辑文件,因此您在“设计器”中能完成的所有操作,在文本编辑器中同样可以实现。因此,我们特意深入探索了这一功能,以找出其极限。

0
0 57
文章 Nicky Zhu · 八月 29 3m read

IRIS数据建模的决策框架。

关于选用哪种模型的决策涉及多方面因素。 我建议分别对每个维度进行评分,然后将结果相乘。 根据您偏好的评分方式,得分最高或最低的模型胜出。 我看到了这些维度,但具体方面可能会使列表进一步扩展。

  • 开发人员在 SQL、面向对象和Globals方面的技能
  • 维护人员和运维人员在 SQL、面向对象和Globals方面的技能
  • 与 SQL、面向对象、Globals相关的数据文化
    • 我曾遇到过完全拒绝使用SQL的客户
  • 开发和测试所需的时间
  • 需存储在SQL、面向对象和Globals中的结构复杂度
  • 访问速度
  • 存储消耗
  • 数据类型和质量检查
  • 对变更和增强的灵活性…… 
  • 更多

SQL的技术维度

  • 若仅包含简单列,生成 CREATE TABLE 语句的速度会很快

    • 但添加外键或引用其他表可能会带来挑战
  • 访问速度仅对大型表重要,且受以下因素影响

  • 存储空间消耗

    • 您可以将其完全交给代码生成器处理,几乎无需干预
    • 在后台,每张表都对应一个 Object 类
    • 以及一组可供使用的Globals
  • 要提高访问速度,需要巧妙地建立索引

  • 您可以对标准数据类型进行全面检查

  • 灵活性

    • 仅需添加一列便十分简单
    • 更复杂的更改可能会让人头疼不已

对象的技术维度

  • 利用现有的工具,创建一个对象类是一件轻而易举的事。

0
0 67
文章 Lilian Huang · 八月 28 10m read

本系列的第一部分。第二部分将介绍完整的工具目录。第三部分将介绍 ObjectScript 技能。第四部分将介绍基准测试以及如何衡量实际的改进效果。


隐藏在注释中的问题

托马斯·马祖尔(Thomas Mazur)关于 VS Code 生产力——Peacock、作用域工作区文件、Copilot 代理模式——的 博文《青蛙、鸡、AI 和 VS Code》 在评论区揭示了一个更尖锐的问题。皮耶特罗·迪·莱奥(Pietro Di Leo)和 Mike.W 指出,当你在 VS Code 中进行服务器端开发时, isfs:// 大多数 IRIS 生产环境所使用的“工作区”中,Copilot 只能看到编辑器中打开的文件,无法对虚拟文件系统进行索引。对于拥有数千个类的成熟 IRIS 应用程序而言,AI 的工作效果就像是透过钥匙孔观察一样。

John Murray 向大家推荐了我正在开发的项目——iris-agentic-dev——并指出目前开发者社区中尚无相关文章。因此,本文将阐述:该问题产生的原因、该工具如何解决该问题,以及如何在约五分钟内完成部署。


为什么 AI 无法“看到”你的命名空间

当你打开一个 isfs:// 工作区时,你的 IRIS 类存储在服务器上,而非本地磁盘。

0
0 51
文章 Nicky Zhu · 八月 19 17m read

处理遗留代码时的差异与注意事项

刚开始接触 ObjectScript 时,我编写的大部分代码都遵循了 InterSystems 的现代编程模式。我使用类、方法、REST 服务、互操作性生产、JSON 对象以及 %Status 值。

与此同时,我负责维护的生产系统中,很大一部分代码采用的编写风格却截然不同。

该系统使用了例程、标签、global、缩写命令、“点-do”语法、共享局部变量以及错误处理模式——这些在基于类的 ObjectScript 普及之前就已经存在了。

起初,我曾以为这仅仅是旧语法与新语法的区别。随着时间的推移,我意识到最大的差异并非表面上的。传统的MUMPS风格代码与现代ObjectScript在变量作用域、执行层级、数据流和错误处理方面往往基于不同的假设。这种区别至关重要,因为旧代码很容易被误读。

某个例程看似未接收任何参数,却依赖于调用者创建的多个变量;某个标签在某处表现得像一个过程,在另一处却表现得像一个函数;一个点块(dot block)虽然会创建另一个执行层级,却可能看起来像缩进;一段代码在移入类后虽然能编译通过,但在运行时却可能表现得截然不同。

代码看起来依然很熟悉。语言依然是 ObjectScript。然而,它可能已经发生了变化。

本文介绍了我在处理遗留代码并将其与更现代的 ObjectScript 应用程序集成时所遇到的一些最重要的差异。

1.

0
0 80
文章 Kelly Huang · 八月 13 7m read

如果你在开发者社区待过一段时间,就会发现许多问题以不同形式反复出现:如何将持久化对象转换为 JSON?如何遍历一个结构未知的 JSON 有效载荷? 为什么 Required 对我的 %DynamicArray 属性 没有任何作用 ?为什么我的日期会被返回为 31390 ? 

注意到这一点后,我们决定撰写一篇文章,总结所有那些仅凭文档无法解答的问题:实践。

让我们从基础开始

InterSystems IRIS 为无模式数据提供了两个类:%DynamicObject 和 %DynamicArray。它们都继承自 %DynamicAbstractObject,两者的实例均被称为动态实体。 它们与 JSON 映射得非常自然:对象是一组键值对,数组是有序列表。与持久化类或注册类不同,动态对象不保留预定义的有效属性名列表——任何字符串键都是合法的,并且可以在运行时添加或移除成员。

最令人愉悦的部分是字面量语法,对于来自 JavaScript 背景的开发者来说,这看起来会很熟悉:

你也可以逐个字段构建它们。 会返回其修改后的实体,因此可以进行调用链:

Set obj = {}.%Set("a",1).%Set("b",2) // now obj is {"a":1,"b":2}

Do scores.%Push(100)          		 // now scores is [90, 85, 77, 100]

Set last = scores.%Pop()      		 // now scores is [90, 85, 77] and last is 100
0
0 116
文章 Lilian Huang · 七月 26 12m read
  1. 引言

流行病学监测是公共卫生的基石之一。 Régis Júnior等人(2026)将其定义为一个针对健康事件的持续性数据收集、分析、解读和传播系统——该功能的有效性在很大程度上取决于信息系统的质量、数据分析能力以及不同医疗层级之间的协调。 在新冠疫情期间,这一职能的战略重要性已毋庸置疑:世界卫生组织(2021)的记录显示,拥有更健全监测系统的国家始终表现得更好,而监测能力方面的区域差异则直接导致了应对措施的不一致,并在发病率和死亡率方面产生了可测量的差异。

尽管医疗系统如今能够收集海量的标准化临床数据,但挑战在于如何将这些数据转化为及时且可付诸行动的洞见。传统的流行病学报告往往依赖于人工分析和定制数据库查询,由此产生的延迟可能会阻碍公共卫生部门的快速响应。

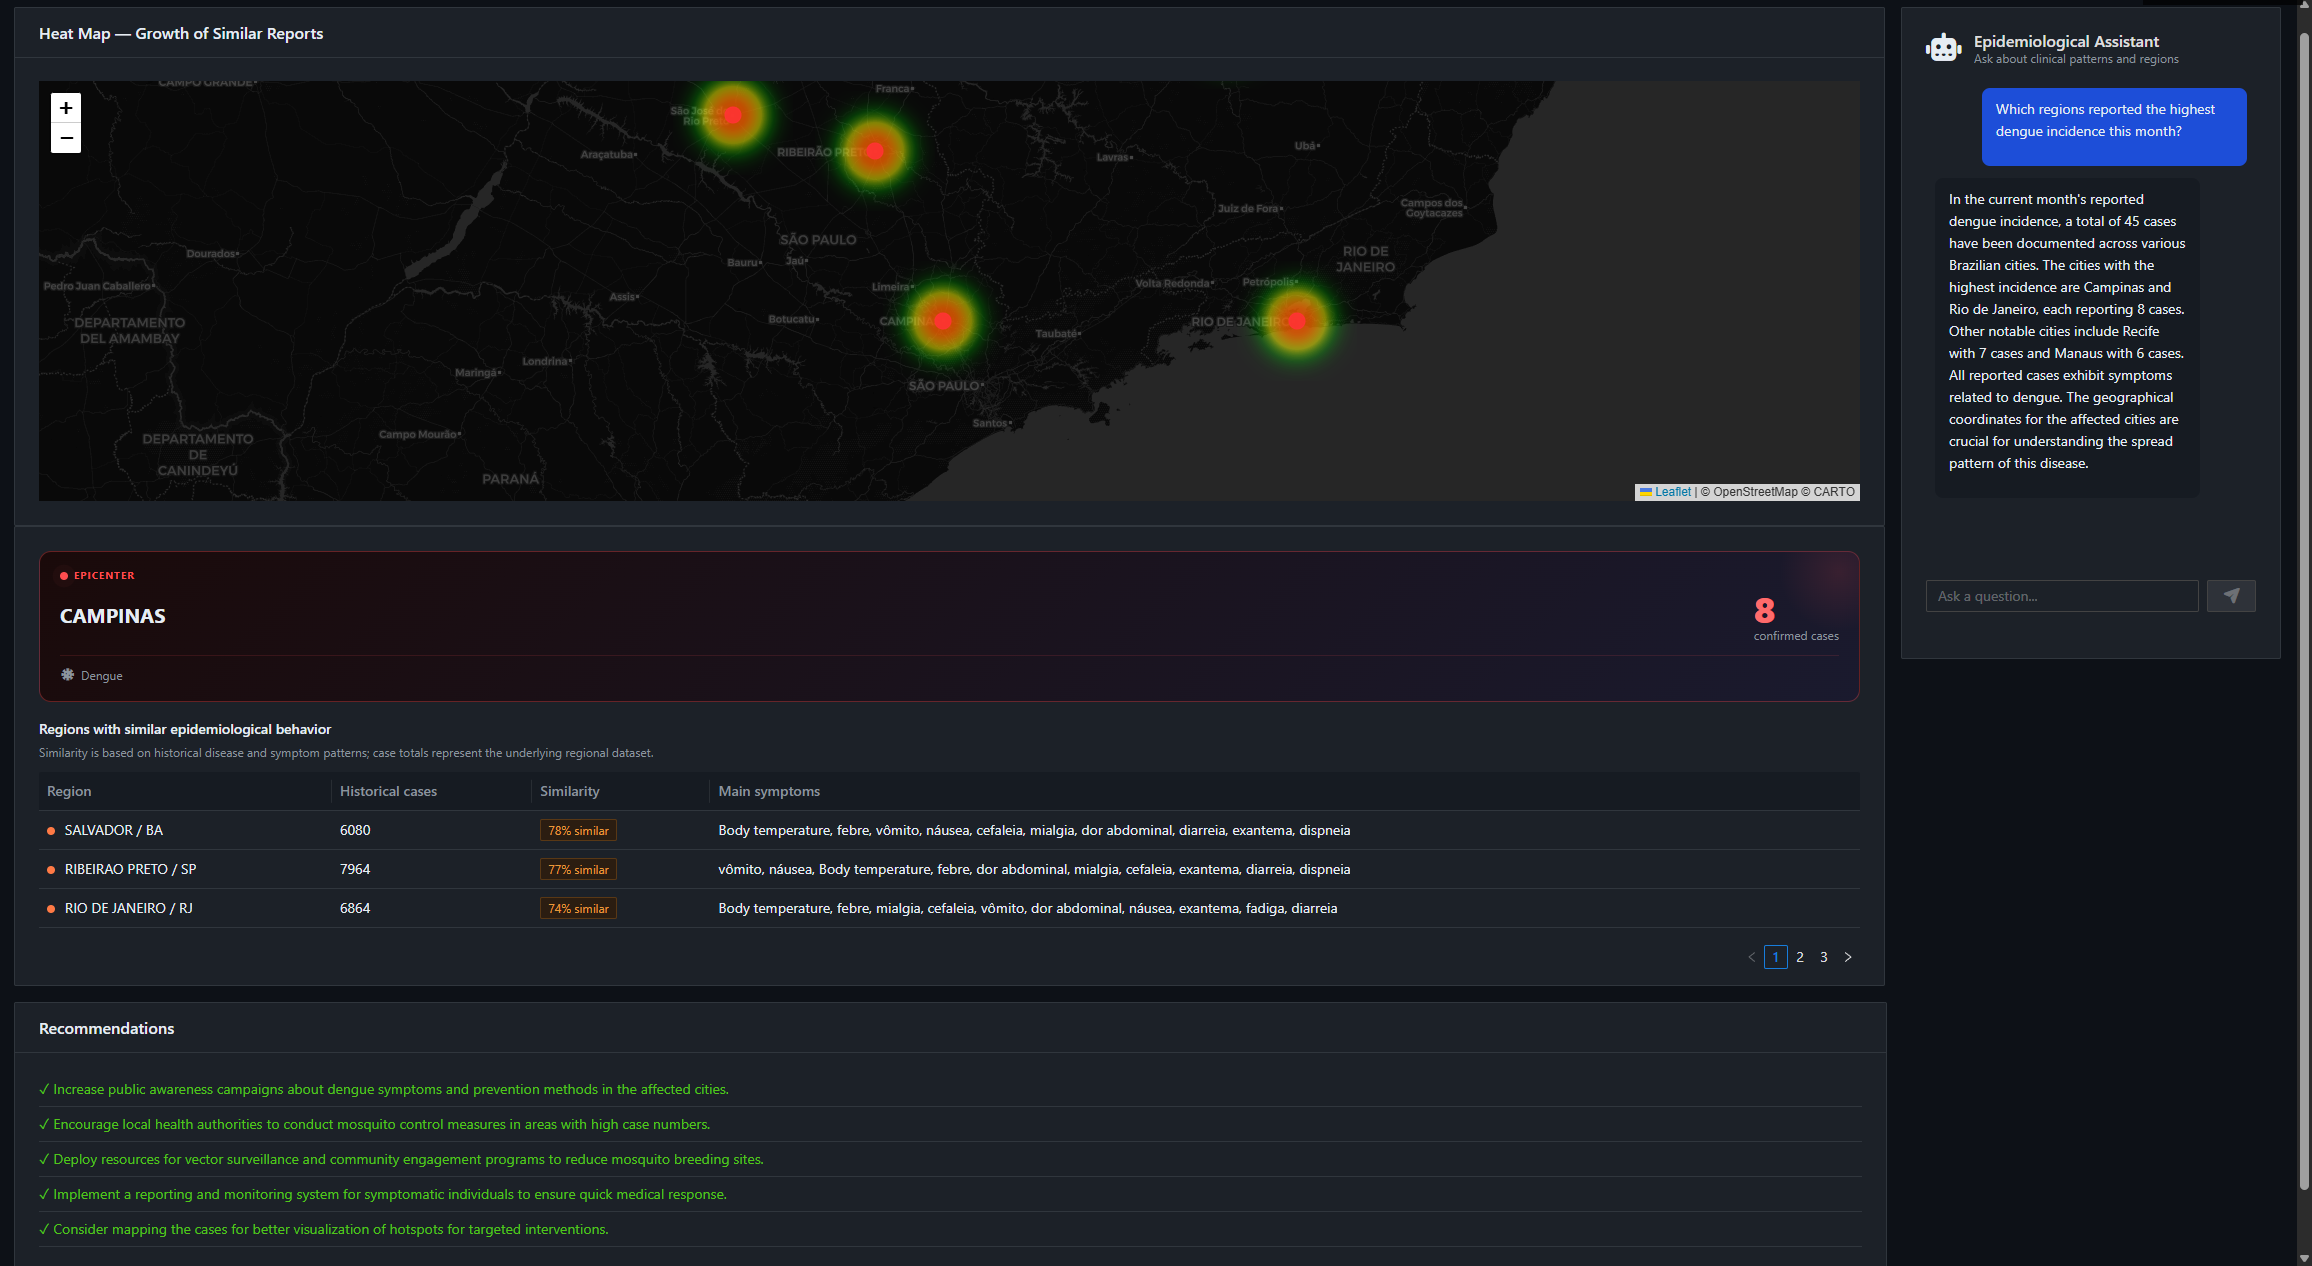
EpInsights通过整合 InterSystems IRIS for Health、嵌入式 Python 临床向量化技术、IRIS Vector Search 以及 LangChain4j 对话式智能助手,填补了这一空白。 该平台使流行病学家和卫生管理者能够提出自然语言问题,并即时获得基于真实FHIR数据的地理空间热力图、区域排名、相似聚类检测以及AI生成的建议,所有结果均在数秒内呈现。


  •  
  1. 架构概述

EpInsights 采用三层架构,各层职责划分明确。

0
0 83
文章 Lilian Huang · 七月 10 8m read

大多数“AI 代理 + FHIR”项目最终都呈现出相同的架构:这边是一个 FHIR 服务器,那边是一个向量数据库,中间则是一个 Python 服务,其职责是调用嵌入 API、在两端之间转换浮点数数组,并保持两个数据存储库的同步。 三个活动组件、两次网络跳转,以及一个你从此永久拥有的嵌入式客户端。

Triage Park:我们 提交给InterSystems 编程大赛:FHIR AI Agent的参赛作品,完全没有这些复杂结构。该代理从不计算嵌入向量,也从未导入过 OpenAI 嵌入向量客户端。 没有向量数据库。它将原始文本发送给 IRIS,剩下的工作由 IRIS 完成:它在服务器端计算嵌入向量,并通过针对与 FHIR 存储库位于同一数据库*中的表执行单条 VECTOR_COSINE SQL 语句来响应检索请求。

这就是 IRIS for Health 的“AI Hub”模式,一旦我采用该模式,我自己的代码中整整一层就消失了。以下是它的具体工作原理。

问题在于:分诊人员需要快速获得指导方针

Triage Park 是一款对话式分诊助手。患者描述症状(“我上楼梯时胸口发紧”),由大型语言模型(LLM)支持的助手会读取患者的真实 FHIR 病历,并生成分诊决策:自我护理 / 看全科医生 / 急诊护理 / 急诊科,同时附上依据说明。

“引用依据”(Cited rationale)是关键所在。

0
0 98
文章 Kelly Huang · 七月 9 5m read

在开始开发“智能出院导航器(Smart Discharge Navigator)”时,我遇到了一个常见的难题:FHIR 数据以 JSON 数据包的形式存储,但我所需的分析需要将多个资源进行关联,而这正是 SQL 所擅长的领域。

InterSystems FHIR SQL Builder 彻底解决了这一问题。我无需在应用程序代码中解析 JSON 数据包,而是能够直接在 IRIS for Health 中针对 FHIR 资源投影编写纯 SQL 语句。本文将详细介绍我如何利用该工具构建了该应用程序核心——基于人群的再入院风险评分引擎。


临床问题

30 天内的医院再入院是医疗保健领域成本最高且本可预防的问题之一,每年给美国医疗系统造成 170 亿美元的损失。挑战并不在于事后识别风险因素,而在于在恰当的时机——即患者出院前——及时发现这些风险因素。

为了评估再入院风险,我需要针对每位患者同时回答以下五个问题:

  • 该患者近期住院过几次?
  • 该患者是否患有多种活动性慢性病?
  • 该患者目前是否正在服用五种或更多种药物(多药联用)?
  • 病历中是否有任何异常实验室检查结果?
  • 是否有缺席随访的情况?

如果通过 Python 解析 FHIR 数据包来回答这五个问题,不仅速度慢,而且容易出错。而 FHIR SQL Builder 则让这一切变得简单明了。


0
0 156
文章 Claire Zheng · 七月 8 12m read

摘要

常见表表达式(CTE)为在SQL语句中定义可重用的中间结果集提供了一个结构化的框架。InterSystems IRIS通过WITH子句实现CTE,在与IRIS基于成本的优化器完全集成的情况下,既能实现更清晰的查询构建,又能支持模块化的分析处理。

本文探讨了 InterSystems IRIS 中 CTE 的语义,解释了其与查询优化的交互关系,讨论了合适的部署场景,并提供了可执行的示例,以说明生产环境中的实用模式。


  1. 引言

复杂的 SQL 工作负载通常需要多个逻辑处理阶段(例如过滤、聚合、数据增强和投影)。如果没有抽象机制,这些操作往往会导致查询结构深度嵌套,难以理解和维护。

常见表表达式(CTE)通过允许开发人员定义可在单个 SQL 语句中求值的命名查询组件,解决了这一问题。

在 InterSystems IRIS 中,CTE 通过 SQL 的 WITH 子句实现,并作为逻辑查询表达式运行,与周围的语句一同进行优化 [1]。


  1. InterSystems IRIS 中的常见表表达式

2.1 定义

公共表表达式(Common Table Expression)是在 SELECT 语句之前声明的命名子查询:

WITH PersonSubset AS (
  SELECT ID, Name, Age
  FROM Sample.Person
)
SELECT Name
FROM PersonSubset
0
0 115
文章 Claire Zheng · 七月 6 15m read

太长不读版(TL;DR:):本文演示了如何利用iris-vector-graph包,完全在 InterSystems IRIS 环境中实现 GraphRAG 风格的混合检索——该方法结合了向量相似度、图遍历和全文搜索。 我们通过一个欺诈检测场景,展示了图模式如何揭示仅靠向量搜索无法发现的问题。


为何欺诈检测需要图技术

每年,企业和消费者因欺诈损失数十亿美元。仅在2024年,消费者报告的损失就达125亿美元——同比增幅达25%。 现代欺诈之所以难以被发现,是因为欺诈者很少单独行动。他们通过有组织的网络运作,实施协调一致的骗局,利用我们无法察觉看似无关的交易之间存在关联这一弱点。

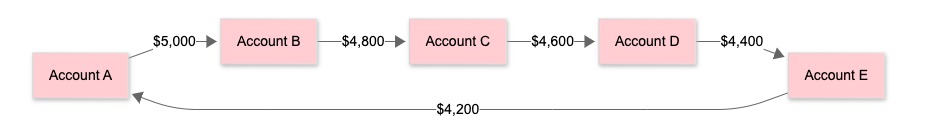
举个简单的例子:从账户 A 转账至账户 B 的单笔交易看起来完全正常。金额合理,时间点符合常规,且两个账户均未被标记为可疑。传统的基于规则的系统,甚至那些孤立分析交易的机器学习模型,都会毫不犹豫地批准这笔交易。

但如果我们能看到全局呢?

image

同一笔交易其实是环形模式的一部分——资金在循环流动,每一步都会被截留一小部分。这是一种典型的洗钱结构,对于任何不分析交易关联性的系统来说,都是隐形的。

这一洞见——即欺诈隐藏在关联关系中,而非单个记录中——正是图数据库成为欺诈检测不可或缺工具的原因。

0
0 120
文章 Nicky Zhu · 六月 17 8m read

在上一篇文章中,我们探讨了 IRIS 中单元测试的基础知识以及将其应用于 REST API 的方法。我们甚至还了解了如何在最终确定网络配置和身份验证之前测试逻辑,从而使我们能够专注于测试 API 内容。

今天,我们将在此基础上使用另一个工具来提升我们的单元测试策略:%Populate。

乍一看,%Populate类似乎非常简单。你可以创建一个同时扩展了 %Persistent和 %Populate的类,并继承一个用于生成随机记录的 方法。该工具可识别某些字段名称(如 "Name"、"SSN" 和 "Phone"),并应用专门的逻辑来确保数据的真实性。如果某个字段名称没有被识别为特殊字段名称,就会按照其指定的数据类型填充随机值。

假设我们开发了这样一个具有以下属性的类,用来跟踪商店中一些基本的客户信息(我们的类还扩展了 ,这在后面会派上用场):

Class User.CustomerList Extends (%Persistent, %Populate, %JSON.Adaptor)
{
    Property Name As %String;
    Property DOB As %Date;
    Property Age As %Numeric(SCALE = 0);
    Property IsMember As %Boolean;
    Property MemberID As %String(POPSPEC = ".GenID()");
}
0
0 181
文章 Claire Zheng · 六月 16 7m read

大家好,

你是否曾希望你的电子健康记录(EHR)能具备思考能力?不仅仅是显示数据,也不仅仅是触发警报。而是能够真正阅读病历、综合临床指南进行分析,并根据临床医生的单条信息,向系统生成结构化的转诊医嘱。

在本文中,我将向大家展示如何创建您自己的定制临床AI助手。


🏥 关于 iris-fhir-agents 应用

iris-fhir-agents是一个完全基于 InterSystems IRIS for Health 构建的多智能体临床 AI 平台

0
0 118