向FHIR存储库提出临床问题,并能核对答案
一个基于FHIR的自然语言代理,完全构建于IRIS for Health之上:数据处理采用FHIR SQL, 术语处理采用向量搜索,并以互操作性生产环境作为代理的运行时环境。 一个真实的问题,通过18条消息的追踪记录,以及该追踪记录揭示了这些 代理在哪些方面真正成功、又在哪些方面失败。
- 临床文本到SQL技术的发展历程
这项任务看似已成定局。临床医生用英语提出问题,模型生成SQL语句, 数据库给出答案。相关基准测试已存在多年,该领域通过这些测试取得的进展 值得关注,因为每一步都将难点推向了新的领域。
EHRSQL [5]确立了基准——这是一个基于真实 电子健康记录(EHR)模式的大型实用文本转SQL基准测试,其问题均来自医院工作人员的实际提问。该基准证实, 难点不在于SQL语法,而在于对模式的掌握:只要知道 上百张表中哪一张存储了什么数据,这些问题就能得到解答。
随后,目标转向了FHIR。FHIR-AgentBench [6]针对真实的FHIR资源重新提出了EHRSQL风格的 问题,并报告称,回答每个问题平均需要 14.5个FHIR资源。 难点已从*“该选哪个定制表”转变为“如何遍历一个标准化但深度嵌套的模型”*。 而EHR-ChatQA [7]则实现了多轮交互,同时指出了那些 SQL 风格的基准测试 一直以来默默隐藏的难点:术语不匹配。其典型示例是用户说“Lopressor”, 而记录中却写着“酒石酸美托洛尔”。
这是最新研究所探讨的线索,而它指向了一个令人不安的方向。
当被要求写出定义某个临床概念的代码时,一种“冻结前沿”模型返回的 代码中,有48.6%在参考词汇表中根本不存在,其值集层面的F1值 仅为0.105[1]。 在一项 OMOP 队列构建研究中,同一类未配备 术语工具的模型在需要概念标识符的地方生成了词汇表代码:其****84 个已执行的队列定义 中有 79个未返回任何患者 [2]。
综合上述内容,得出的结论令人不安,因为这与SQL完全无关。 这些问题所需的查询是一个带有IN列表的COUNT(DISTINCT …),或者是一个带有 派生标志的列表——而模型能够可靠地生成这些内容。**但它们无法可靠地决定什么 应该被放入 IN 列表中。**代码调用本质上是死记硬背,而死记硬背的失败往往悄无声息: 查询经过解析、执行,返回了一个看似合理的数值,而输出结果中没有任何迹象表明 这些代码是凭空捏造的。
因此,该领域的重心已从查询生成转向术语****解析,后者现已被视为一个独立的研究问题。当前最优的表述方式 是“检索增强型集合补全”:从 经过精心整理的语料库中检索出最相似的现有值集,然后将每个候选代码分类为“属于”或“不属于”。 一个在 SapBERT上微调的跨编码器,在11,803个公开的VSAC值集上 [1]达到了0.852的AUROC和0.298的集合级F1值——这是零样本任务的三倍,但没人会说这个问题已经解决了。
- 这些论文最终得出的架构
不同研究团队、不同数据库,但结论大致相同:不要再让模型 承载临床知识,而应将这些知识融入其周边的工具中。
ML4H 框架[2]最直接地阐述了这一原则。词汇检索、 查询规范、验证和执行都成为模型之外的 工具、指令模块和检查机制。 模型在类型化的中间 表示上执行有限的语义任务,且每个步骤都会被记录下来。随着术语工具的投入使用,与参考队列的 中位数一致性从“79个空队列”基线水平上升至0.91。
值集研究[1]为解析步骤本身提供了框架: **先检索,再分类。**检索以召回率为导向且范围广泛;第二个独立的 阶段则决定归属关系。这两项任务并不相同,单一的相似度得分无法 同时满足这两项需求。
而 SapBERT[3]则提供了检索器。其自对齐目标将同一 UMLS 概念的 同义词聚合在一起,这正是“heart attack”能够检索到*“myocardial**infarction”的原因*,尽管子字符串匹配永远无法实现这一点。
综合来看:有界模型任务、作为外部工具的术语、用于****解析的 **“先检索后重新排序”机制、各阶段之间的类型化中间表示,以及记录的执行轨迹。**这 正是本文所实现的架构。参考文献并非点缀——下文中的每个阶段 都旨在回应上述发现之一。
- 针对 FHIR SQL 的实现
共五个阶段。其中四个已投入运行并进行了跟踪记录;第五个阶段已构建完成,第9节对此进行了如实说明。
    "Provide a list of Type 2 Diabetis patients showing who
     had a routine HbA1c check last year"
                      │
   ┌──────────────────▼──────────────────┐
   │ 1. STEM + CONTEXT                   │  the question's words -> clinical
   │    phrase · domain · synonyms ·     │  vocabulary, read in context.
   │    specific_terms                   │  NO codes: the model is told it
   │                                     │  does not know them.
   └──────────────────┬──────────────────┘
   ┌──────────────────▼──────────────────┐
   │ 2. TERMINOLOGY RESOLUTION           │  SapBERT embedding -> VECTOR_COSINE
   │    embed -> vector search           │  over the concept table. Recall-
   │                                     │  oriented, deliberately over-fetches.
   └──────────────────┬──────────────────┘
   ┌──────────────────▼──────────────────┐
   │ 3. EXPANSION                        │  $expand is-a · $subsumes · RxNav
   │    hierarchy + brand->ingredient    │  brand->ingredient.  BUILT, NOT YET
   │                                     │  WIRED IN -- see §9.
   └──────────────────┬──────────────────┘
   ┌──────────────────▼──────────────────┐
   │ 4. RE-RANKING                       │  sees the WHOLE question + every
   │    keep / drop, with a reason       │  candidate. This is where precision
   │    per code                         │  comes from.
   └──────────────────┬──────────────────┘
   ┌──────────────────▼──────────────────┐
   │ 5. FHIR SQL                         │  resolved codes as literals, live
   │    guard -> execute                 │  schema from INFORMATION_SCHEMA,
   │                                     │  read-only validator, then IRIS runs it.
   └──────────────────┬──────────────────┘
                      ▼
            rows  +  the resolution trail
关于该链有三个方面值得探讨,因为正是这些方面使其偏离了 其构建所依据的论文。
词干提取是在上下文仍保留的情况下进行的,而非在上下文丢失之后。第一阶段不会 孤立地对单词进行规范化处理——它会先读取整个问题。 因此,“Type 2 Diabetis”会被处理为 2型糖尿病 / T2DM / NIDDM,尽管其中存在拼写错误;而在一个 关于阑尾炎的问题中,“surgery”一词会生成“阑尾切除术”和“阑尾切除”,而 在其他语境下,同一个词则不会产生这些结果。 在问题已被简化为 关键词之后放置的术语规范化器无法做到这一点;因为上下文已经不复存在。这一阶段也是模型 最有用且风险最低的阶段:它被要求进行改写,这是它擅长的,并且 被明确禁止生成代码,这是它不擅长的。
*解析和扩展是两个独立的阶段,因为它们的失败机制不同。向量搜索 会找到听起来像该短语的概念。层次扩展则会找到属于该概念*的子类——这是一种不同的关系,由本体而非距离来确定。 若将它们合并为一个检索步骤,则永远不会查询到第二种关系。§5.2 准确展示了 这种合并的代价:一个“同级”条件得分高于真正的“同组”成员,且没有任何 阈值能够将它们区分开来。
**重新排序是一个阶段,而非截断点。**廉价的设计方案是相似度阈值。下文的 测量结果表明为何这种方法行不通:排序本身就是错误的,因此没有任何截断点 能纳入正确的代码并排除错误的代码。 精确度必须来自能够 解读问题并给出理由的机制——正因为它能给出理由,输出结果才 可供审查,而这实际上比准确度更为重要。
- 为何 IRIS for Health 是实现这一目标的理想平台
若将其作为基础设施来描述,该处理流程需要:一个 FHIR 存储库;其 可供 SQL 操作的关系型投影;针对嵌入式术语的近似最近邻索引; 一个能够按阶段配置、对模型和工具调用进行排序的协调器; 每个步骤的持久化且可查询的记录;一个凭证存储库;以及一个Web层。
传统的架构由七个产品组成,且每两款产品之间都需要集成。而在 IRIS for Health 上,这一切仅需一个实例即可实现。
CONVENTIONAL ASSEMBLY                        IRIS FOR HEALTH
7 products, 8 integrations                   1 instance, 1 sidecar

  FHIR server                              ┌──────────────────────────────────┐
      │ sync                               │  FHIR R4 repository              │
      ▼                                    │  FHIR SQL projection             │
  ETL job                                  │  VECTOR(DOUBLE,768) + HNSW       │
      │                                    │                                  │
      ▼                                    │  ┌────────────────────────────┐  │
  warehouse ──────┐                        │  │ Interoperability           │  │
      │           │                        │  │ production = agent runtime │  │
      ▼           ▼                        │  │ service · process ·        │  │
  vector DB ──► orchestration              │  │ 5 traced operations        │  │
                 framework                 │  │ settings · pool · retry ·  │  │
      ▲           │                        │  │ resend                     │  │
      │           ▼                        │  └────────────────────────────┘  │
  secret store   trace /                   │                                  │
      │          observability             │  message bank = the trace        │
      │           ▲                        │  Credentials = the key store     │
      └──────► web tier                    │  CSP page    = the web tier      │
                                           └──────────────────────────────────┘
                                                        ▲
                                                        │ loopback, no exposed port
                                           ┌────────────┴─────────────┐
                                           │ sidecar: SapBERT 109M,   │
                                           │ CPU + vendor SDK         │
                                           └──────────────────────────┘
IRIS 的三项核心能力支撑着这一架构,每项能力都满足架构中不可或缺的 一项要求。
互操作性已经是代理运行时的一部分
这是评估 LangGraph 的团队始料未及的。 此类框架 旨在提供的功能,几乎与互操作性生产环境二十年来所具备的功能 完全一致:组件间类型化消息的序列化、按组件配置、池 大小与队列管理、重试和故障超时、通过*“重发”实现*的重放,以及持久化消息日志。
question ──► Agent.Service ──► Agent.Process ──┬──► LLM.Extract   stage 1
 (CSP page)   business          orchestrator    │
              service                           ├──► Embed.Op      stage 2  ◄─┐
                                                │                             │ once per
                                                ├──► Vector.Op     stage 2    │ concept
                                                │                             │
                                                ├──► LLM.Rerank    stage 4  ◄─┘
                                                │
                                                └──► LLM.SQL       stage 5
                                                         │
                                               SqlGuard ─┴─► IRIS executes ──► rows + trail
七项生产级功能。Embed.Op和Vector.Op是业务操作,而非内联 方法调用**,这正是为了**让嵌入的往返过程和向量搜索各自以 独立的请求和响应形式出现在跟踪记录中。 若采用内联方式,这些操作将不可见——而该设计的 核心理念正是确保每个决策都可供审查。
额外收获:ML4H 的作者将他们的可观察性跟踪列为一项明确的 贡献[2];而在这里,它仅仅是消息原本所在的位置。 按阶段选择 模型是生产环境中的设置,因此低成本的第 1 阶段处理和高成本的第 4 阶段处理可以 在不修改代码的情况下运行不同的模型,而跟踪记录了由哪个模型给出了响应。 添加一个阶段 ——即第9节中的 Expand.Op,即入站路径上的PHI守护——是一个新项和一条新路径,而非 图定义的重构。 而且由于聊天页面调用了业务服务,REST 客户端或 HL7 数据源也会以相同的方式进入并生成相同的跟踪记录。
FHIR SQL 为该模型提供了实际可定位的目标
通过同一命名空间中的 FHIR SQL 投影对存储库进行查询——无需导出、无需 ETL 计划、也无需额外副本来保持同步。
在此基础上还有一项刻意设计。FHIR SQL Builder 将搜索参数投影到 HSFHIR_X0001_S.*,但其中的令牌值采用**$LIST- 编码,不包含显示文本**。 若查询这些参数以获取代码,结果会返回 0 行,尽管数据中显然包含 32 个匹配项——结构 正确,比较方式错误,却未报错。因此,本演示将一个扁平的事实表直接从 资源 JSON 中投影出来:
INT_FHIRSQLLLM_Projection.Fact
  FactType · PatientId · ResourceId · Code · CodeSystem · Display
  FactDate · FactDay · ValueQuantity · ValueUnit · Status
每行对应一个 (资源, 编码) 组合。扁平化、纯文本类型,仅供 SQL 阶段处理的一张表——且 模式在运行时从 INFORMATION_SCHEMA 读取,因此提示信息始终描述的是 实际部署情况,而非其快照。
对于术语解析而言,向量搜索并非可选项
嵌入模型不包含任何代码。SapBERT 是一个文本编码器:输入文本,输出向量。 术语解析需要一个存储的 (code, system, display, vector) 表,先进行一次嵌入,然后 进行搜索。该表即术语库,这里是一个普通的 IRIS SQL 表, 带有额外的一列:
Property Embedding As %Vector(DATATYPE = "DOUBLE", LEN = 768);
CREATE INDEX ConceptVecIdx ON INT_FHIRSQLLLM_Terminology.Concept (Embedding)
  AS HNSW(Distance='Cosine')
索引采用 HNSW[4]—— 这与专用向量数据库使用的结构相同 —— 因此 无需在检索质量上做出妥协。将其置于数据库中的优势在于 概念表与患者事实表可以进行关联。 代理考虑的每个候选项 都会附带其实际将贡献的患者行数,该数据来自计算余弦得分时 使用的同一语句:
SELECT TOP 25 c.Code, c.Display, c.OccurrenceCount,
       VECTOR_COSINE(c.Embedding, TO_VECTOR(?, DOUBLE)) AS Similarity
FROM   INT_FHIRSQLLLM_Terminology.Concept c
WHERE  c.Embedding IS NOT NULL
ORDER  BY Similarity DESC
如果使用独立的向量存储,该行数需要通过应用程序代码处理,这会增加一次往返通信,并引发 一致性问题。而在这里,它被设计为一个列——第5.2节将展示其存在的价值。
概念表由存储库 中实际存在的 不同编码值构建而成,因此代理能够解析的每个代码都保证存在于数据中。当向量和事实共享同一个数据库时, 维护起来非常简单;若不共享,则需要进行同步操作。
本次部署:来自Synthea[10]的337名合成患者(马萨诸塞州,种子 20261101,10年病史)→ 8种资源类型共68,956个FHIR资源 → 199,267 预测事实 → 涵盖 SNOMED CT、ICD-10、LOINC、RxNorm、CVX 和 CDT 的1,220 个术语概念,其中 33 个(2.7%)存在词汇歧义。
Synthea 对结果至关重要,而不仅仅关乎许可问题:它通过逐个模块模拟每位患者的生活, 而非抽样行数据,因此诊断之后会紧随 相应的检查。这正是“护理缺口”问题能得出结果的唯一原因。
- 一个问题,端到端
以上内容均为论述。以下是一个真实的对话片段,取自消息库 ,完全按照记录原样呈现,该对话来自聊天页面。
这是一条质量报告请求,措辞完全按照实际收到的原样呈现,包括其中的拼写错误:
Provide a list of Type 2 Diabetis patients showing who had a routine HbA1c check last year
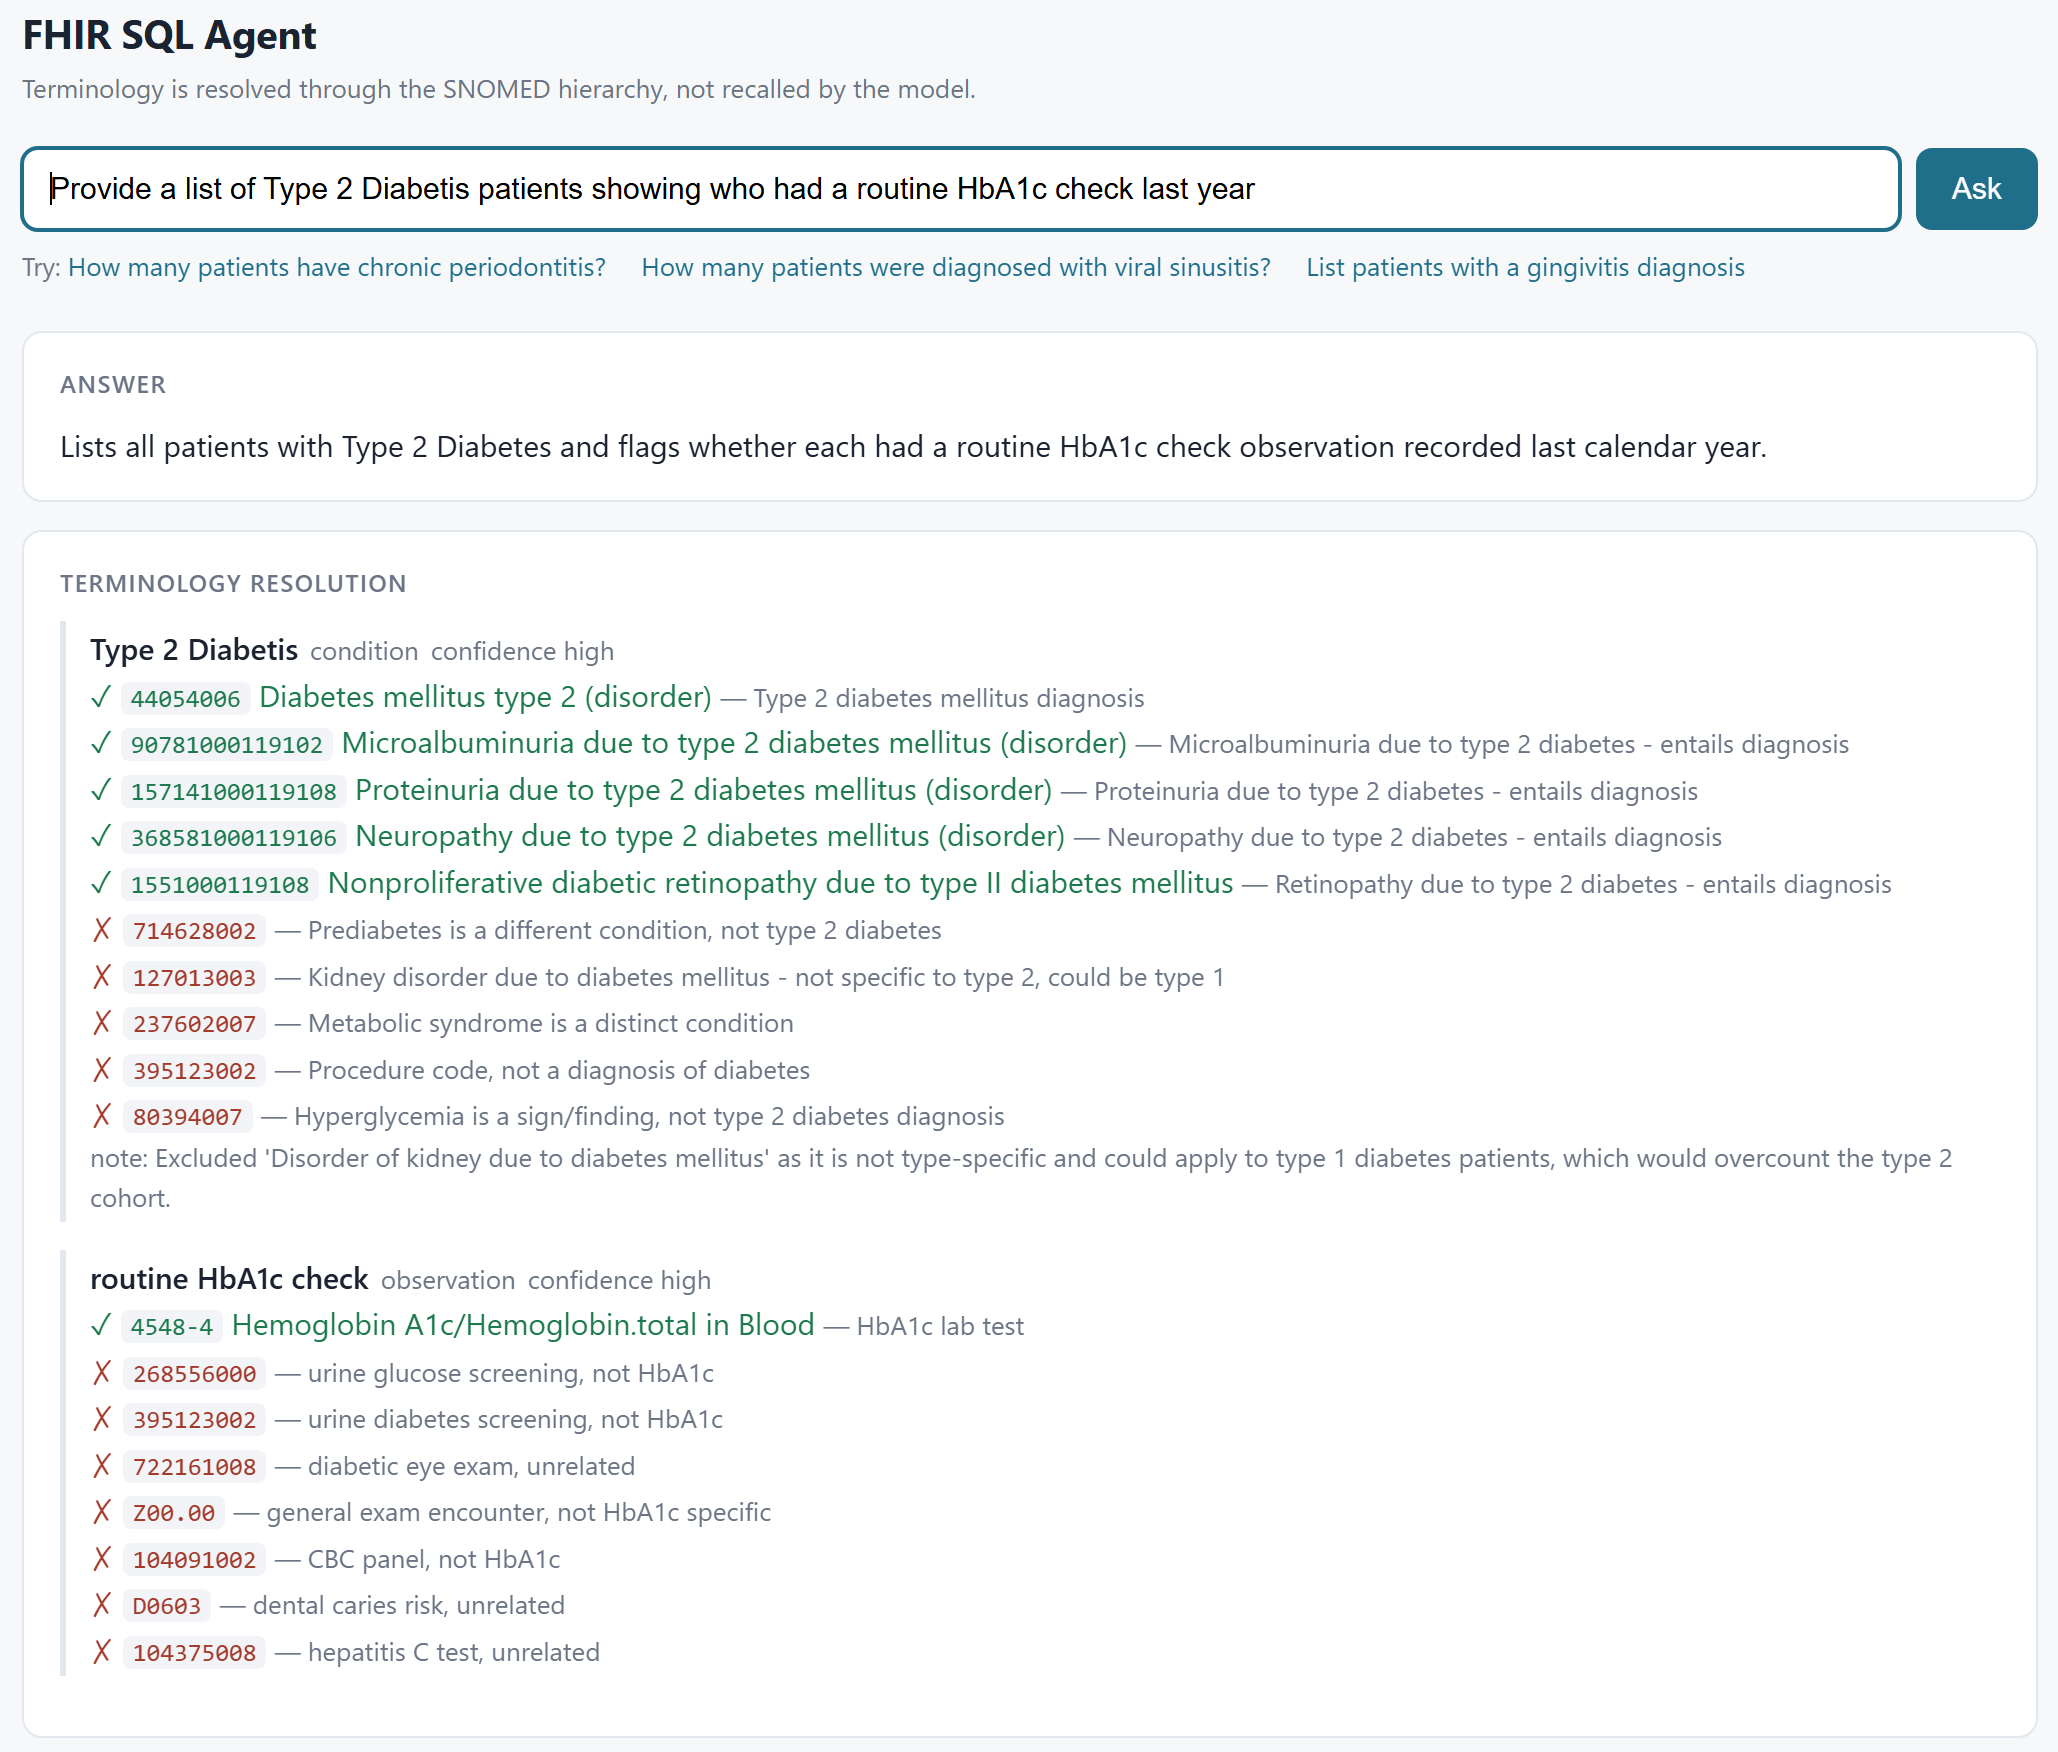
它生成了18条消息——9组请求/响应对,因为有两个临床 概念,且每个概念都有各自的解决周期:
| \#会话 | 发自 → 发往 | 阶段 |
|---|---|---|
| 282 | Agent.Service → Agent.Process | `Agent.Question` |
| 283/284 | Agent.Process ↔ LLM.Extract | 1 — 词干 + 上下文 |
| 285/286 | Agent.Process ↔ Embed.Op | 2 — 概念 1 |
| 287/288 | Agent.Process ↔ Vector.Op | 2 — 概念 1 |
| 289/290 | Agent.Process ↔ LLM.Rerank | 4 — 概念 1 |
| 291/292 | Agent.Process ↔ Embed.Op | 2 — 概念 2 |
| 293/294 | Agent.Process ↔ Vector.Op | 2 — 概念 2 |
| 295/296 | Agent.Process ↔ LLM.Rerank | 4 — 概念 2 |
| 297/298 | Agent.Process ↔ LLM.SQL | 5 — FHIR SQL |
| 299 | Agent.Process → Agent.Service | `Agent.Answer` |
5.1 第一阶段 — 词干与语境
model=claude-sonnet-5 · prompt 702 tok · completion 402 tok · 4,434 ms
{
  "entities": [
    { "phrase": "Type 2 Diabetis",
      "domain": "condition",
      "synonyms": ["Type 2 Diabetes Mellitus", "T2DM",
                   "non-insulin-dependent diabetes mellitus", "NIDDM"],
      "specific_terms": [] },
    { "phrase": "routine HbA1c check",
      "domain": "observation",
      "synonyms": ["hemoglobin A1c test", "glycated hemoglobin test", "HbA1c measurement"],
      "specific_terms": ["HbA1c level", "hemoglobin A1c lab result"] }
  ],
  "dimensions": {
    "aggregation": "list_patients",
    "temporal": { "type": "window", "before": null, "after": null, "window_days": 365 },
    "group_by": null
  },
  "answerable": true,
  "reason_if_not": ""
}
两个概念,每个都有其应用领域和临床释义。错别字已修正。且没有一个 代码——提示语禁止使用代码。
5.2 第二阶段——解决方案,以及决定架构的结果
Embed.Response   model=SapBERT  dim=768  latency_ms=45
Vector.Response  count=10  top_similarity=0.8309  latency_ms=7
CPU 嵌入耗时 45 毫秒,搜索耗时 7 毫秒。候选列表直接摘自跟踪日志,并 添加了正确的判定结果:
| 余弦 | 代码 | display | 行数 | 结论 |
|---|---|---|---|---|
| 0.8309 | 44054006 | 2型糖尿病(疾病) | 18 | ✅ 保留 |
| 0.6231 | 368581000119106 | 2型糖尿病引起的神经病变 | 8 | ✅ 保留 |
| 0.5824 | 157141000119108 | 2型糖尿病引起的蛋白尿 | 14 | ✅ 保留 |
| 0.5747 | 90781000119102 | 2型糖尿病引起的微量白蛋白尿 | 24 | ✅ 保留 |
| **0.5717** | **714628002** | **糖尿病前期(检查结果)** | **118** | ❌**其他病症** |
| 0.5549 | 127013003 | 糖尿病引起的肾脏疾病 | 28 | ❔ 未指定具体类型 |
| 0.5351 | 237602007 | 代谢综合征 X(疾病) | 41 | ❌ 独立疾病 |
| **0.5231** | **1551000119108** | **由Ⅱ型糖尿病引起的非增生性糖尿病视网膜病变** | **3** | ✅**保留** |
| 0.5005 | 395123002 | 糖尿病尿液筛查(操作) | 84 | ❌ 仅为检测,非诊断 |
| 0.4529 | 80394007 | 高血糖(疾病) | 6 | ❌ 检查结果,而非诊断 |
这个拼写错误并不重要。“2型糖尿病”仍能匹配正确的代码0.8309——而基于 拼写错误的词汇匹配则完全无法返回任何结果。这正是第二阶段展现其价值之处。
但没有任何阈值是有效的。阈值为0.5717 的糖尿病前期,其优先级高于阈值为0.5231的 II型糖尿病引起的 非增殖性糖尿病**视网膜病变——而视网膜病变代码是该队列的 真正成员,而糖尿病前期则属于不同的临床状态。 若将阈值设为0.55,则会纳入 118名糖尿病前期患者,同时漏诊一名确诊患者。没有任何阈值能够同时保留这四个 并发症代码并排除糖尿病前期,因为排序本身就是错误的。
这并非 SapBERT 的缺陷。这正是相似度度量的本质:“糖尿病前期”和“2型 糖尿病”确实是关于相关生理现象的相似字符串。它们仅仅不属于同一个 队列——而这种区分是范畴性的,而非度量性的。这是第3阶段 ($subsumes)所回答的问题,也是第4阶段所探讨的原因。
第二个概念使问题更难理解:
Embed.Response   model=SapBERT  dim=768  latency_ms=42
Vector.Response  count=8  top_similarity=0.5797  latency_ms=7
| 余弦 | 代码 | 显示 | 行 | 结论 |
|---|---|---|---|---|
| **0.5797** | 268556000 | 尿液葡萄糖筛查(操作流程) | 83 | ❌**错误,且排名第一** |
| 0.5238 | 395123002 | 糖尿病尿液筛查(操作流程) | 84 | ❌ 错误 |
| **0.4971** | **4548-4** | **血红蛋白A1c/总血红蛋白** | **2,079** | ✅**正确 — 排名第3** |
| 0.4878 | 722161008 | 糖尿病视网膜检查(操作) | 93 | ❌ |
| 0.4873 | Z00.00 | 成人常规体检就诊 | 1 | ❌ |
| 0.4816 | 104091002 | 全血细胞计数,全自动… (CBC) | 167 | ❌ |
| 0.4662 | D0603 | 龋齿风险评估,高风险*(牙科,CDT)* | 108 | ❌ |
| 0.4510 | 104375008 | 丙型肝炎抗体,确认试验 | 84 | ❌ |
Cosine的Top-1结果完全错误。该Top-1检索器对整个质量指标的回答是 *“尿液葡萄糖筛查”。*正确答案——该 数据仓库中唯一的HbA1c LOINC代码(包含2,079条结果)——却排在第三位。龋齿风险评估也出现在 列表中,这生动地展示了混合词汇表中的相似性会带来什么结果。
请注意“rows”这一列在两张表中都发挥了作用。它与余弦得分源自同一个 SQL 语句, 正是这一列向下一阶段表明:错误记录糖尿病前期会导致 118 名患者,而视网膜病变代码则带来 3 名患者。
5.3 第四阶段——重新排序及理由说明
concept 1: prompt 1,241 tok · completion 1,000 tok · 13,101 ms``concept 2: prompt 1,180 tok · completion 266 tok · 3,820 ms
2型糖尿病— 置信度高
| 代码 | 显示 | 原因 | |
|---|---|---|---|
| ✓ | 44054006 | 2型糖尿病(疾病) | 2型糖尿病诊断 |
| ✓ | 90781000119102 | 由2型糖尿病引起的微量白蛋白尿 | 需伴随该诊断 |
| ✓ | 157141000119108 | 2型糖尿病引起的蛋白尿 | 涉及诊断 |
| ✓ | 368581000119106 | 2型糖尿病引起的神经病变 | 需诊断 |
| ✓ | 1551000119108 | 由2型糖尿病引起的非增殖性糖尿病视网膜病变 | 涉及诊断 |
| ✗ | 714628002 | — | 糖尿病前期是一种不同的病症,并非2型糖尿病 |
| ✗ | 127013003 | — | 由糖尿病引起的肾脏病变——并非仅见于2型糖尿病,1型糖尿病患者也可能出现 |
| ✗ | 237602007 | — | 代谢综合征是一种独立的疾病 |
| ✗ | 395123002 | — | 这是手术代码,并非糖尿病的诊断 |
| ✗ | 80394007 | — | 高血糖是一种体征/检查结果,并非2型糖尿病的诊断 |
**注:**已排除“糖尿病引起的肾脏疾病”,因其未指明具体类型 且可能适用于1型糖尿病患者,这将导致2型糖尿病队列的计数重复。
常规糖化血红蛋白(HbA1c)检测— 可信度高
| 代码 | 显示 | 原因 | |
|---|---|---|---|
| ✓ | 4548-4 | 血液中糖化血红蛋白A1c/总血红蛋白 | 糖化血红蛋白(HbA1c)实验室检测 |
| ✗ | 268556000 | — | 尿糖筛查,非糖化血红蛋白 |
| ✗ | 395123002 | — | 尿液糖尿病筛查,而非糖化血红蛋白(HbA1c) |
| ✗ | 722161008 | — | 糖尿病眼部检查,无关 |
| ✗ | Z00.00 | — | 常规体检,非糖化血红蛋白(HbA1c)专项检查 |
| ✗ | 104091002 | — | 血常规检查,非糖化血红蛋白检测 |
| ✗ | D0603 | — | 龋齿风险,无关 |
| ✗ | 104375008 | — | 丙型肝炎检测,无关 |
判断的两个方向均记录了理由:纳入了四个并发症代码**,因为它们涉及该诊断;排除了糖尿病前期**,因为它属于不同的 临床状态;并且因优先采用第3级而排除了余弦Top-1算法。
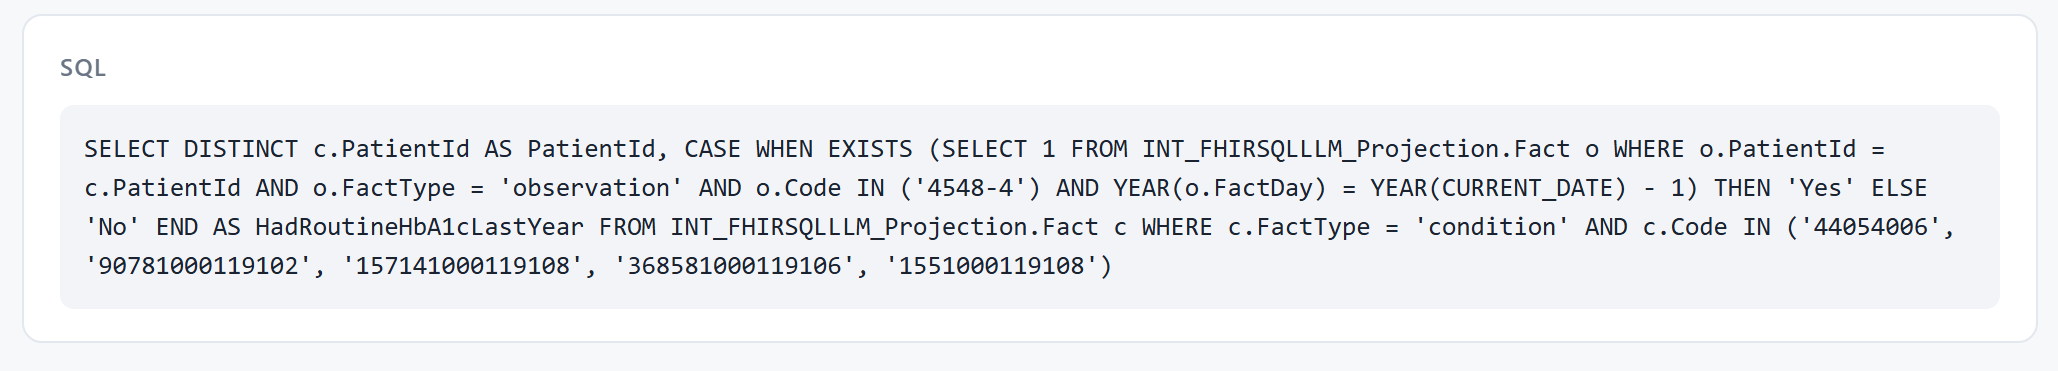
5.4 第 5 阶段 — FHIR SQL
prompt 1,329 tok · completion 413 tok · 4,657 ms
SQL 阶段不会接触到词汇表。它将解析后的代码作为字面量获取,并获取动态 模式:
SELECT DISTINCT c.PatientId AS PatientId,
       CASE WHEN EXISTS (
              SELECT 1 FROM INT_FHIRSQLLLM_Projection.Fact o
              WHERE  o.PatientId = c.PatientId
                AND  o.FactType  = 'observation'
                AND  o.Code IN ('4548-4')
                AND  YEAR(o.FactDay) = YEAR(CURRENT_DATE) - 1)
            THEN 'Yes' ELSE 'No' END AS HadRoutineHbA1cLastYear
FROM   INT_FHIRSQLLLM_Projection.Fact c
WHERE  c.FactType = 'condition'
  AND  c.Code IN ('44054006', '90781000119102', '157141000119108',
                  '368581000119106', '1551000119108')
Agent.SqlGuard 首先对其进行验证——仅限单个语句,SELECT 且不包含 DML、DDL、 过程调用或链式调用——随后由 IRIS 执行该语句。
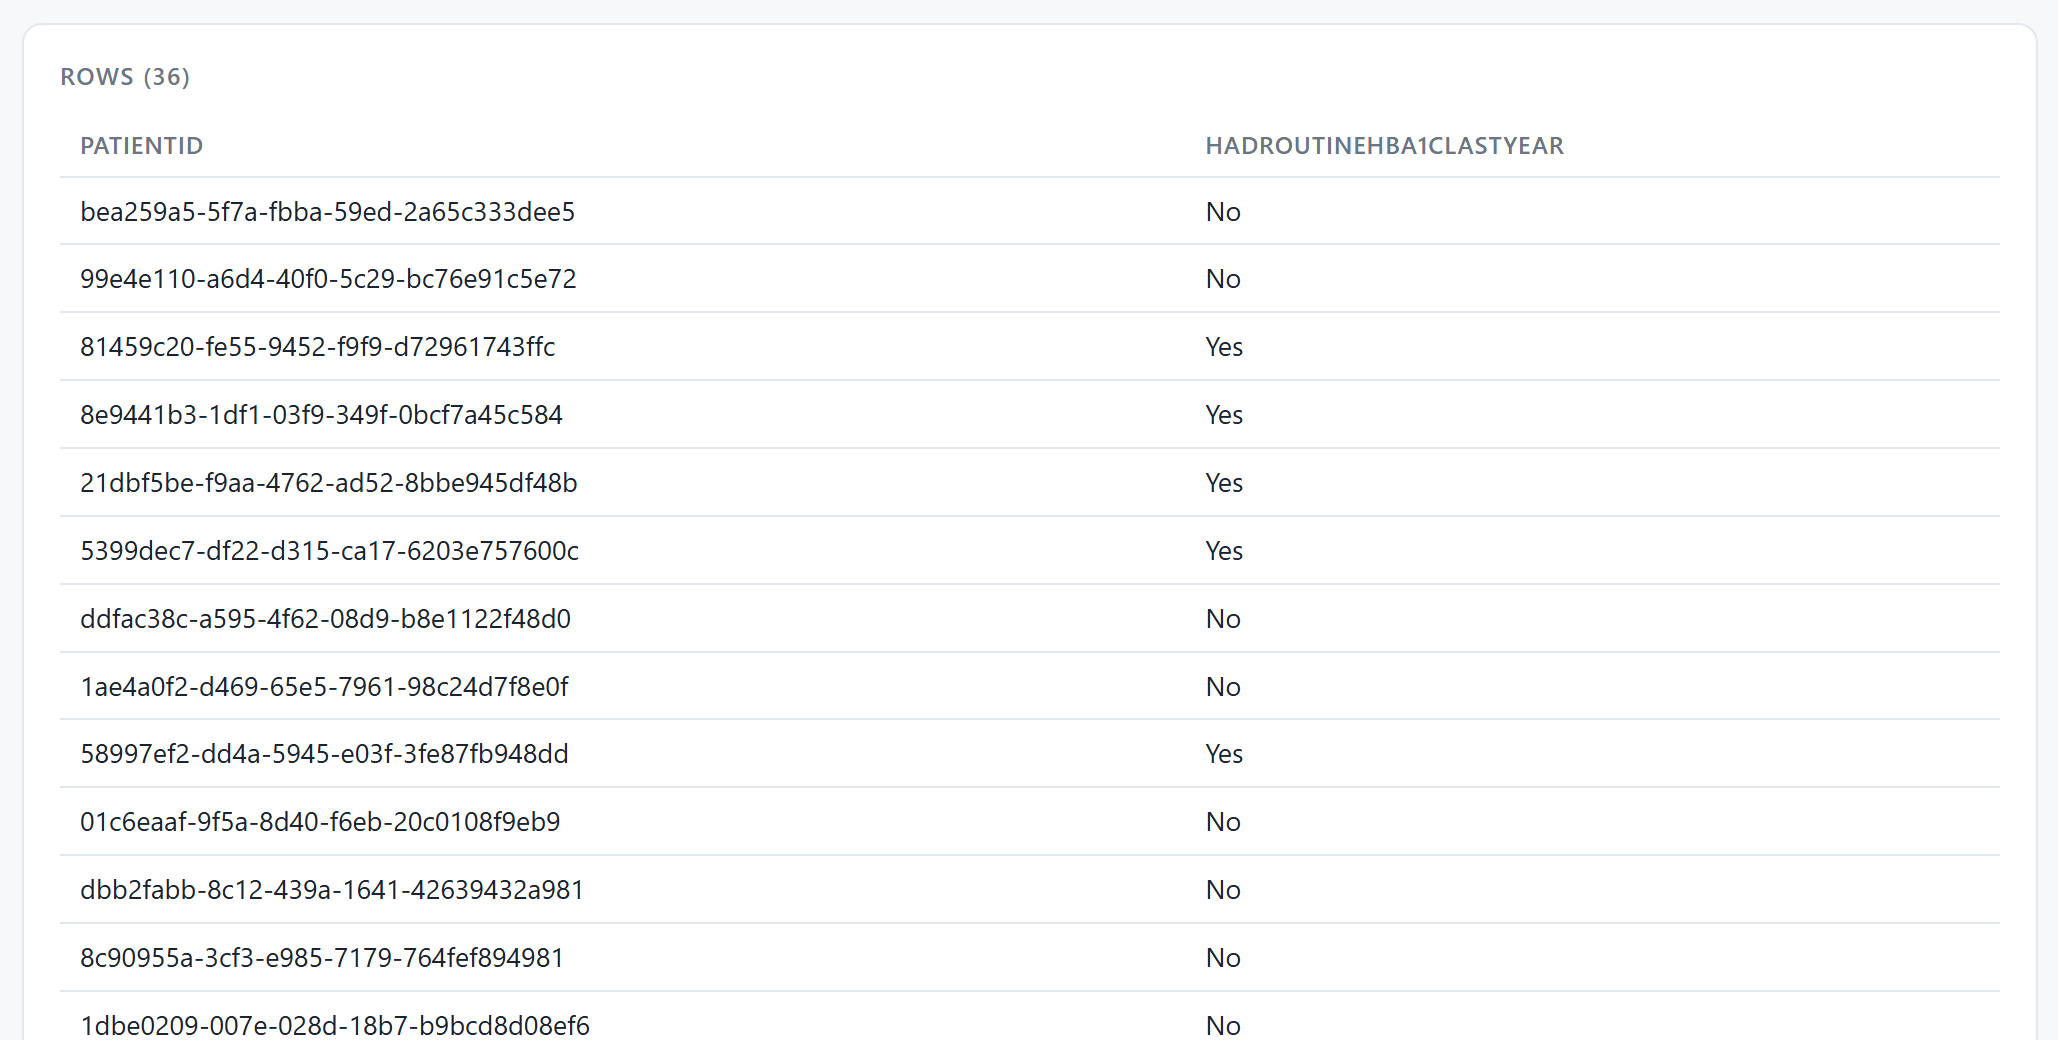
36 行 · 19 赞 / 17 反对 · 26,235 毫秒
| PatientId | 去年是否进行过常规HbA1c检测 |
|---|---|
| bea259a5-5f7a-fbba-59ed-2a65c333dee5 | 否 |
| 99e4e110-a6d4-40f0-5c29-bc76e91c5e72 | 否 |
| 81459c20-fe55-9452-f9f9-d72961743ffc | 是 |
| 8e9441b3-1df1-03f9-349f-0bcf7a45c584 | 是 |
| 21dbf5be-f9aa-4762-ad52-8bbe945df48b | 是 |
| … | *还有 31 行* |
17名已登记的糖尿病患者,去年未检测HbA1c:一份待联系的工作清单。
5.5 那26秒去哪儿了
| 阶段 | 运行时间 | 延迟 | 占比 |
|---|---|---|---|
| 1 — 词干 + 语境 | *模型调用* | 4,434 毫秒 | 16.9% |
| 2 — 嵌入 × 2 | **sidecar,回调** | **87 毫秒** | **0.3%** |
| 2 — 向量搜索 × 2 | **IRIS SQL** | **14 毫秒** | **0.1%** |
| 4 — 重新排序 × 2 | *模型调用次数* | 16,921 毫秒 | 64.5% |
| 5 — SQL 生成 | *模型调用* | 4,657 毫秒 | 17.8% |
| 保护 + 执行 + 汇编 | **IRIS** | 约122 毫秒 | 0.5% |
| **总计** | **26,235 毫秒** | 100% |
该平台执行的所有操作——两次嵌入往返、两次向量搜索、守护机制、 执行以及审计记录的**生成——在26.2秒中仅耗时约220毫秒,占比不到1%。**其余 99%的时间用于四次模型调用。
由此产生两个结论。检索机制实际上是“免费”的,因此从性能角度 来看,没有理由在此处偷工减料:扩大候选项集,或添加第 3 阶段的 $subsumes 检查 ,在 17 秒的重新排序过程中仅消耗几毫秒。 而且优化目标 显而易见,且并非数据库——而是重新排序阶段,这恰恰是 生产环境中可替换的组件。
- 为何这在三个具体方面优于BI工具
公正的比较不应仅是“该代理更快”。仪表盘一旦构建完成,便能在 几毫秒内给出答案。真正的比较在于获得答案所需的时间, 以及事后可以进行哪些核查。以下三个角度,在上述运行中均可见一斑。
术语角度
该查询中的任何内容都与实际输入的数据不符。“Type 2 Diabetis”拼写有误;“routine HbA1c check”在任何显示字符串中均未出现。BI过滤器需要预先由 既了解临床意图又熟悉术语的人选定一组值。
而且,值集的决策同时涉及两个方向,而没有任何过滤器表达式 能对此进行编码:诸如*“2型糖尿病引起的神经病变”之类的并发症代码必须 被包含在内,因为仅携带该代码的患者即为糖尿病患者——而“糖尿病前期”*则必须 被排除在外。第5.2节表明,没有任何相似度阈值能够同时满足这两项要求。
这一决策的价值在于:针对同一数据集的相同查询,若采用正确且 显而易见的简便方法进行处理:
| 糖尿病队列 | 患者 | 是 | 否 | **报告的依从性** |
|---|---|---|---|---|
| 已解析的值集——*代理生成的结果* | 36 | 19 | 17 | **52.8%** |
| 朴素算法 `Display LIKE '%diabet%'` | 131 | 86 | 45 | **65.6%** |
这种简单的定义显示依从率为65.6%,而实际数字为52.8%——相差近 13个百分点,误差方向是偏高的。其机制很简单: LIKE '%diabet%' 纳入了92名糖尿病前期患者,由于糖尿病前期患者会接受常规的糖化血红蛋白(HbA1c)监测, 因此他们几乎全都归入“是”一栏,从而虚增了结果。
而且由于该请求会返回一份工作清单,因此该错误不仅仅是一个写在白板上的数字。 这种简单粗放的做法会让糖尿病护士去追踪45名患者,其中28名其实并没有****糖尿病。
现在再对比一下该处理人员自己那个有争议的决定——删除了*“因糖尿病* 导致的肾脏疾病” 这一诊断,理由是该代码未注明具体类型,而请求中明确指明了2型。 审核人员很可能推翻这一决定。这会使研究队列减少3名患者,而报告的 数据则减少不到1个百分点。
这种对比正是关键所在。追踪记录并非证明该操作员正确,而是使 **每个选择的后果可量化。**那个有争议的决定最终被证明无关紧要, 而那个“隐形”的决定却价值十三分,且区分二者只需 一分钟,而非进行一次审计。 对于受监管的指标——如JAWDA、HEDIS或国家糖尿病 审计——那套记录在案的数值,连同每个代码对应的理由,就是可审计的实证依据。
时间维度
“去年”和“显示谁拥有”——这两个时间维度是仪表盘难以处理的。
该时间窗口以当前时刻为基准,且在“上一日历年”与“ 滚动十二个月”之间存在歧义。仪表盘的日期筛选器是绝对的;由某人决定并硬编码, 随后便无人能知晓具体选择了哪一种。 操作员选择了日历年,并在 列名 中注明了这一点——HadRoutineHbA1cLastYear——这一细微之处使得该选择可供审查。
更棘手的是:输出结果需要为每个队列成员生成一行数据,并包含一个派生的“是/否”列,而不是 一个经过筛选的列表。仪表盘只能对已存在的行进行筛选;它很难保留那些 未发生该事件的患者——而在护理缺口分析中,这些患者才是关键所在。这是一种相关 CASE WHEN EXISTS,由系统在查询时动态生成。
这也是同一引擎中 FHIR SQL 发挥作用的地方。时间比较是对 包含真实日期列的扁平事实表进行的自连接,仅需一条语句,一次事务即可完成——而不是 在数据仓库和向量存储之间进行应用层连接,且中间还存在一致性问题。
敏捷性视角
这条数据流的替代方案并非更慢的查询——**而是一张工单。**一位分析师需要整理 两组值,构建一个模型将条件与观察结果进行连接,同时保留未发生该事件的 队列成员,确定时间窗口,并发布仪表盘。这需要数天时间。而最终, 决定该数字的临床判断却消失在仪表盘定义中, 而这个定义再也没有人会去阅读。
下一个问题*——同一组人群,但谁该进行视网膜筛查了?*——又让这个循环 重新开始。新的值集,新的模型,又一张工单。
该工具在26秒内给出答案,无需新的ETL处理、无需新的仪表盘,也无需训练模型,并 反馈了保留了哪些代码、舍弃了哪些代码以及原因。第二个问题的边际成本是26秒,而不是另一个冲刺周期。这就是敏捷性的论据,其价值 远高于延迟问题:临床分析中的瓶颈从来都不是查询执行,而****是分析师面前的待办事项队列。
- 受保护健康信息(PHI)的边界
| 阶段 | 离开实例的内容 |
|---|---|
| 1 — 词干 + 语境 | 仅问题文本 |
| 2 — 嵌入 | 问题中的名词短语 — 发送到回环侧车,不外传 |
| 2 — 向量 | *无;在IRIS中运行* |
| 4 — 重新排序 | 候选**概念名称**— 不包含患者数据 |
| 5 — SQL | 问题 + 模式 + 已解析代码 — 不包含患者数据 |
| 执行 | *无操作;在IRIS中运行* |
| 结果 | **从未发送至任何模型** |
第5节中的有效载荷就是证据:唯一离开该实例的临床内容是一份 概念名称列表。这36个患者标识符从未接触过任何模型。
该密钥也未到达任何调用点。它存储在 IRIS凭据条目中;一个方法将其以 模式 600 写入到一个卷中,该卷由 sidecar 自行读取。它未出现在任何源文件、任何生产 环境、任何命令行以及任何进程列表中。
对于真正的个人健康信息(PHI):添加一个入站防护机制,对问题中的标识符进行屏蔽,使用 VerifyPeer = 1 并配置真实的证书颁发机构(CA),并选择一家拥有企业协议且 包含“不得使用您的数据进行训练”条款的供应商。
这并非为医疗保健领域中的代理式人工智能构建的技术栈,但事实证明,它 一直以来都具备了正确的组件。
代码: https://github.com/adelelsayed/fhirsqlAgent— docker compose up,Synthea数据,不含 个人健康信息(PHI)。
参考文献
*[1]Mukherjee, S., Shu, J., Mazumder, N., Kernell, T., Wheeler, C., Hastings, S., Sidey-Gibbons, C.先检索,再分类:基于语料库的 临床价值集编写 *自动化。arXiv:2604.14616 —https://arxiv.org/abs/2604.14616(RASC:48.6%的不存在代码数据;在11,803个公开的VSAC价值集上,SapBERT跨编码器的AUROC为0.852,集合级F1值为0.298,而零样本学习模型的F1值为0.105。)
[2] 将推理与执行分离:基于OMOP CDM的NL2SQL和队列构建的工具介导的能动性框架。《健康机器学习》(ML4H) 2026,会议论文集专题。(外部化术语查找、类型化中间表示及记录的执行轨迹;在工具支持下,84个队列中有79个为空,与工具的一致性中位数达 0.91。)
**[3]**Liu, F., Shareghi, E., Meng, Z., Basaldella, M., Collier, N. 生物医学实体表示的自对齐预训练。NAACL 2021, 4228–4238.arXiv:2010.11784 —https://arxiv.org/abs/2010.11784· https://github.com/cambridgeltl/sapbert(SapBERT。此处使用的检查点为 cambridgeltl/SapBERT-from-PubMedBERT-fulltext 。)
**[4]Malkov, Y. A., Yashunin, D. A.基于分层可导航小世界图 *的高效且稳健的近似最近邻搜索。*arXiv:1603.09320 — https://arxiv.org/abs/1603.09320 ( IRIS向量搜索中 AS HNSW背后的结构 。)
**[5]李(G.)、黄(H.)、裴(S.)等人。EHRSQL:一个适用于电子健康记录的 *实用文本到SQL基准测试。*arXiv:2301.07695 — https://arxiv.org/abs/2301.07695
[6] FHIR-AgentBench:针对现实场景下**互操作性电子健康记录问答 的大语言模型(LLM)代理基准测试。arXiv:2509.19319 —https://arxiv.org/abs/2509.19319(报告显示,平均每个问题需要14.5个FHIR资源。)
[7] EHR-ChatQA:从对话到查询执行——针对 电子健康记录(EHR)数据库代理的用户与工具交互 基准测试。ICLR 2026。(多轮对话;将术语**不匹配(如“Lopressor”与“酒石酸美托洛尔”)视为首要难点。)
**[8]**HL7 FHIR R4 术语操作: ValueSet/$expand· CodeSystem/$subsumes· CodeSystem/$lookup— 已根据 tx.fhir.org/r4 进行解析。
[9] RxNav / RxNorm API— 商品名到 成分名。
**[10]**Walonoski, J., Kramer, M., Nichols, J., Quina, A., Moesel, C., Hall, D., Duffett, C., Dube, K., Gallagher, T., McLachlan, S.Synthea:一种生成合成患者及合成电子健康 记录的 *方案、方法 和软件机制。《美国医学信息学协会杂志》2018;25(3):230–238. doi:10.1093/jamia/ocx079· https://github.com/synthetichealth/synthea(Apache 2.0) (全文均使用合成人群——任何 环节 均未涉及真实患者数据。*337名患者,马萨诸塞州,种子值20261101,10年病史,由v3.4.0-18-ga07a65555生成。生成脚本及完整运行清单:iris/synthea/ 。)