连接测试可以告诉我们服务器有响应,数据库结构可以告诉我们某列名叫 Code。但仅凭这两点,我们仍不知道这个编码代表什么,也不知道它是否应该映射到某个目标字段。
可靠的数据集成设计,要从这里开始。在决定哪个源资产对应哪个目标、哪些组件应组成一条数据管道之前,我们需要先理解接口——不只是接口的结构,还要理解这些结构在具体场景中的含义。
本文介绍 DataPipelineDemo 在 InterSystems IRIS for Health 上如何处理这个问题。核心原则是语义优先:先理解接口表达的含义,再做映射与管道设计决策。
这里的“语义优先”指的是下游决策顺序,并不是先让 AI 凭空猜测、再去看接口。实际流程是先采集结构和运行事实,再由大语言模型(LLM)基于这些事实进行解释,最后将分析结果作为后续决策的上下文。
1. 端点可达,不等于接口已理解
连通性是必要条件,但它回答的问题很有限:当前应用能否访问这个端点?
它无法证明:
- 某张源表或某类 FHIR 资源在业务领域中代表什么;
- 某个字段是标识符、状态、编码值,还是显示名称;
- 某个操作用于读取数据,还是用于接收并写入数据;
- 端点是否支持增量读取或特定的投递机制;
- 结构上合法的映射是否保留了原本想表达的业务含义。
这些问题不同,需要的证据也不同。收到成功的 HTTP 响应,是连通性证据;查询 SQL 元数据,可以得到结构证据;判断某列承载诊断编码,则是语义结论,应以已有证据为依据,不能悄悄说成“数据库已经证明了这一点”。
2. 为什么映射之前要先理解语义
过早做映射,很容易走上一条看似省事的捷径:按字段名或表面结构匹配。
但 Code 可能是诊断编码、产品编码、本地状态码,也可能有其他含义。反过来,PatientNo、patient_id 和 FHIR 的 identifier 名称不同,却可能表达同一种业务标识。结构相似不代表含义相同,名称不同也不代表含义不同。
如果这些问题尚未澄清就生成映射,管道中可能只是固化了一个假设。后续验证即使证明管道编译成功、消息已经投递,也不能单独证明字段值的业务含义符合目标系统的预期。
因此,处理顺序很重要:
- 收集接口实际暴露了哪些内容。
- 结合证据解释可能的业务含义,并保留可见的不确定性。
- 根据理解结果,提出资产匹配和字段映射建议。
- 相关选择经过确认后,再设计并生成数据管道。
语义优先可以减少本可避免的猜测,为后续步骤提供更可靠的推理依据,但它不会消除所有歧义。如果现有事实不足以判断,就应该明确保留这种不确定性,而不是把推断包装成已确认的映射。
3. 先解析结构,再解释含义
接口理解包含两个相互配合的阶段。
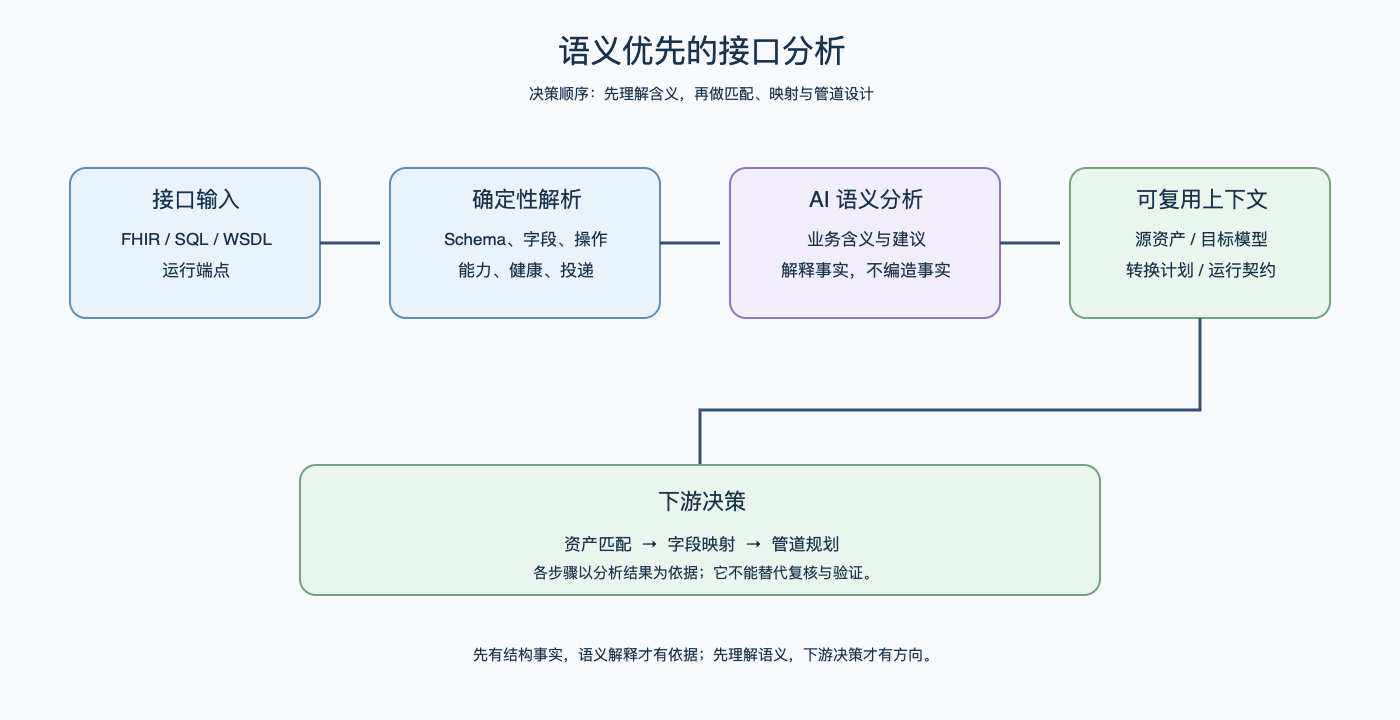
图 1:结构与运行事实为 AI 分析提供依据;语义上下文再用于后续设计决策。
第一阶段:采集可验证的事实
确定性代码和协议专用工具负责采集可观察的信息。项目中的例子包括:
- FHIR:端点元数据,例如服务器声明的 FHIR 版本与搜索能力;可用资源类型;样例资源中观察到的字段;以及在条件允许时从 FHIR 定义中推导出的字段。
- SQL:选定的 schema 和表、列名、连接结果,以及与轮询或增量键相关的信息。
- SOAP:WSDL 中的 service 和 operation 定义、请求与响应消息结构,以及生成的 BO 消息元数据。
- 运行信息:端点健康状态、连接结果、能力、轮询行为和投递细节。
不同事实采集方式能证明的内容不同。样例字段只能说明它出现在被采样的数据中,不能单独证明该字段必填,也不能直接证明它的业务含义。从 FHIR 规范推导出的字段路径,与从实际资源中观察到的路径,是两种不同来源的证据。每项结论的来源都很重要。
第二阶段:把事实解释为语义上下文
接口分析 Agent 将采集到的事实交给 LLM,生成诸如以下分析结论:
- 某张源表或某类资源可能承担的业务角色;
- 可能的业务键或轮询键建议;
- 哪些字段可能承载编码值、术语 URI 或显示名称;
- 某个目标接口是否适合写入,还是偏向查询;
- 运行契约对管道设计意味着什么。
这些输出是 AI 分析,不是协议层面的观测事实。系统有意区分二者:确定性工具采集事实,LLM 解释事实。如果 LLM 调用失败或输出不可用,分析应明确失败,而不是悄悄用规则生成的语义结论顶替。
这两个阶段缺一不可。只有结构而没有解释,往往不足以支撑有用的匹配;没有结构证据的解释,则只是猜测。
4. 分析会产出什么?各模型分别负责什么?
系统保留多个彼此相关的产物,因为它们回答的问题不同:
| 产物 | 描述内容 | 能帮助回答的问题 |
|---|---|---|
| 源资产模型 | 已发现的源资产(例如 SQL 表或 FHIR 资源类型),以及字段与语义注释 | 可用的源对象和字段是什么? |
| 目标接口模型 | 接收端的表、SOAP 实体/操作或 FHIR 资源结构及约束 | 这个目标能够接收什么? |
| 转换计划 | 源数据与目标数据之间预期的关系和转换指令 | 哪些值应映射或转换? |
| 运行契约 | 连接信息、能力、轮询或投递行为,以及健康状态 | 在什么运行条件下可以使用该接口? |
运行契约也可以包含 AI 生成的解读与建议。这些内容能作为有用上下文,但不能替代并列记录的连接探测结果或能力数据。类似地,任何一个产物都不是其他所有领域的“全局唯一事实源”。
这些产物共同保留了三者之间的区别:观测到的事实、推断出的含义,以及用户打算构建的集成。
5. 示例:理解 SQL 源与 SOAP 目标
设想一个 SQL 患者表和一个提供 AddPatient 操作的 SOAP 目标。集成并非只要找到三个名称相似的字段就够了;源数据必须能以接收接口所期望的含义表达请求字段。
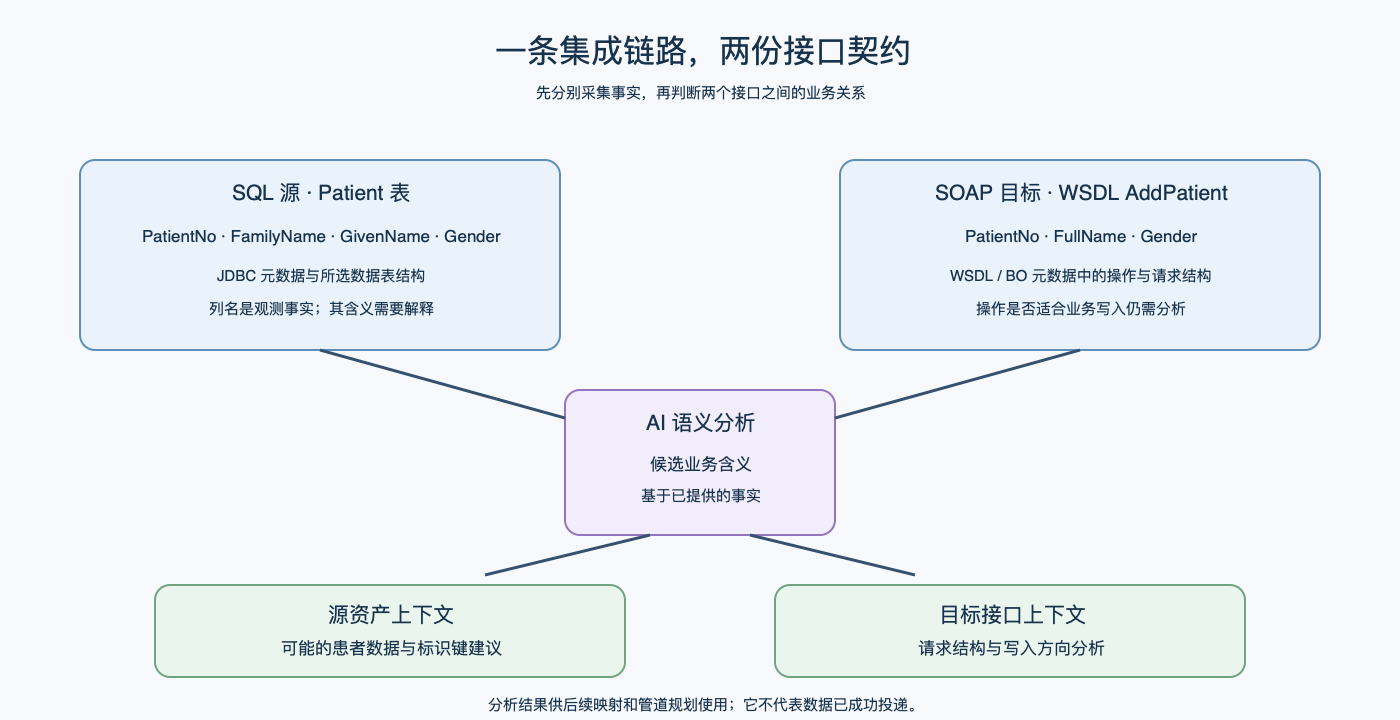
图 2:分别采集 SQL 列和 SOAP 请求契约,再结合上下文进行解释。
结构上已知什么?
对于 SQL 源,平台通过 JDBC 连接,检查选定的表及其列,并记录相关源信息。一行数据可能包含 PatientNo、FamilyName、GivenName 和 Gender 等字段。
对于 SOAP 目标,平台导入 WSDL、生成客户端 BO,并检查 operation 及其请求结构。在演示契约中,AddPatient 接收三个标量字段:PatientNo、FullName 和 Gender。
这些属于接口事实:选定的源和目标定义所暴露的字段名称与结构。但它们尚不能说明,例如 PatientNo 是否就是应该发送的正确业务标识符。
AI 可以帮助解释什么?
基于这些事实,AI 可以分析 AddPatient 是否看起来是写入操作,解释源表可能的业务角色,并找出两个接口之间可能的对应关系。它也可以识别出 FullName 可能需要由 FamilyName 和 GivenName 组合而成,而不是从某个同名源列直接复制。
operation 名称和消息元数据是证据;语义解释仍然是分析结论。名为 AddPatient 的方法是一个有力线索,但仅凭操作名称,不能证明接收端完整的业务行为。仍需结合真实服务契约,必要时还要参考接收系统的文档或实际行为。
本例止于接口理解。确认字段映射、生成组件拓扑、投递请求以及验证持久化值,属于本系列后续文章讨论的步骤。
6. 下游 Agent 如何使用分析结果
接口分析提供上下文,但不会代替用户或其他 Agent 做出所有下游决策。
- Agent A 使用源和目标上下文,提出资产匹配与字段映射建议。管道生成前,这些建议需要经过确认。
- C1 根据可用的结构约束和必填值要求检查映射,必要时修复转换映射。
- Agent B 结合已确认的需求、运行契约和平台登记的能力,选择管道设计 Skill 并生成组件拓扑。
这种职责划分是有意设计的:Agent A 决定哪些数据可能对应;C1 检查转换建议在结构和语义上是否可行;Agent B 则决定如何组织已登记的执行组件,以承载已经确认的集成需求。
把接口上下文传给下游,并不意味着模型可以任意使用它知道的协议或 IRIS 类。管道规划仍受限于平台已登记并支持的能力。
7. 边界、失败场景与观察方法
评估接口分析时,请留意以下区别:
- 可达:端点对探测请求有响应;这不代表接口适合预期的集成。
- 已发现:采集到了结构信息;这不自动代表业务含义已经明确。
- AI 已解释:模型基于给定上下文提出了语义结论;这不等于协议事实,也不等于用户确认。
- WSDL 中存在某个 operation:不代表它就是合适的写入目标。
- 映射已生成或编译成功:不代表目标收到了正确的业务值。
检查接口时,应分别查看所选源资产及其字段、目标 operation 或资源结构、运行契约和 AI 分析。尤其要注意来源:字段是从真实数据中观察到的、从协议定义中读取的、由规范推导的,还是由 AI 推断的?
如果分析失败,应把它当作真实失败,查看报错中指出的 Agent 和原因。不要把空白或不完整的语义结果理解成“接口没有业务含义”,也不要把连通性检查当作语义分析的替代方案。
本演示中的 SQL→SOAP 接收端是一个 Python mock,它会尝试把请求写入 PatientEntity。即使数据库写入失败,它仍可能返回 OK 回执。这也提醒我们:无论接入什么系统,都应核对接收端实际持久化的值。仅凭 SOAP 成功响应或消息已完成,不能证明数据已正确落地。
结语
语义优先的数据集成设计,不是“让 AI 猜接口是什么意思”,而是一套有纪律的顺序:先收集结构和运行证据,再解释这些证据,基于分析结果做映射决策,最后才规划执行方式。
这一顺序有助于区分接口事实、AI 结论和用户确认的意图,为下游 Agent 提供更好的上下文,同时避免凭空引入不受支持的能力,也避免让生成的管道看起来比证据所能支持的更加确定。
Quickstart介绍了如何运行演示,项目仓库包含实现代码。下一篇将进一步介绍平台如何登记集成能力,并将其提供给管道规划使用。