据我了解,HL7消息是基于服务和操作进行索引的。但是,我无法确定索引具体在何时发生,特别是针对操作而言。例如,如果一条消息被放入操作的队列中,它会被索引吗?如果操作未运行,此时它会被索引吗?
我曾看到在转换后的流程中存在已建立索引的搜索表字段,那么这些索引是在哪里生成的?
我尝试阅读了源代码,但未能找到该逻辑所在的位置。
如何为数据库中的数据结构建立索引。
据我了解,HL7消息是基于服务和操作进行索引的。但是,我无法确定索引具体在何时发生,特别是针对操作而言。例如,如果一条消息被放入操作的队列中,它会被索引吗?如果操作未运行,此时它会被索引吗?
我曾看到在转换后的流程中存在已建立索引的搜索表字段,那么这些索引是在哪里生成的?
我尝试阅读了源代码,但未能找到该逻辑所在的位置。
向InterSystems西班牙语开发者社区的所有尊贵成员问好!
虽然我经常查阅开发者社区的内容,也偶尔在这里提问,但这将是我发表的第一篇文章,而参加第三届技术文章大赛无疑是发表首篇文章的最佳契机。
本文将探讨 InterSystems IRIS 为我们提供的各种工具,这些工具既能优化数据库,也能优化我们执行的查询,同时还将介绍新型存储和数据类型。
为了撰写本文,我在一个 InterSystems IRIS Community 实例中搭建了一个小型示例,导入了一个 CSV 文件,其中包含 500 万条记录,这些记录模拟了多年来在不同城市进行的假想销售数据。
表结构将非常简单,但足以满足我们所需的测试。请原谅这些名称,但您也知道,没有什么比临时解决方案更持久的了。
| 月销售额 | 城市代码 | Anyo | 月份 |
| 454323 | 1 | 1995 | 3 |
| ... | ... | ... | ... |
| 城市代码 | 城市 | 自治区代码 | 自治区 |
| 1 | 巴利亚多利德 | 1 | 卡斯蒂利亚-莱昂 |
| ... | ... |
我们将尝试提取像巴利亚多利德这样的城市在某一年的历史平均销售额:
让我们看看查询返回月平均销售额需要多长时间:
结果显示,返回月平均销售额耗时略超过8秒。
太长不读版(TL;DR:):本文演示了如何利用
iris-vector-graph包,完全在 InterSystems IRIS 环境中实现 GraphRAG 风格的混合检索——该方法结合了向量相似度、图遍历和全文搜索。 我们通过一个欺诈检测场景,展示了图模式如何揭示仅靠向量搜索无法发现的问题。
每年,企业和消费者因欺诈损失数十亿美元。仅在2024年,消费者报告的损失就达125亿美元——同比增幅达25%。 现代欺诈之所以难以被发现,是因为欺诈者很少单独行动。他们通过有组织的网络运作,实施协调一致的骗局,利用我们无法察觉看似无关的交易之间存在关联这一弱点。
举个简单的例子:从账户 A 转账至账户 B 的单笔交易看起来完全正常。金额合理,时间点符合常规,且两个账户均未被标记为可疑。传统的基于规则的系统,甚至那些孤立分析交易的机器学习模型,都会毫不犹豫地批准这笔交易。
但如果我们能看到全局呢?
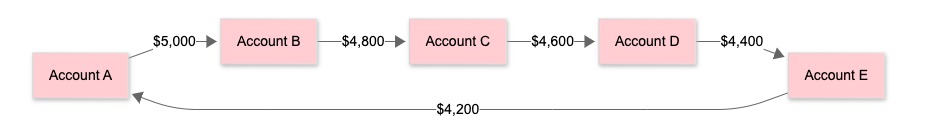
同一笔交易其实是环形模式的一部分——资金在循环流动,每一步都会被截留一小部分。这是一种典型的洗钱结构,对于任何不分析交易关联性的系统来说,都是隐形的。
这一洞见——即欺诈隐藏在关联关系中,而非单个记录中——正是图数据库成为欺诈检测不可或缺工具的原因。
数据库表中索引的力量
在使用数据库时,大多数开发人员都了解索引的概念以及使用索引的原因:加快数据检索速度。但是,索引的真正影响往往只有在比较有索引和没有索引的情况时才会显现出来。
你知道没有索引会发生什么吗?
试想一个有三列的表:姓名、年龄和手机号码。

现在,考虑一下这个查询:
如果年龄列没有索引,数据库引擎会
这意味着引擎会遍历整个数据结构,这对于大型表来说非常耗时。
索引会发生什么情况?
现在,如果年龄列有索引,流程就会发生巨大变化:
这就是为什么索引是如此强大的优化工具。
现实生活中的一课
最近,我们遇到了一个有趣的情况,凸显了索引的重要性。
我们的表有 5 条记录,而年龄列是有索引的。然后,我们错误地从索引结构(而不是主表)中删除了两个条目。这两个条目对应的是 ID X001 和 X005,它们的年龄都是 26 岁。
当我们运行
SELECT ID, Age, EmpId, Mobile, NameFROM Company.Employee WHERE Age = 26
我们预计会有 3 条记录(因为主表中仍有这些记录),但只出现了 2 条记录。
为什么呢?
你好
数据迁移通常听起来像是一个简单的 "将数据从 A 转移到 B 的任务",直到你真正去做。实际上,这是一个融合了规划、验证、测试和技术精度的复杂过程。
我曾在多个项目中负责将数据迁移到在 IRIS(TrakCare)上运行的 HIS 中,在这些项目中,我认识到成功来自于纪律和自动化的结合。
以下是我想强调的几个要点。
1.从定义好的数据格式开始。
在打开第一个文件之前,确保每个人,尤其是数据提供者,都清楚地了解您所期望的确切数据格式。尽早定义模板可以避免不必要的来回奔波和返工。
虽然 Excel 或 CSV 格式很常见,但我个人认为使用制表符分隔的文本文件(.txt)上传数据是最好的。它既轻便又一致,还能避免文本字段内的逗号问题。
PatID   DOB Gender  AdmDate
10001   2000-01-02  M   2025-10-01
10002   1998-01-05  F   2025-10-05
10005   1980-08-23  M   2025-10-15
确保文件中提供的日期格式正确且在整个文件中保持不变,因为所有这些文件通常都是从 Excel 文件转换而来,而 Basic excel 用户可能会在提供错误的日期格式时犯错。错误的日期格式在转换为 horolog 时会让您恼火。
我们最近在向量搜索抢险体验计划中提供了新版的 InterSystems IRIS,新版本采用了新的基于分层可导航小世界 (HNSW) 索引算法的近似最近邻索引。 这一新增功能可对大型向量数据集进行高效的近似最近邻搜索,从而显著提高查询性能和可扩缩性。
HNSW 算法旨在通过构建基于图形的结构来优化高维数据的向量搜索,从而更快地在大型向量集合中找到近似邻。 无论您使用的是推荐系统、自然语言处理,还是其他机器学习应用,HNSW 都能显著缩短搜索时间,同时允许您调整准确度水平,但准确度提高的代价是查询时间变慢。
HNSW 的主要优点包括:
• 即使数据集规模不断扩大,也能加快搜索速度
• 减少内存占用,同时保持高准确度
• 与现有的 IRIS 向量搜索功能无缝集成
最新版本现已通过向量搜索抢先体验计划提供。 要参与,请在此处注册,下载新版本并开始测试。 我们正在持续增强向量搜索的功能,因此您的反馈至关重要!
我们鼓励您探索性能改进方法,并与社区分享您的想法。 如果您在抢先体验阶段遇到任何问题或有任何反馈,请联系我。
祝您编码愉快!
通过在持久类(=table)定义中提供的%BuildIndices() 方法的参数中指定要重建索引的 ID 的开始值和结束值,您可以仅重建该范围内的索引。
例如,要仅针对 ID=10 到 20 重建 Sample.Person 类中的 NameIDX 索引和 ZipCode 索引,请执行以下代码(ID 范围在第 5 个和第 6 个参数中指定)。
set##class%BuildIndices$LB() 是$ListBuild() 函数。 %BuildIndices() 方法使用它来指定索引名称。
有关如何重建索引的更多信息,请参阅文档。
2018.1版本请参考此文档。
你好!
我想知道,如果在没有运行%BuildIndices()方法的情况下向表中插入索引,是否会有问题。
需要注意的是,在索引之前插入的数据对于检索来说并不重要,所以在索引之前插入的数据在查询中不显示并不是问题。
我问这个问题的原因是,我想避免在需要插入这种索引的大表中进行索引重建。
我正在使用Cache 2018.1。
谢谢。
José
Hi!
I'd like to know if there are any issues if an index is inserted into a table without running the %BuildIndices() method.
It's important to note that data inserted before the index is not important for retrieval, so it's not a problem data inserted before the index don't show up in queries.
The reason why I'm asking this is that I'd like to avoid index reconstruction on big tables which I need to inser such index.