“AI 提出建议,代码做决定”:在 AI Hub 上构建用于 IRIS 互操作性的受控分诊代理
每个 IRIS 互操作性团队都熟悉这样的晨间例行工作:打开消息查看器,找出标记为红色的行,阅读错误信息,检查组件设置,然后决定是重新发送、修正数据还是联系相关人员。我想了解,**在绝不允许中断生产环境的情况下,**AI Hub 代理能接管其中多少工作。
最终成果便是“互操作性分诊”(Interop Triage),这也是我参加“互操作性工作流中的 AI 代理”竞赛的参赛作品。 当消息处理失败时,一个 %AI.Agent 会使用只读工具进行排查,并提出四种处理方案之一:重试、修复并重发、丢弃或上报。 确定性规则将决定该建议是直接执行、等待人工处理,还是上报。本文将探讨设计决策、模型让我感到意外的时刻,以及我在 AI Hub 154 版本中获得的经验。
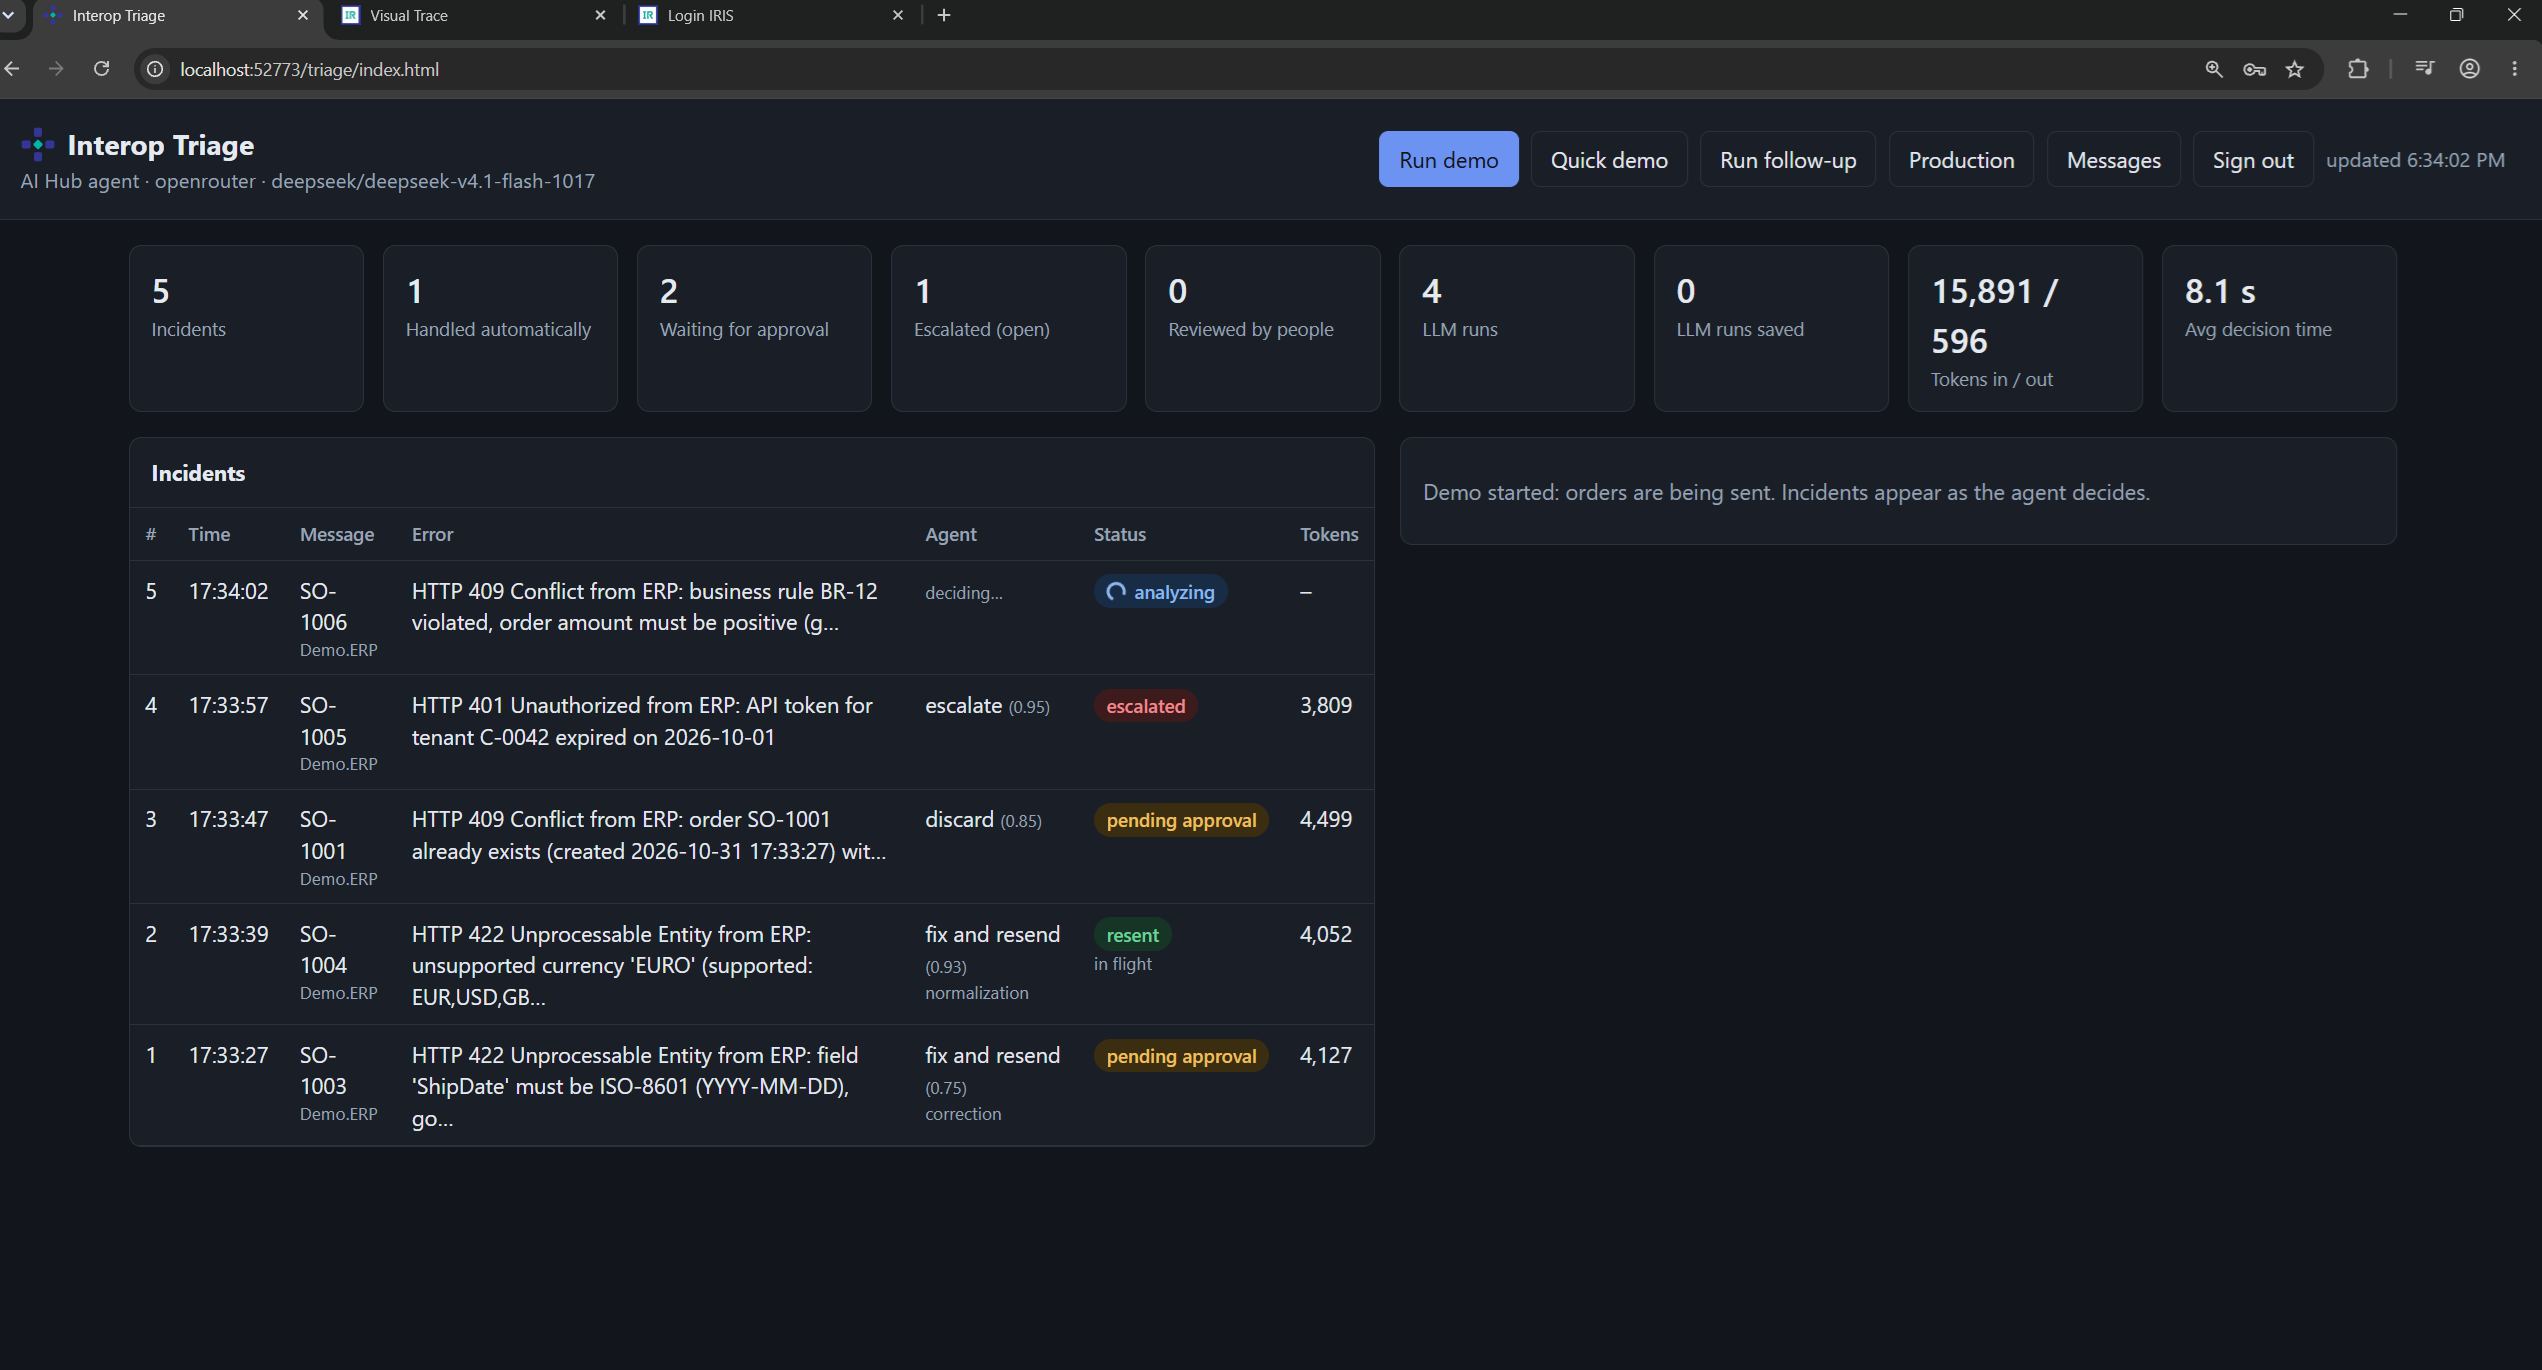
“运行演示”正在执行时的仪表盘:每条失败的消息都会显示代理的建议、其置信度、规则确定的状态以及消耗的令牌数量。
为什么在制作中使用自主人工智能会令人感到恐惧,以及我是如何针对这一问题进行设计的
第一个版本的表现和其他演示一样:ERP系统因以下原因拒绝了一笔订单: ShipDate 格式为 21/11/2026 而非 ISO-8601 标准,代理以极高的置信度将其重写为 2026-11-21,重新发送后,订单便成功通过。 这看起来很棒。随后我问自己一个简单的问题:**代理如何确定 21 不是输入错误?**如果客户本意是 10/11/2026,代理就会生成一份日期错误但完全有效的订单,而谁都不会察觉。
这个问题塑造了整个项目。代理可以查看所有内容,但它不能更改任何内容:
- 其工具均为只读模式:会话的事件日志、故障组件的设置(其中机密信息已被屏蔽)、尝试历史记录、近期类似故障、精确的错误代码查询,以及两个知识库。
- 它通过一个工具
submit_decision进行响应,包含操作、原因、置信度,以及针对修复方案的字段级 JSON 补丁。 Triage.Policy会评估该建议,并返回EXECUTE、APPROVAL或ESCALATE。它采用纯 ObjectScript 编写,由 83 个%UnitTest断言进行覆盖。
这些规则是分诊流程中的生产环境设置,因此每个团队均可自主选择:
| 设置 | 默认值(演示值) | 含义 |
|---|---|---|
| `AutoActions` | `RETRY,ESCALATE`(同上) | 可能在无人干预的情况下运行的操作 |
| `AutoFixFields` | 空(`Currency,Warehouse`) | 已声明的*规范化*可能自动运行的字段 |
| `ProtectedFields` | 空 (`OrderId,CustomerId,Sku`) | 补丁绝不能修改的字段 |
| `MinConfidence` | `0.7`(同上) | 在其下方,一切都在等待审批 |
处理人员还必须说明所提议的修正类型。规范化操作会保留数值并改变其形式(EURO → EUR)。 而更正则会改变数值(例如重新排序日期)。只有针对白名单字段的规范化操作才会自动执行;更正操作则始终需要人工处理。
人工审核人员也可以表示不同意。 在仪表盘中,拟议修补方案的每个值都是可编辑字段:如果客户通过电话确认了22号,操作员会修改日期、填写原因,然后点击**“批准并保留我的修改”**。操作员的修补方案需遵循与处理人员相同的规则,因此即使人工提出请求,受保护字段的修改也会被拒绝。
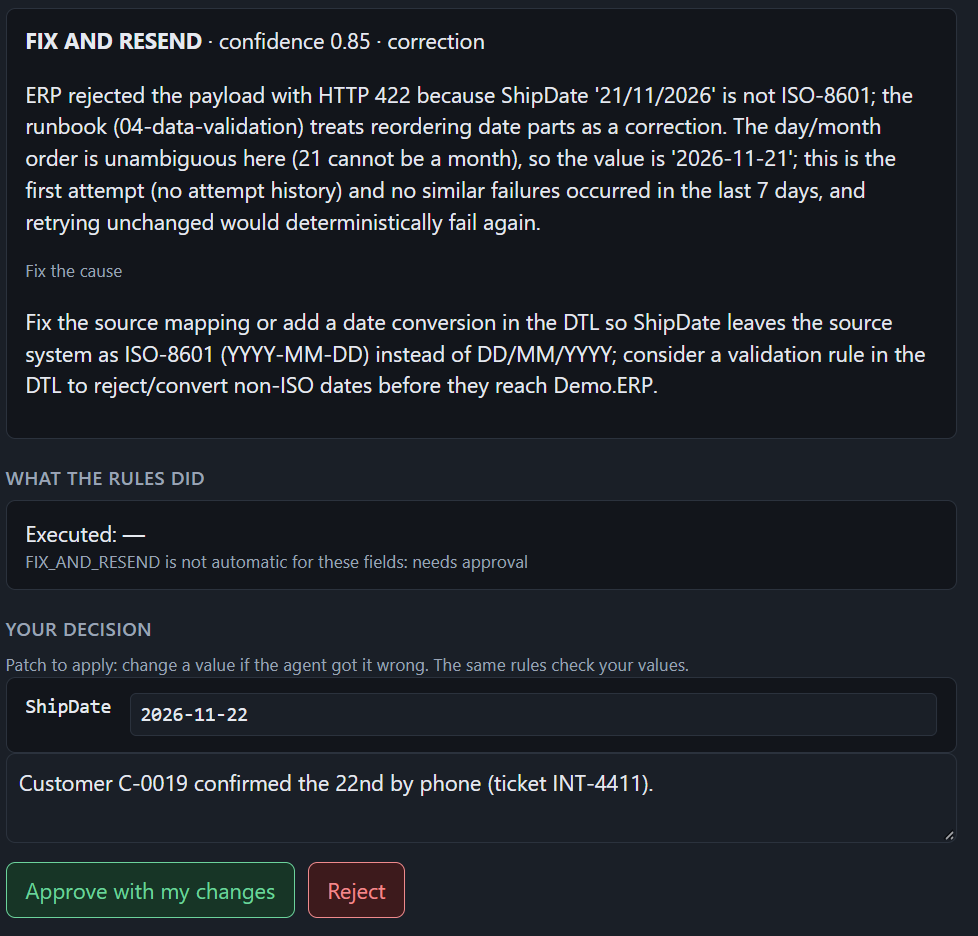
SO-1003 正在等待审批,因为更改日期属于更正操作。操作员将建议的 2026-11-21 修改为 2026-11-22,填写原因后,按钮将变为“按我的修改批准”。
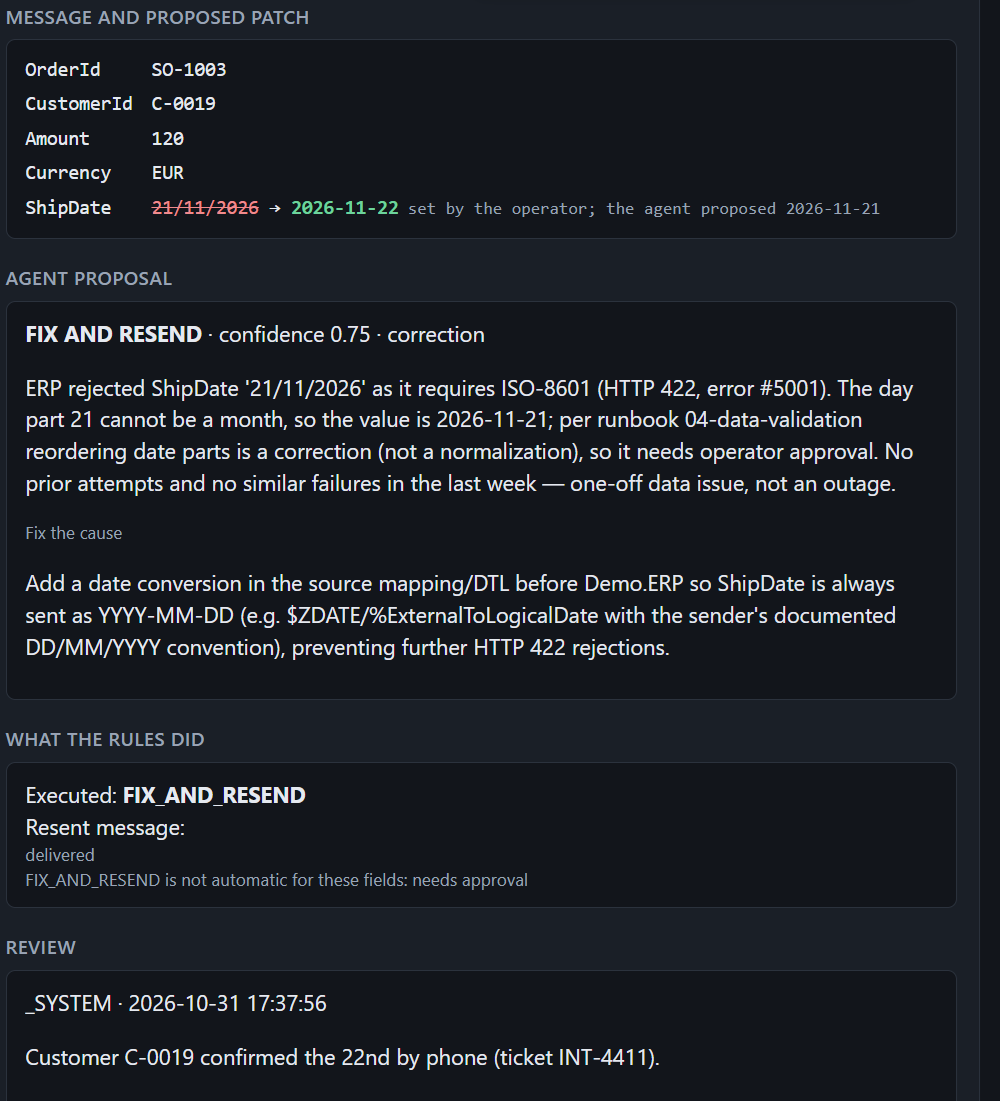
审批通过后:订单将按操作员修改后的日期重新发送并已送达,该工单同时保留了代理人的提案和审核记录。
互操作性优先,人工智能次之
分流过程没有硬编码的消息类:它会通过类反射和消息头,打开任何处理失败的消息。 为了证明这一点,该演示程序监视了两个不同的工作流:ERP订单(OrderRequest)和仓库库存移动(StockUpdate),这两者都是通过真实的 EnsLib.HTTP.OutboundAdapter 操作发送至 REST 端点,这些端点会像真实系统一样出现故障。
一位经验丰富的 IRIS 工程师会问:既然业务操作已经具备 RetryInterval、FailureTimeout 和 ReplyCodeActions,为什么代理还要处理重试? 他们说得没错,在此设计中,原生机制总是优先运行。短暂的网络故障将由操作自身的重试机制解决;不会触发警报,也不会消耗令牌。
当中断持续时间超过 FailureTimeout 时,代理才会介入。 如果在业务操作内部等待更长时间,将会阻塞其队列(通过 PoolSize=1 进行队列首端阻塞),因此消息会切换到 Ens.Alert,队列继续处理,而分诊流程会使用Ens.Alarm。当告警响应时,OnResponse 会通过 Ens.MessageHeader.ResendDuplicatedMessage 在 Visual Trace 的同一会话中重发原始消息。
静态的 RetryInterval 还无法实现以下两点:
- **自适应延迟。**当 WMS 通过
503返回Retry-After: 30时,同一代理会等待 30 秒;而对于断开的套接字,则会等待 60 秒或更长时间。 - **警报风暴。**对于具有相同错误特征(组件加上不含 ID 和编号的错误文本)的故障,系统会复用一个决策而非再次调用 LLM,并且其重发操作会错开时间,以确保正在恢复的系统不会一次性收到所有积压的消息。
每项人工操作也会进入生产流程:审批需通过业务服务,因此可视化追踪会将警报、代理呼叫、审核和重发显示为同一会话的步骤。
升级处理使用 IRIS 现有的工作流引擎。每个被升级的事件都会成为角色 Triage.O perators 的 EnsLib.Workflow 任务,其中包含错误信息、代理的诊断结果以及建议的修复方案。 操作员可以在标准的 IRIS 工作流收件箱中或 在仪表盘中解决该问题:无论哪种方式,事件都会被关闭,且操作员的备注将加入客服代表的记录中。
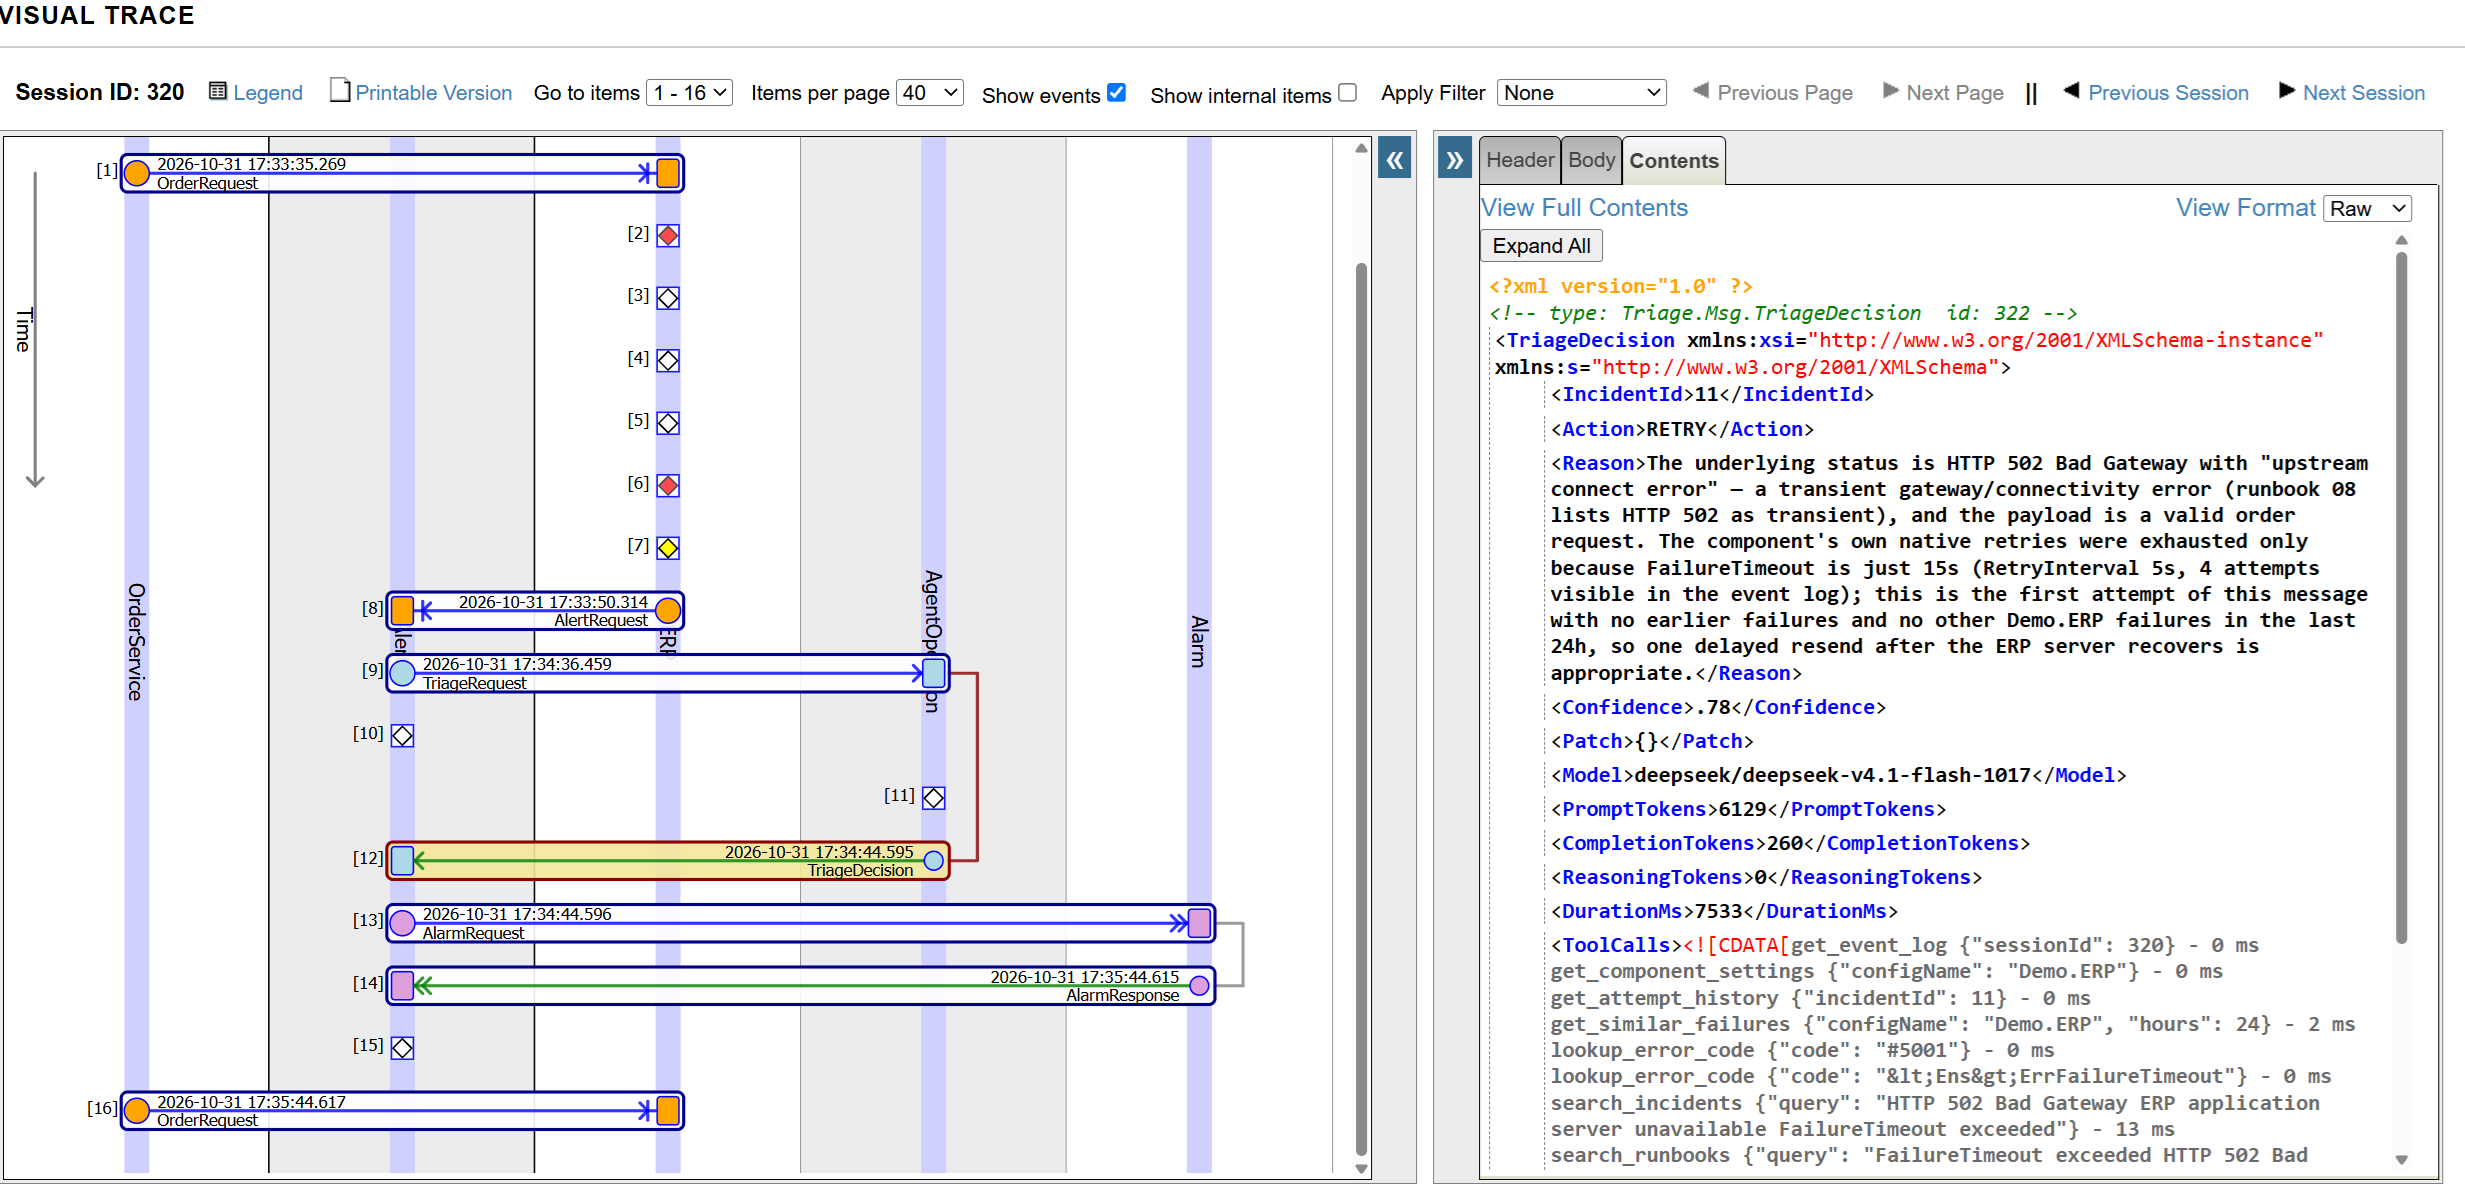
延迟重试的可视化追踪:失败的订单、警报、代理的执行过程、Ens.Alarm 等待 60 秒以及重发操作,均在同一会话中呈现。右侧显示了代理的 TriageDecision,其中包含原因、模型、令牌、持续时间及工具调用(包括向量搜索)。
模型四次让我大吃一惊
它抓住了我的作弊行为。为了模拟服务中断,我首先将HTTP适配器指向了 localhost:1。代理将该错误与组件设置进行比对后得出结论: “该操作正在呼叫 localhost:1 而不是配置的 HTTPPort……属于端点配置错误,而非临时故障”,并上报了该问题。它的判断是正确的。我如实重构了模拟:在故障期间,演示版 ERP 现在会通过其网关响应 502。
它还纠正了我的设计。在早期的一次运行中,代理在遇到服务中断时选择了“升级”而非“重试”,其理由是*“手动重发将持续失败*,直到目标主机恢复可用”。 我的 RETRY 是立即执行的,因此它的推论有其道理。这就是通过 Ens.Alarm 进行延迟重试的由来。
系统出现了误分类,但规则依然成立。在 Gemini 2.5 Flash 中,对 21/11/2026 的重新排序被归类为规范化操作。 但它仍然没有自动运行,因为 ShipDate 不在 AutoFixFields 之中。切勿仅依赖模型的自我分类:操作、字段、修复类型和置信度都会被独立验证。
**其描述性文本并不构成合同。**在 DeepSeek 上对最新版本进行实时测试时,我遇到了两个根源相同的错误:模型遗漏了一个可选参数。
- 在
503与Retry-After: 30的组合中,原因显示*为“30 秒后单次延迟重发”,*但该调用并未产生延迟,且默认行为应为“立即重发”。 现在,Retry-After是由Triage.Policy强制执行的下限,而缺失的延迟会等待MinRetryDelay。 HTTP 允许将Retry-After表示为秒数或日期(RFC 9110);日期格式由一个小型嵌入式 Python 方法进行解析:
  ClassMethod SecondsUntil(httpDate As %String, now As %String = "") As %Integer [ Language = python ]

  {

      from datetime import datetime, timezone

      from email.utils import parsedate_to_datetime


      def parse(text):

          when = parsedate_to_datetime(text)

          return when if when.tzinfo else when.replace(tzinfo=timezone.utc)

      try:

          when = parse(httpDate)

          base = parse(now) if now else datetime.now(timezone.utc)

      except (TypeError, ValueError, IndexError):

          return 0

      return max(0, int((when - base).total_seconds()))

  }
- 在另一笔订单中,模型遗漏了
fixType。 我的工具拒绝了该调用,模型随后连续发送了七次相同的调用,直到 AI Hub 通过<%AICore>LoopDetected终止了该循环,运维团队也对此事件进行了升级处理。现在,缺失的fixType已被记录为*“更正*”,这是最保守的分类。
后来,DeepSeek 通过 OpenRouter 曾将 submit_decision 调用以文本形式(采用其自身的标记语言)写入,而非调用该工具。系统未执行任何操作,该事件也按规定进行了升级。现在,对于缺失的决策,在升级前会在同一会话中收到一次提醒。
经验教训:大语言模型(LLM)使用的工具不应拒绝其能够谨慎解读的内容,因为拒绝会导致模型重复执行相同操作。而真正重要的内容必须由代码来保证,而非依赖模型在理由中写下的内容。
IRIS 中的受控内存与 RAG
知识存储在IRIS中,无需外部向量数据库:
lookup_error_code在 SQL 中属于精确查找。 对于ERROR #6059或HTTP 422这样的代码,小型嵌入向量并不可靠,因此会通过 IRIS 错误文本和运行手册标签对代码进行精确匹配。search_runbooks是一个采用 FastEmbed 嵌入(384 维)和 IRIS 向量存储的%AI.RAG.KnowledgeBase,基于我编写作为通用流程的十份运维运行手册:瞬态中断、Retry-After、日期更正与标准化处理、重复项、过期凭证。search_incidents是第二个包含历史事件的知识库,也是我最重视的一个。
关于记忆的核心问题是:代理在处理不同案例时应该记住什么?如果它记住了自己的自动决策,那么一个错误的决策就会成为下一次决策的依据。因此,只有经过人工审核的事件才会被索引:批准、拒绝或附带注释后解决。操作员的注释,以及如果他们进行了修改所对应的补丁,都会成为记忆的一部分。
它运行得正如我所期望的那样。在我批准了将日期更改为22日的SO-1003后,来自同一客户的后续订单显示为28/11/2026。 系统建议采用2026-11-28,而非22日:它复用了对日期的格式识别结果,而非那次一次性修改。并且,系统引用了已审核案例中实际汲取的经验: **“注意案例1:对于同一客户C-0019,操作员在电话确认后不得不更改建议的日期(2026-11-21 → 2026-11-22),因此请在重新发送前核实日期。”其上游建议将其称为“客户 C-0019 在 7 天内第二次出现相同的格式错误”,**并建议在源映射或 DTL 中转换日期,这才是真正的修复所在。
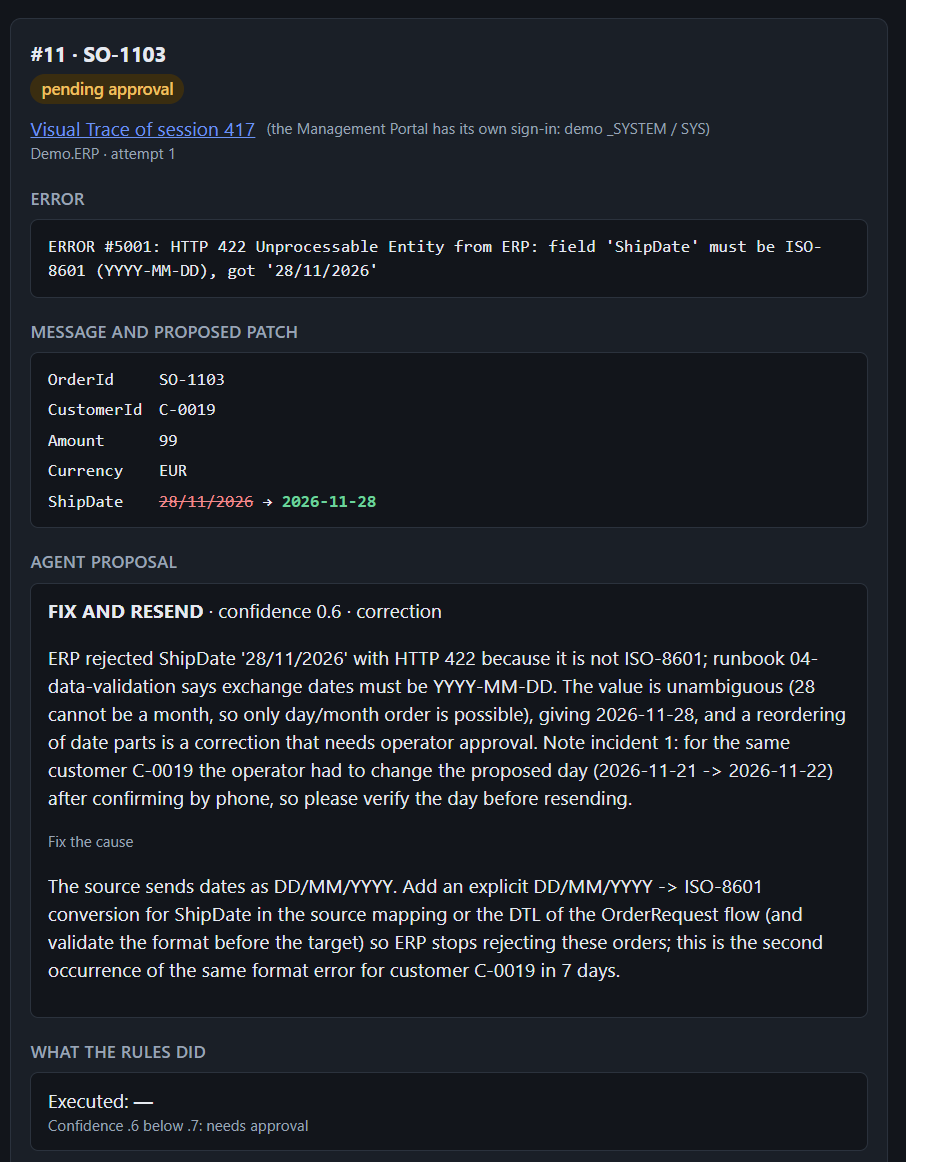
后续工单 SO-1103:处理人员查阅了已审核的事件 1(SO-1003),建议将日期改为 2026-11-28 而不是照搬操作员的一次性日期,要求核实具体日期,并指出应在源头进行修复。
可观测性、代币经济学与模型选择
每次工具调用都会由一个 %AI.Policy.Audit 子类进行持久化存储,其中包含参数、结果、持续时间以及所属的事件。 一个 %AI.Policy.Authorization 子类将代理的范围限定在其自身的事件和会话内:恶意有效载荷无法使其读取或处理其他事件。仪表盘针对每个事件显示原因、证据、工具调用、代币以及重发消息的结果。
根据社区提案 DPI-I-689(将互操作性作为 LLM 管道的追踪工具),相同的追踪记录也存在于生产环境中。 代理的响应消息按顺序包含模型、令牌、持续时间及工具调用(包括向量搜索查询),因此在“可视化跟踪”中打开代理的步骤时,会在失败消息、重试和审查旁边显示完整的 LLM 运行过程。 没有任何数据会被发送到外部追踪服务:提示词和有效载荷都保留在 IRIS 中,且追踪记录可直接引导至具体操作。
通过 OpenRouter 采用 deepseek/deepseek-v4.1-flash-1017 进行测试,涵盖两个演示系统中的十个场景:
| 指标 | 值 |
|---|---|
| 预期决策 | 每次运行均达到10/10 |
| 每次决策的延迟 | 平均约6–9秒 |
| 每次决策的工具调用次数 | 3–10 |
| 每项决策的输入令牌数(不包含知识库) | 约1,700 |
| 每次决策的输入令牌数(包含运行手册和记忆) | 约 3,800–5,000 |
知识库会消耗令牌:知识库消耗的令牌量是提示词的两倍多。我保留了它们,因为正是它们使得理由中能引用相关流程和过往事件。
关于模型的一些说明。Gemini 2.5 Flash 仅用约 1.9 秒就回答了一个最简提示,而 gemini-3.8-flash 则耗时70秒。Gemini免费层每款模型每天限20次请求,而完整演示需要30–40次,因此README文件提供了一个包含三个场景的快速演示。 我还评估了 AI Hub 的子代理和规划功能:一个配备原子工具和确定性规则的单一代理已经达到了 10/10 的评分,而将其拆分将会成倍增加 LLM 的往返次数。
最后,该项目无需任何密钥即可运行。在重放模式下,代理会重复 LLM 在经过验证的实时运行中针对同一故障发出的工具调用,但这些工具会基于当前数据重新运行,且策略、重试和审批均为真实操作。仪表盘上会通过横幅标注此信息,因此无人会将重放误认为实时决策。
AI Hub 的双向交互,以及关于构建版本 154 的现场笔记
同一个项目中AI Hub被调用两次。在IRIS内部,由 %AI.Agent 做出决策。 对外,%AI.MCP.Service向操作员的AI助手提供与仪表盘相同的视图和操作:列出事件、阅读某项事件、批准(可选:附带修改后的补丁)、拒绝、解决。授权策略要求每次写入操作都需附注,且拒绝操作会被记录在案。
代理本身仅需几行声明式代码。提供商、模型和密钥来自 .env,工具来自 %AI.ToolSet,而策略则针对每个事件附加如下:
Class Triage.Agent.TriageAgent Extends %AI.Agent
{
Parameter PROVIDERCONFIG = "{""model_provider"":""@{env:LLM_PROVIDER}""}";
Parameter APIKEY = "@{env:LLM_API_KEY}";
Parameter TOOLSETS = "Triage.Agent.Tools";

/// Audit (every call logged for this incident) and authorization (only this incident and session).
ClassMethod AttachPolicies(tools As %AI.ToolMgr, incident As Triage.Data.Incident) As Triage.Agent.AuditPolicy
{
    set audit = ##class(Triage.Agent.AuditPolicy).%New()
    set audit.IncidentId = incident.%Id()
    do tools.SetAuditPolicy(audit)
    set scope = ##class(Triage.Agent.ScopePolicy).%New()
    set scope.IncidentId = incident.%Id()
    set scope.SessionId = incident.SessionId
    do tools.SetAuthPolicy(scope)
    quit audit
}
}
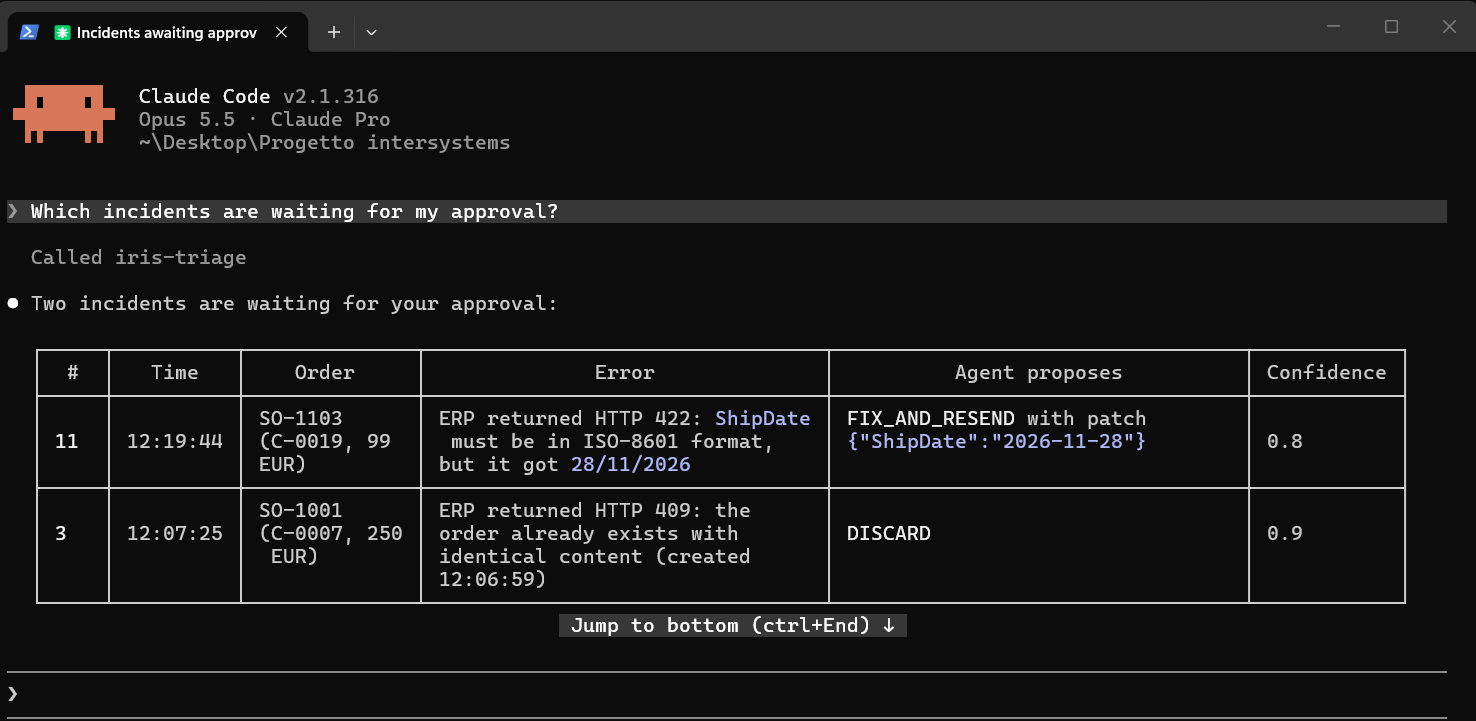
Claude Code 会向分流 MCP 服务器查询哪些事件正在等待审批,并显示每位客服代表的处理建议。如果未附注释就批准某项建议,系统将根据与仪表盘相同的规则予以拒绝。
在 154 版中运行良好的功能:
- 声明式代理。
PROVIDERCONFIG借助@{env:...},我只需编辑.env即可从 OpenRouter 切换到 Gemini。 - 基于方法签名的工具,以及将策略附加到 ToolSet 而非提示符上。
- 几分钟内即可完成RAG 配置,知识库可通过
%AI.ToolMgr进行查询,无需依赖 LLM,这使得测试变得非常简单。 - 循环保护机制能够自动停止卡住的模型。
需要采取变通方案的情况:
%AI.Agent上没有记录在案的结构化输出,因此决策工具就是结构化输出本身。KnowledgeBase.AddDocument不会拆分长文本,因此我根据标题将运行手册拆分。KnowledgeBase.AddDocument在不同提供商之间存在差异:Gemini 仅在总数中报告推理令牌。- 对于同一调用,call.arguments 在审计策略中以 JSON 字符串形式出现,而在授权策略中则以对象形式出现。
- 最有趣的一点是:当前版本的 Claude Code 会首先发送一个
server/discover探测请求,以检查是否存在更新的 MCP 协议。iris-mcp-server2.0.0 会正确返回“不支持的协议版本”响应,但随后会保持无状态模式,因此后续的常规会话将无法连接。 我是通过在两者之间插入一个日志代理发现这一现象的,并通过一个小型代理进行了绕过——该代理会自行响应探测请求,并将其他所有内容直接转发。我已将此问题报告为ai-hub-eap#39。所有详细信息均在该代码库的AI Hub 反馈页面中。
使用 IRIS Agentic Dev 进行开发
在项目的后半段,我使用了 IRIS Agentic Dev 配合 Claude Code 进行开发。 只需一条命令即可编译本地文件,并以结构化错误报告的形式显示结果;运行代码、读取生产状态、事件日志和队列信息(均以 JSON 格式呈现),这些功能取代了大量 docker exec 和 iris session 脚本。 唯一的问题是:iris_test 报告称已编译的测试类没有测试,因为它会在 ^UnitTestRoot 目录下查找文件,所以我改用 iris_execute 运行了测试套件。
在整个过程中,我始终使用 AI 助手来处理代码、代码审查和文档编写,并让第二个模型对设计进行了两次审查。塑造该项目的决策源于对它们答案的质疑:21 是否可能是笔误、为什么操作不应自动重试、以及代理应被允许记住什么。 本文中的每一个数字都来自我亲眼观察的一次运行。
试试看
该项目在 AI Hub 构建 154 镜像上运行,参数为 docker compose up;若您没有密钥,请使用回放模式。快速演示将在约一分钟内展示一次批准、一次自动修复和一次延迟重试。
- GitHub:https://github.com/FilippoGalli001/Interop-Triage
- Open Exchange:https://openexchange.intersystems.com/package/Interop-Triage
- 视频:https://youtu.be/26HSLGr6XHc
我很乐意听听大家在自己的制作中会如何管理代理。