#AI Coding

0 关注者 · 20 帖子

此标签涵盖 AI 编程智能体(包括 Claude Code、Codex 和 GitHub Copilot)、Model Context Protocol(MCP)服务器以及智能体 Skills 在 InterSystems 技术中的应用,用于提升软件开发、系统管理和故障排除的效率。

文章 Nicky Zhu · 十一月 17 12m read

从能力目录、设计 Skill 到受控工具与验证闭环

“从 SQL 读取患者行,转换后调用 SOAP 服务”,听起来是 LLM 应该能理解的任务。但理解 SQL 和 SOAP,不等于能构建可运行的集成。

本平台允许使用哪些 IRIS 组件?它们交换什么消息?哪些设置属于 Adapter,而不是 Host?目标导入 WSDL 后生成了哪个类?又该用什么证据证明患者数据到达接收端?

这些是开发者需要提供的工程事实,不该让模型凭空猜测。

六篇主线解释了这个演示系统如何工作。本篇转向开发者视角,讨论怎样构造背后的能力与决策边界。以 Agent B 的 SQL→SOAP 规划路径为主例,再用 C2 对照说明有界工具协调。

1. 先定义 Agent 的工作,而不是先写提示词

角色名称不等于执行机制。先明确一份契约:

问题 Agent B:规划 C2:修复协调
工作是什么? 选择设计 Skill,提出组件拓扑 根据阻断故障证据选择受支持的处理动作
输入是什么? 已确认映射、源/目标事实、运行契约、可用组件与适用 Skill 脱敏检查、组件与管道身份、映射发现和此前尝试
输出是什么? 结构化规划 JSON 问题评估与一个修复动作
谁执行? 平台编排与 IRIS 受控工具分发,随后生成与复验
什么证明成功?
0
0 8
公告 Claire Zheng · 十一月 16

大家好,

现在是时候公布“InterSystems编程大赛:互操作性工作流中的AI Agent”的获奖名单了! 

非常感谢42位参与者提交了

🌟44 个参赛作品🌟 

本次竞赛要求开发者构建一个 IRIS 互操作性工作流,利用 AI Hub 代理来处理决策任务。探索这些项目并见证它们引发的讨论,真是令人兴奋。

现在,让我们来认识一下获奖者吧!

0
0 20
文章 Nicky Zhu · 十一月 10 13m read

IRIS Production 可以成功生成、编译并启动,但集成仍可能出错:映射可能产生错误值;消息完成不一定代表预期数据已正确落地;组件也可能因为许可调度而存在于 Production 中却处于停用状态。

承接上一篇《从组件拓扑到 IRIS Production:生成、编译与启动》,作为主线系列的收尾篇,本文讨论生成之后如何解读验证证据、平台如何响应检查结果,以及管道如何在长期运行中保持可管理。本文不再逐步讲解常规消息处理过程。

1. “已生成”不等于“能正常工作”

我们经常把几个不同的问题混为一谈:

  • 拓扑中是否包含管道所需的组件和关系?
  • IRIS 是否加载并编译了 Production 定义?
  • Production 是否正在运行,这条管道的组件是否启用?
  • 相关消息是否正常流转,没有运行错误?
  • 目标端是否出现预期结果,而且值正确?

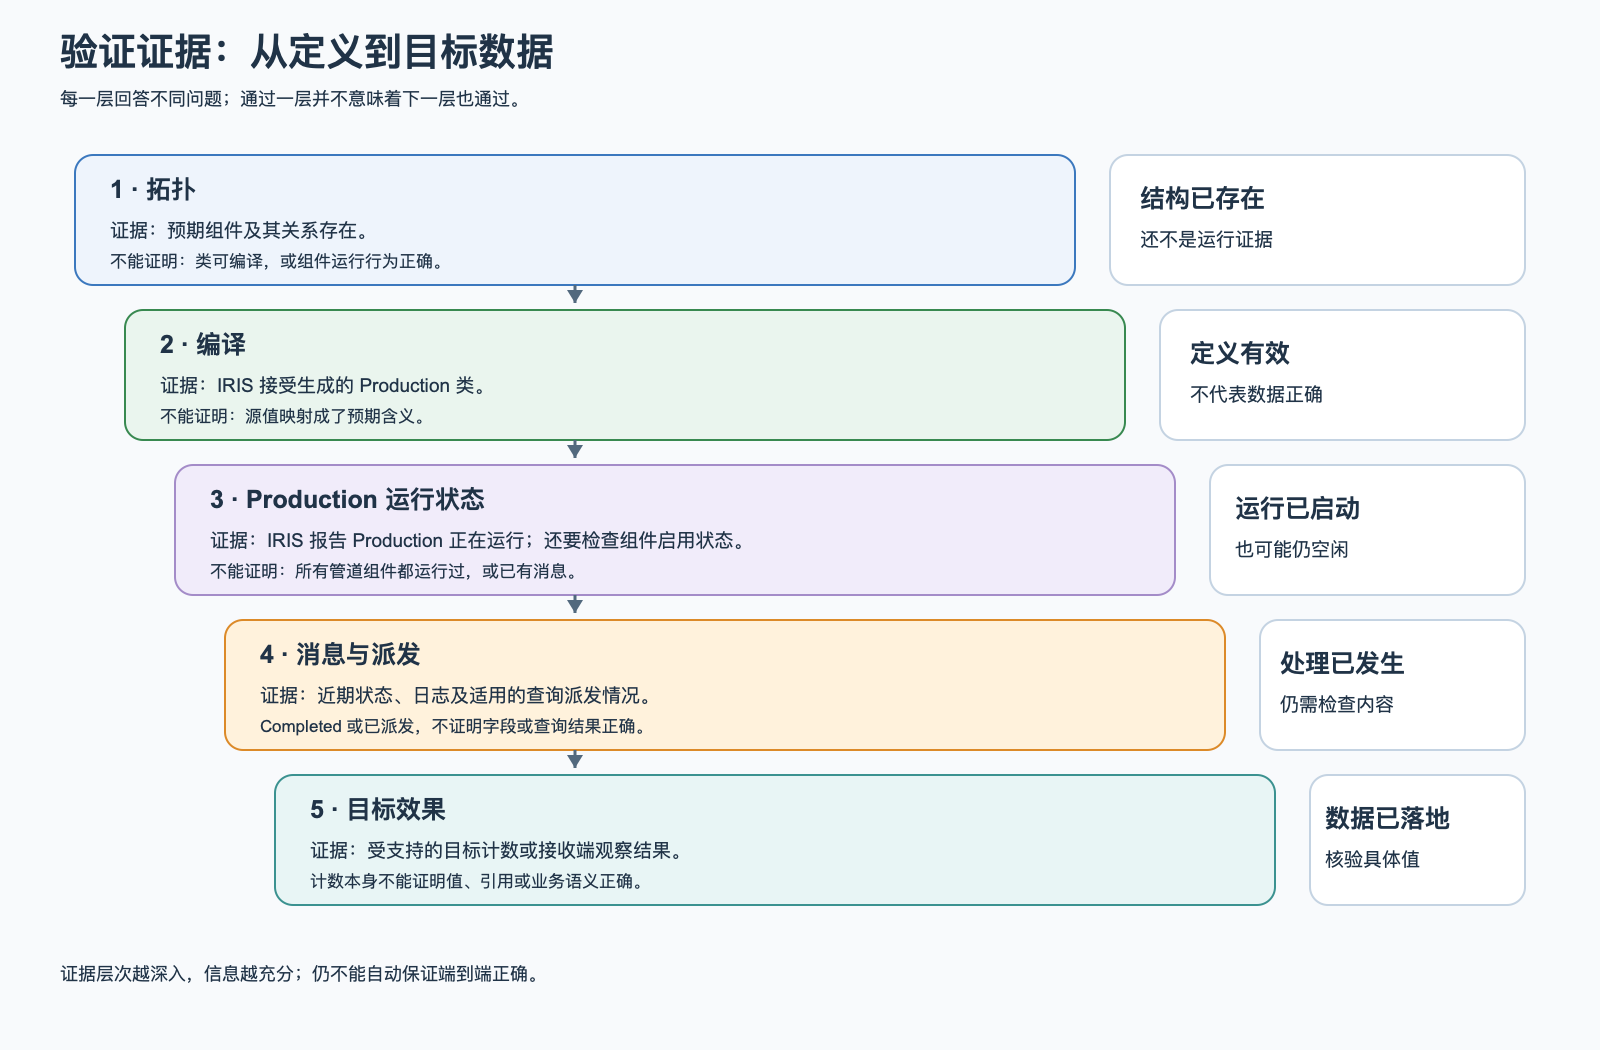
每个问题都需要各自的证据。某一层的检查通过固然有用,却不能替代下一层的检查。编译成功无法证明映射在业务语义上正确;Production 正在运行无法证明源端已经产生消息;消息已完成也无法证明每个目标值都正确。

验证证据是分层的:每项检查回答不同的问题

图 1:证据从定义有效性逐渐深入到目标数据观察;任何单一层都不足以证明端到端正确。

2. 验证不是一个绿灯,而是一组检查

生成链路会汇总一份事实验证报告。根据管道类型和可用证据,报告可能包含:

  1. 拓扑:预期的组件类型与关系是否存在?
0
0 19
公告 Claire Zheng · 十一月 9

Hi 开发者们,

投票时间到了!请浏览参赛作品,并在“InterSystems编程大赛:互操作性工作流中的 AI Agent”中投出您的一票:

🔥为您最喜爱的应用投票🔥


投票时间:2026年11月9日 - 11月15日 (美国东部时间)

如何投票?详情如下。

0
0 18
文章 pan John · 十一月 4 6m read

在一项针对模拟医疗决策的随机研究中,仅凭大型语言模型(LLM)的强劲表现,并不能直接转化为使用这些模型的人员做出更优的决策。 阅读《自然·医学》上的这项研究。

**AI辅助使得构思和构建软件变得更加容易。**一个人可以描述一个问题,智能代理可以提出架构方案,双方共同探索那些在僵化的规格说明中可能永远无法涌现的解决方案。他们不同的声音、品味和建立联系的方式,正是创造力的源泉。

一个听起来合理的想法,并不意味着系统就行为正确。

语言模型可能自信地描述一个并不存在的API,从成功的HTTP响应中推断出成功,或者为它从未验证过的结果给出看似合理的解释。 人在疲劳、时间压力或信息不完整的情况下,也会犯类似的错误。当二者快速协作时,彼此的自信会相互强化。此时,产品就需要一种独立的方式来回答:请求了什么?实际发生了什么?还有哪些未知?

一起公开事件让这一区别难以被忽视。2025年, SaaStr创始人杰森·莱姆金(Jason Lemkin)描述了Replit的一款编码代理在宣布的代码冻结期间删除了其应用程序的生产数据库。 Replit的首席执行官承认了此次删除事件,并宣布将着手分离开发数据库和生产数据库。我从中得到的启示是:对话中的指令无法完全承担技术边界的全部责任。一个代理不应仅仅因为承诺过不触碰生产数据,就能够访问生产数据。

0
0 17
文章 pan John · 十一月 2 4m read

OcuPilot

在开发 OcuPilot(https://openexchange.intersystems.com/package/OcuPilot)——一款用于 IRIS 管理门户的人工智能副驾驶——的过程中,我为测试运行了大量短暂存在的 IRIS 容器。 这些容器将数据保存在我 Mac 上的 /tmp 目录下的文件夹中,因为那里是临时文件的存放位置。三天后,其中一个容器开始出现莫名其妙的故障:一个仍显示为已挂载的临时数据库背后实际上没有对应的文件,且向其写入数据时会失败。

我起初怀疑是 IRIS 的问题,随后又怀疑是自己的代码出了问题。但事实并非如此。这其实是 macOS 完全按照其设计原理在正常运行。

macOS 的工作原理

每天午夜,macOS 会运行一个小型清理任务,删除 /tmp 目录下超过三天无人触碰的文件。 这是 macOS 自身的一部分,对于临时文件夹来说也是合情合理的。它只检查 /tmp(实际上是 /private/tmp),且不关心文件的具体内容。

为什么 IRIS 数据库特别容易受到影响

IRIS 将您使用的数据保存在内存中,仅在发生变更时才写入数据库文件。我对此进行了测试:读取数据库(即使是全部读取),文件的时间戳也完全保持不变。 因此,对于仅被读取或完全未使用的数据库,清理任务会将其视为未被触及,三天后该文件便会消失。

0
0 16
文章 pan John · 十一月 2 14m read

每个 IRIS 互操作性团队都熟悉这样的晨间例行工作:打开消息查看器,找出标记为红色的行,阅读错误信息,检查组件设置,然后决定是重新发送、修正数据还是联系相关人员。我想了解,**在绝不允许中断生产环境的情况下,**AI Hub 代理能接管其中多少工作。

最终成果便是“互操作性分诊”(Interop Triage),这也是我参加“互操作性工作流中的 AI 代理”竞赛的参赛作品。 当消息处理失败时,一个 %AI.Agent 会使用只读工具进行排查,并提出四种处理方案之一:重试、修复并重发、丢弃或上报。 确定性规则将决定该建议是直接执行、等待人工处理,还是上报。本文将探讨设计决策、模型让我感到意外的时刻,以及我在 AI Hub 154 版本中获得的经验。

0
0 12
文章 Nicky Zhu · 十月 28 6m read

上一篇讨论了 AI 如何提出源数据到目标字段的映射建议。但映射本身并没有说明:运行中的集成如何读取一行数据、转换一条消息,或把请求投递到目标。

接下来要回答的是:应该由哪些组件来完成集成?这些组件又该如何组合?

在 DataPipelineDemo 中,管道规划师 Agent B 并不是从空白开始设计。平台会向它提供一组受控的组件类型、相关的管道设计知识,以及当前请求的集成需求。Agent B 根据这些上下文提出拓扑,平台再补充配置并检查结果是否可用。

本文沿着这条运行时路径展开。如何由开发者构建和登记组件定义、设计 Skill,将留给后续的开发者专题。

1. 映射和拓扑回答不同问题

已确认的转换映射描述信息应该如何对应。例如,如何把 SQL 中的 FamilyName 和 GivenName 组合成 SOAP 请求中的 FullName。

管道拓扑描述执行集成所需的组件,以及它们之间的关系。典型的 SQL→SOAP 数据流中,SQL Service 读取数据行,转换流程准备请求,SOAP Operation 再将请求发送到目标。

这两者缺一不可。映射合理,不代表已经具备数据流转路径;组件连接有效,也不能证明映射后的值符合业务语义。

2. 两类能力上下文

Agent B 会接收两类预先准备好的能力信息,它们回答的是相关但不同的问题。

类型注册表:有哪些可用组件类型?

0
0 18
公告 Claire Zheng · 十月 26

我很高兴向大家介绍 ascot——一款面向 InterSystems ObjectScript 的开源静态分析工具。

ascot 的核心功能之一是类型检查,它对控制流有着深刻的理解,包括涉及 $order、$data、for 循环、 条件语句以及后置条件。

此外,ascot 通过维护 ObjectScript 定义和引用的索引,帮助您浏览代码库。

ascot 专为人类和 AI 代理设计,通过 CLI、MCP 和 LSP 提供其功能。与InterSystems Language ServerVS Code 扩展的集成即将推出。

ascot 采用 Rust 🦀 编写,可在 crates.io 和 npm 上获取。

在 GitHub 上了解更多关于 ascot 的信息:https://github.com/intersystems-community/ascot

欢迎提交问题 🐛、提出功能请求 💡、贡献代码 🤝 以及点赞 ⭐!

2
0 30
文章 Lilian Huang · 十月 27 4m read

InterSystems ObjectScript – 编码代理测试套件基准测试

在我们的首次基准测试中,我们对InterSystems 编码基准测试平台对 14 个 模型进行了测试。详细情况可见这篇文章:https://cn.community.intersystems.com/node/589834

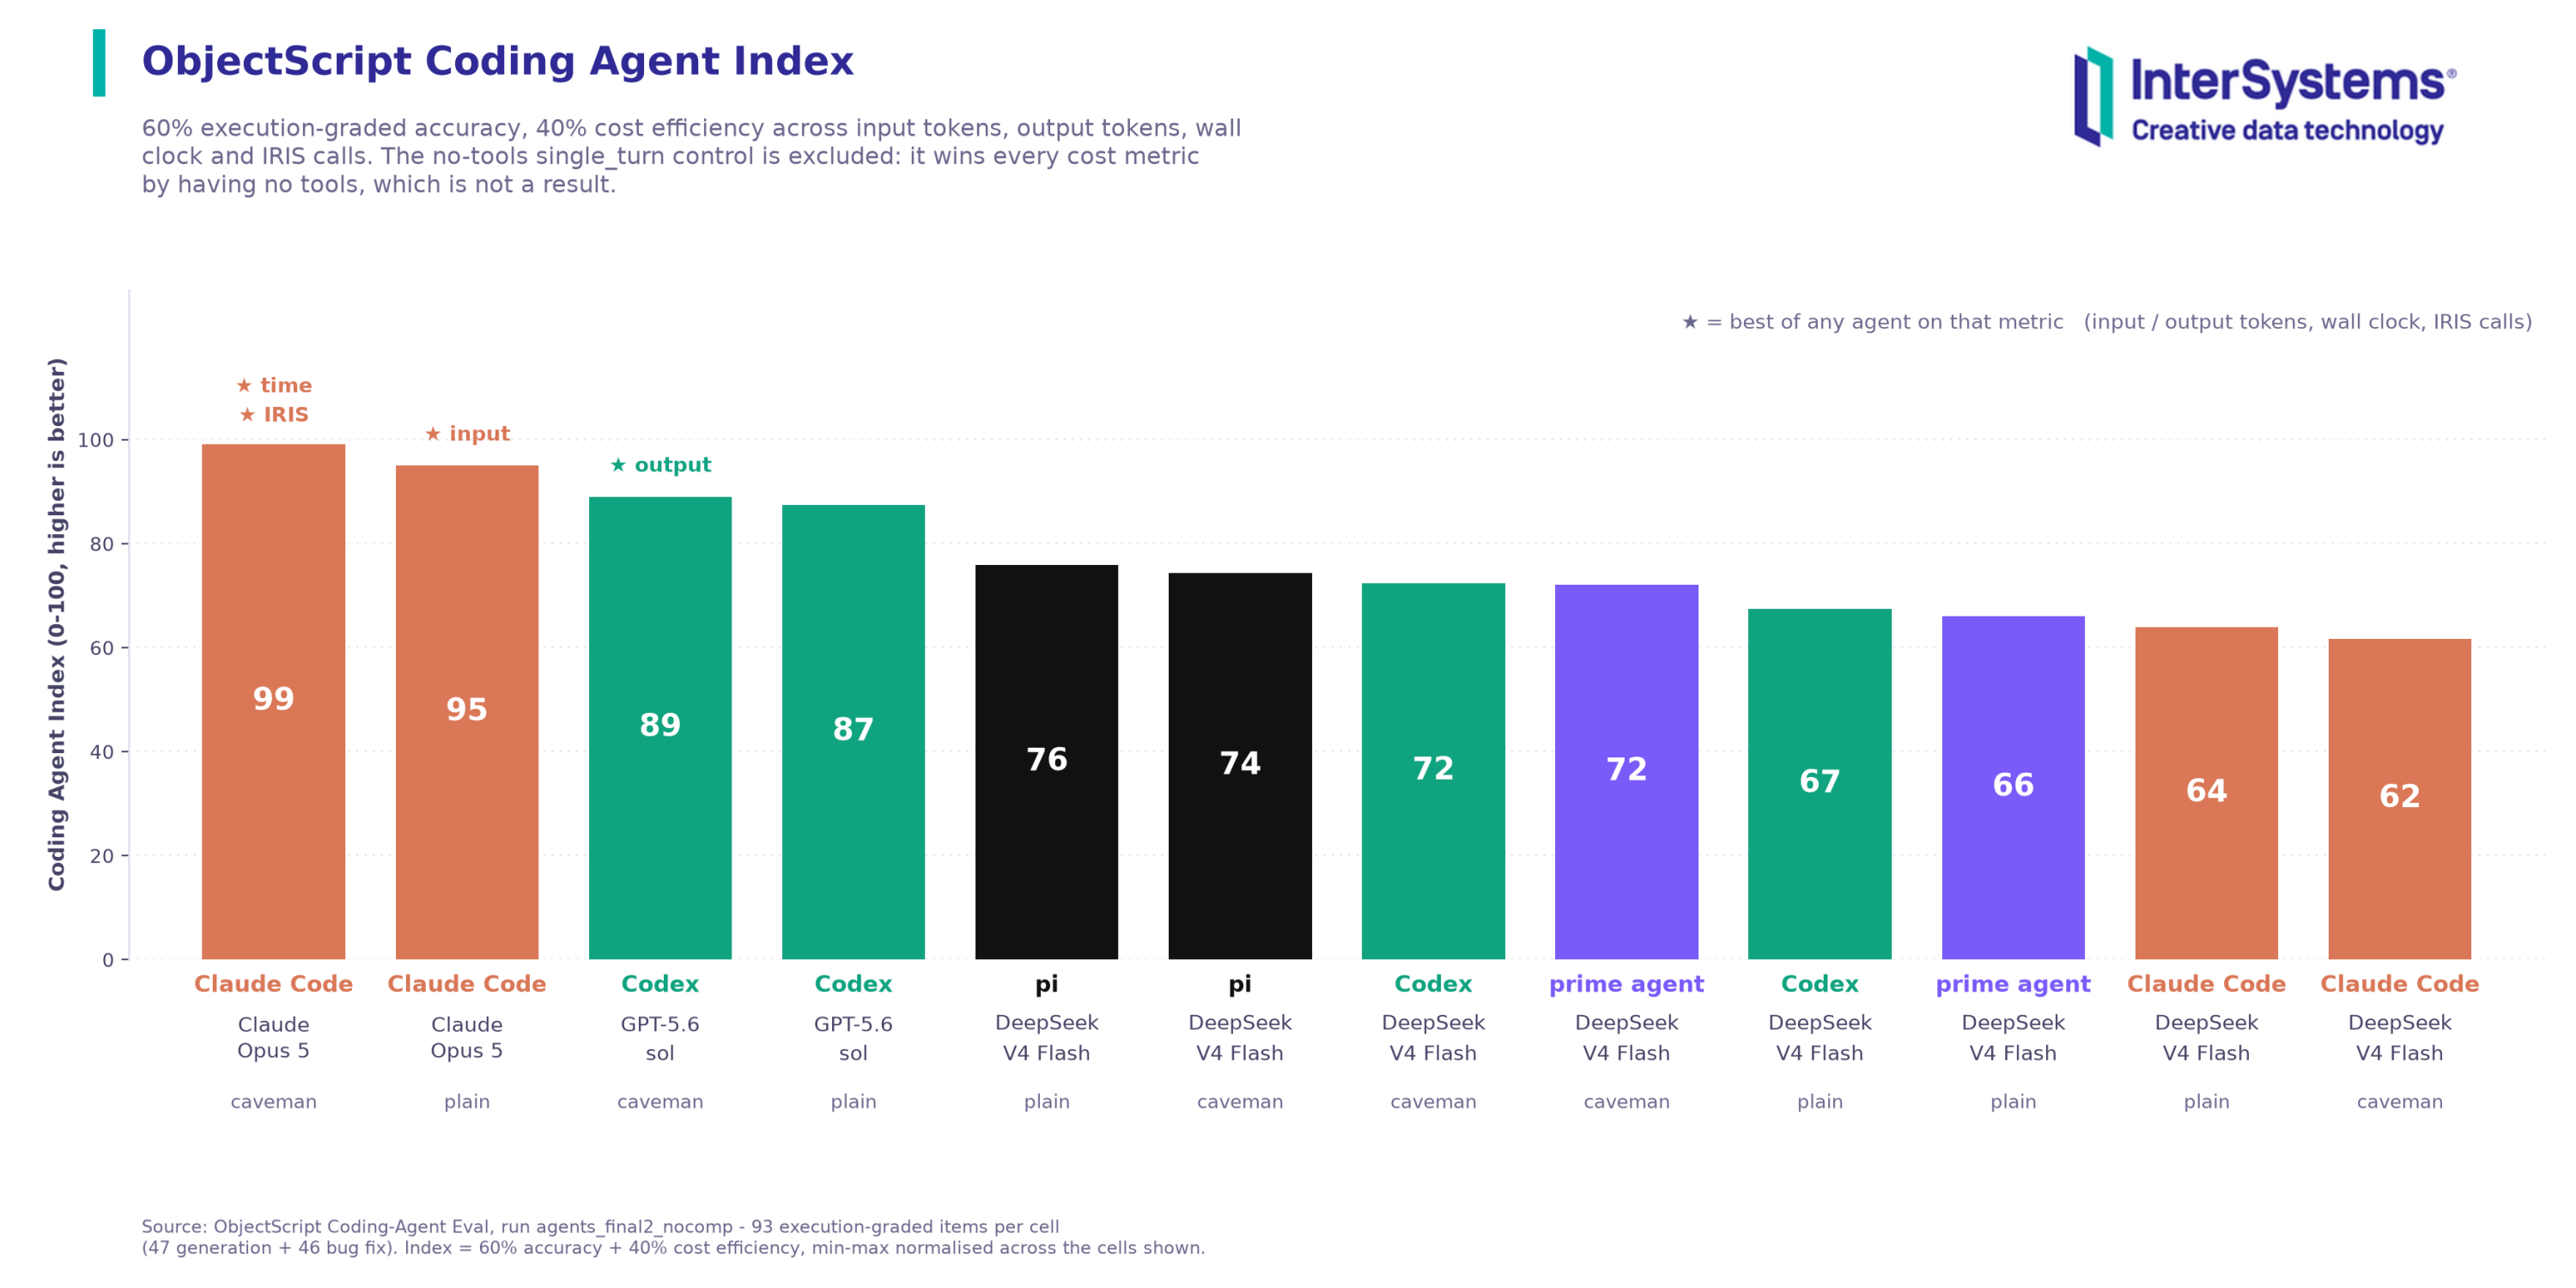
但鉴于测试结果,我们决定通过四种编码代理进行同样的测试;我们对 Claude Code、Codex CLI、pi 和 prime-agent 进行了测试,并加入了一个名为 caveman 的变体。Caveman 旨在限制提示符的 I/O 令牌数量。

我们通过在运行中的 IRIS 实例中编译并运行代码,对代理的运行情况进行了验证。

结果

成本效益指数

该指数是我们新创建的指标,设定为60%的准确率和40%的成本效率。成本效率是以下四项标准化 任务指标的平均值:输入令牌、输出令牌、墙钟时间和IRIS编译调用次数。 控制行被排除在外。

排名 单元格 指数 准确率 IRIS调用次数 实际时间
1 《Opus 5》· Claude Code · caveman 99.1 1.000 1.4 19.5 秒
2 Opus 5 · Claude Code · plain 95.0 0.989 1.5 24.5 秒
3 GPT-5.6 sol · Codex · caveman 89.
0
0 33
文章 Nicky Zhu · 十月 20 7m read

如果源表里有一列 FamilyName,而目标接口需要 FullName,集成程序应该怎么办?

可以因为两者都是文本,就把一个字段直接复制给另一个字段;也可以因为名称不同,就认为它们无法对应;还可以判断目标值可能需要由两个源字段组合而成——再确认这种理解是否符合当前集成场景。

这正是“匹配字段名称”和“设计数据映射”的区别。在 DataPipelineDemo 中,AI 会提出源数据与目标之间可能的对应关系;验证流程根据已有事实和约束检查这些建议;用户再审阅结果,并决定是否保存供后续管道生成使用。

1. 一条映射究竟说明什么?

这里有两个相关但不同层次的匹配:

  • 资产匹配:哪个源对象应该对应哪个目标对象?例如,哪张 SQL 表或哪类 FHIR 资源应输入某个目标实体或资源。
  • 字段映射:哪个源值应提供给某个目标字段?传递过程中是否需要转换?

因此,字段映射不只是两个名称的配对。它可以表示直接传值、组合多个值、提供常量,或执行术语映射等受控转换。源路径和目标路径固然重要,映射表达的意图同样重要。

2. 从相似名称到有意义的数据对应

字段名称是有用线索,但不能证明两个字段含义相同。两个都叫 Code 的字段可能属于不同编码体系或业务概念;名称不同的字段也可能表达同一个标识符。

结构和约束能补充更多上下文。目标可能要求必须提供某个值;字段可能需要日期、编码、引用或特定的 FHIR 路径。

0
0 57
文章 Claire Zheng · 十月 19 3m read

使用 Claude Code 实现基于 InterSystems 的 AI 辅助开发

Claude Code 是一款非常实用的工具。它能帮助解释方法、追踪 SQL 查询(获取结果甚至设置新值),或为代码提供修复/更新建议。
但要充分发挥其最佳效能并实现成本效益,仅靠让它解决问题是不够的。为了让 AI 更高效(且更安全),你还需要决定允许它修改哪些内容(就我而言,在我亲自审查其建议的修改并检查受影响的文件之前,不允许它进行任何修改), 它所需的上下文大小(主要由所用模型决定),以及该任务应投入多少推理精力(这会影响推理的深度,以及令牌的生成/消耗,从而影响成本)。

上下文压缩

随着对话规模的扩大,Claude Code 最终需要压缩其上下文(大多数模型的限制约为 100 万个令牌)。它会总结之前的对话内容,为后续对话腾出空间。 问题在于,摘要可能会遗漏你仍认为重要的内容,例如已被否决的方案,或是“不要触碰特定组件”之类的指令。

虽然 MEMORY.md 文件有所帮助,但它并不能保证每条指令在整个会话中都可用或被遵循,因为 Claude Code 只会自动加载其内存索引中的一小部分。
因此,你需要将最重要的指令放置在项目根目录下的 CLAUDE.md 文件中,因为该文件会在压缩后重新加载,而一些嵌套指令仅在需要时才会被重新加载。

0
0 42
文章 Nicky Zhu · 十月 11 7m read

让 AI 接手数据集成:几分钟里跑起来

一句话速览:登记数据源、选择目标,再让 LLM 设计数据集成流程。一条命令启动演示环境,再运行一条命令,就能端到端复现完整的数据管道。

git clone --recurse-submodules https://github.com/zlnick/DataPipelineDemo.git
cd DataPipelineDemo
bash tools/setup.sh && python3 tools/e2e_ui_flow.py

↑ 一次干净克隆环境中的实测:、验证通过,数据已写入目标 FHIR 仓库。


这是什么

这是一个运行在 InterSystems IRIS for Health 上的完整演示:由数据源出发,自动生成并运行互操作性数据管道,其中的关键决策由 AI 完成。

  • 数据源(2 种):FHIR 接口、SQL 表
  • 转换目标(3 种):数据库表、SOAP 服务、FHIR 仓库
  • 支持多种源与目标组合,也支持在同一个 Production 中运行多条数据管道
  • 提供中英双语界面:默认中文,英文界面位于 /en


一套 IRIS 实例同时承担多个角色:FHIR 服务器(包含相互独立的源与目标两个仓库)、互操作性引擎(Production)、SQL 数据库,以及平台自身的元数据存储。

0
0 49
文章 Kelly Huang · 九月 30 4m read

今天外面天气真好,南半球,尤其是悉尼,终于迎来了春天, 但上周我和同事们在黑山度过了愉快的时光,庆祝Banksia成立五周年,回来后我严重时差反应,再加上还在对抗感冒症状,所以现在还是静静地坐在电脑前比较好,而不是去外面寻找新的疯狂冒险。 还有什么比浏览社区帖子更能让这段时间物有所值呢?

其中一篇特别引起了我的注意,那是@Nicholai.Mitchko关于大语言模型(LLM)代理编码基准测试的精彩研究与文章——如果你还没读过,不妨先去读一读。 研究结果基本印证了我的经验感受——在IRIS编码方面,Claude系列模型表现大同小异;正因如此,如今我进行编码任务时几乎只使用Sonnet,而OpenAI的模型虽然稍逊一筹,但依然表现不俗。 不过有一个意外发现:DeepSeek V4 Flash模型,其排名几乎与Claude持平。这激发了我尝试DeepSeek的兴趣。正如我的同事@Aleksandr Kolesov在他最近的文章中所指出的,在大型语言模型(LLM)领域,即使全力以赴,也只能勉强维持现状。

安装

Nicholai 使用的是自托管的 DeepSeek,慷慨地将其成本标为 0 美元,但我的这台“强悍”的 MacBook Air 在性能方面肯定表现不佳,所以今天我们将使用托管版本。

0
0 49
文章 Kelly Huang · 九月 29 5m read

ChatGPT刚推出时,开发者们很快就开始将其用于日常任务:调试代码片段、编写小型辅助程序,或是理解陌生的代码。其中大部分工作都需要大量复制粘贴。

像 Claude 和 Codex 这样的编码代理改变了这一现状。它们能够直接处理代码库,并对多个文件进行修改。但对于 ObjectScript 开发而言,“经典”的代理式流程并不总是最合适的选择。在 本文中 ,我们将讲述我们如何将 AI 代理整合到自身工作流程中的故事。

从何入手?

过去,我们为客户维护的某个系统,其开发工作直接在共享的服务器端开发系统上进行。每位开发人员都在那里实现并测试自己的更改。随着团队规模扩大,多人开始同时处理该系统,这种工作流程变得越来越不切实际。

AI 编码代理的引入让这些局限性变得更加明显。Claude 和 Codex 等工具的工作原理是直接检查和修改源代码。相关文档和指南指出,如果它们能够编译代码并运行自己的测试,效果会更好。但在 IRIS 中通过 VS Code 进行服务器端开发时,这一实验在第一步就失败了。 由于文件并未实际存在于机器上,代理难以直接访问。因此,将开发迁移到本地、受版本控制的仓库中成为自然而然的一步:这不仅改善了协作,还为开发人员和代理都提供了合适的工作空间。

但这仍留下了一个问题:如何让代理能够编译代码并运行测试。

0
0 50
文章 Jeff Liu · 九月 28 19m read

正在进行的选举

时间是2026年8月,巴西的大选竞选活动正在进行中。 10月4日,158,745,463名符合条件的选民将投票选举总统、各州州长、参议员、联邦众议员以及各州或联邦区众议员。总统和州长选举的第二轮投票(如有)定于10月25日举行。上述日期和选民人数数据均来自巴西最高选举法院。

在这个时间节点上,随着数百万民众试图了解候选人背景、竞选主张及公共履历,公共信息已成为当务之急。巴西虽公开了大量选举和立法数据,但这些记录仍分散在各类文件、API、标识符及政府门户网站中。

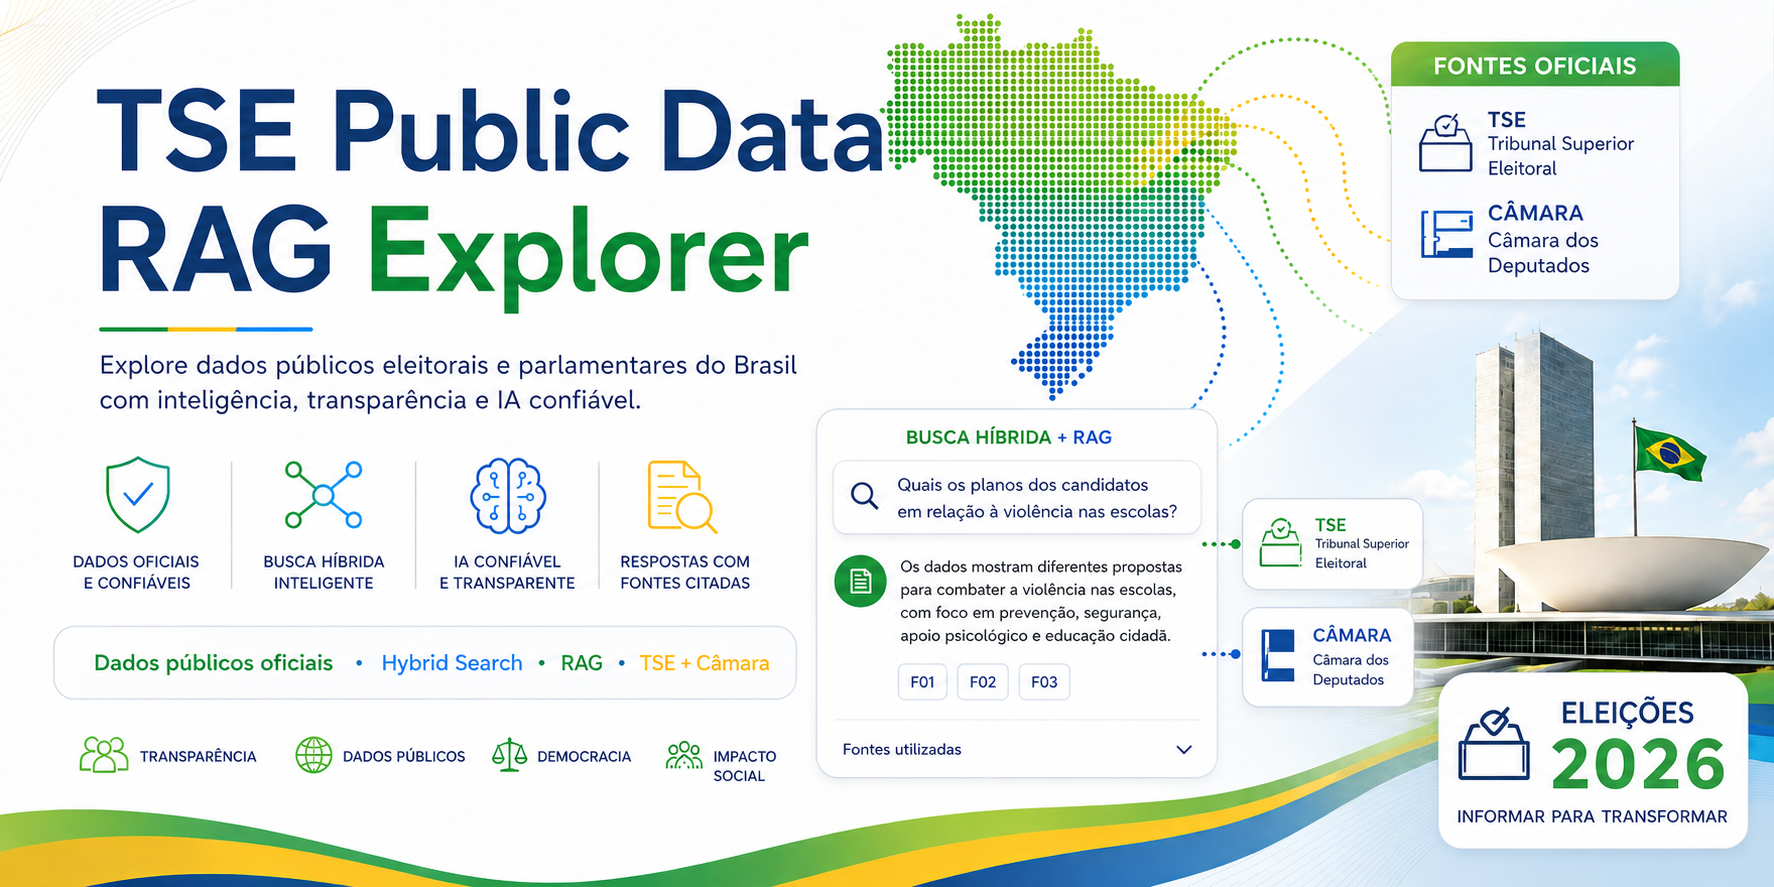
正是在这样的背景下,我们开发了“TSE公共数据RAG探索器”。

Banner do TSE Public Data RAG Explorer

开放数据丰富,但要得出答案却并非易事

一个看似简单的问题,可能需要有人先找到一个API,然后进行分页操作,下载ZIP压缩包,解码Latin-1格式的CSV文件,从PDF中提取文本,理解两个机构的标识符,在它们之间建立个人关联,最后阅读冗长的文档。

主要障碍在于数据访问:定位、关联并解读通过不同来源发布的记录。

该项目始于一个问题:

在选举年,我们如何将关于候选人和当选官员的海量公共数据转化为任何公民都能探索的信息?

该解决方案在孤立的过滤器以及语言模型的内部记忆之外,增添了一层基于证据的研究层。在敏感领域,可检索的证据是每个流畅回答的必要条件。

基于官方证据的自然语言处理层

TSE 公共数据 RAG 探索器与其说是一个选举聊天机器人,不如说是一个公共数据智能平台。

0
0 60
文章 Lilian Huang · 九月 9 4m read

我们发布了首个在 InterSystems ObjectScript 和 IRIS 平台上衡量 LLM 能力的开放式基准测试:ObjectScript LLM 基准测试。

为何推出该基准

现有的编程基准测试——SWE-bench、LiveCodeBench、Terminal-Bench——均基于 Python、 JavaScript 和 shell 语言。其中没有一项涵盖 ObjectScript、IRIS SQL、嵌入式 Python 或 %CSP.REST。 已发布的编程评分无法直接应用于 IRIS 平台。这是首次尝试 直接衡量这一差距。

我们测量的内容

140个手工编写的项目,涵盖三个类别:代码生成、代码理解和错误修复。 主要评分器是一个实时运行的 IRIS 实例——模型响应会被编译并执行, 输出结果与预期字符串进行比对。对于 93 个基于执行结果评分的 题目,不存在主观评分。47 个理解类题目则采用基于评分标准的 LLM 评判器。

我们运行了14个模型(Claude 4.x/5、GPT-5变体以及三个自托管的Qwen3/DeepSeek模型), 均采用其可用的最高推理配置,每个项目在温度为0的条件下生成一个响应。

总体结果

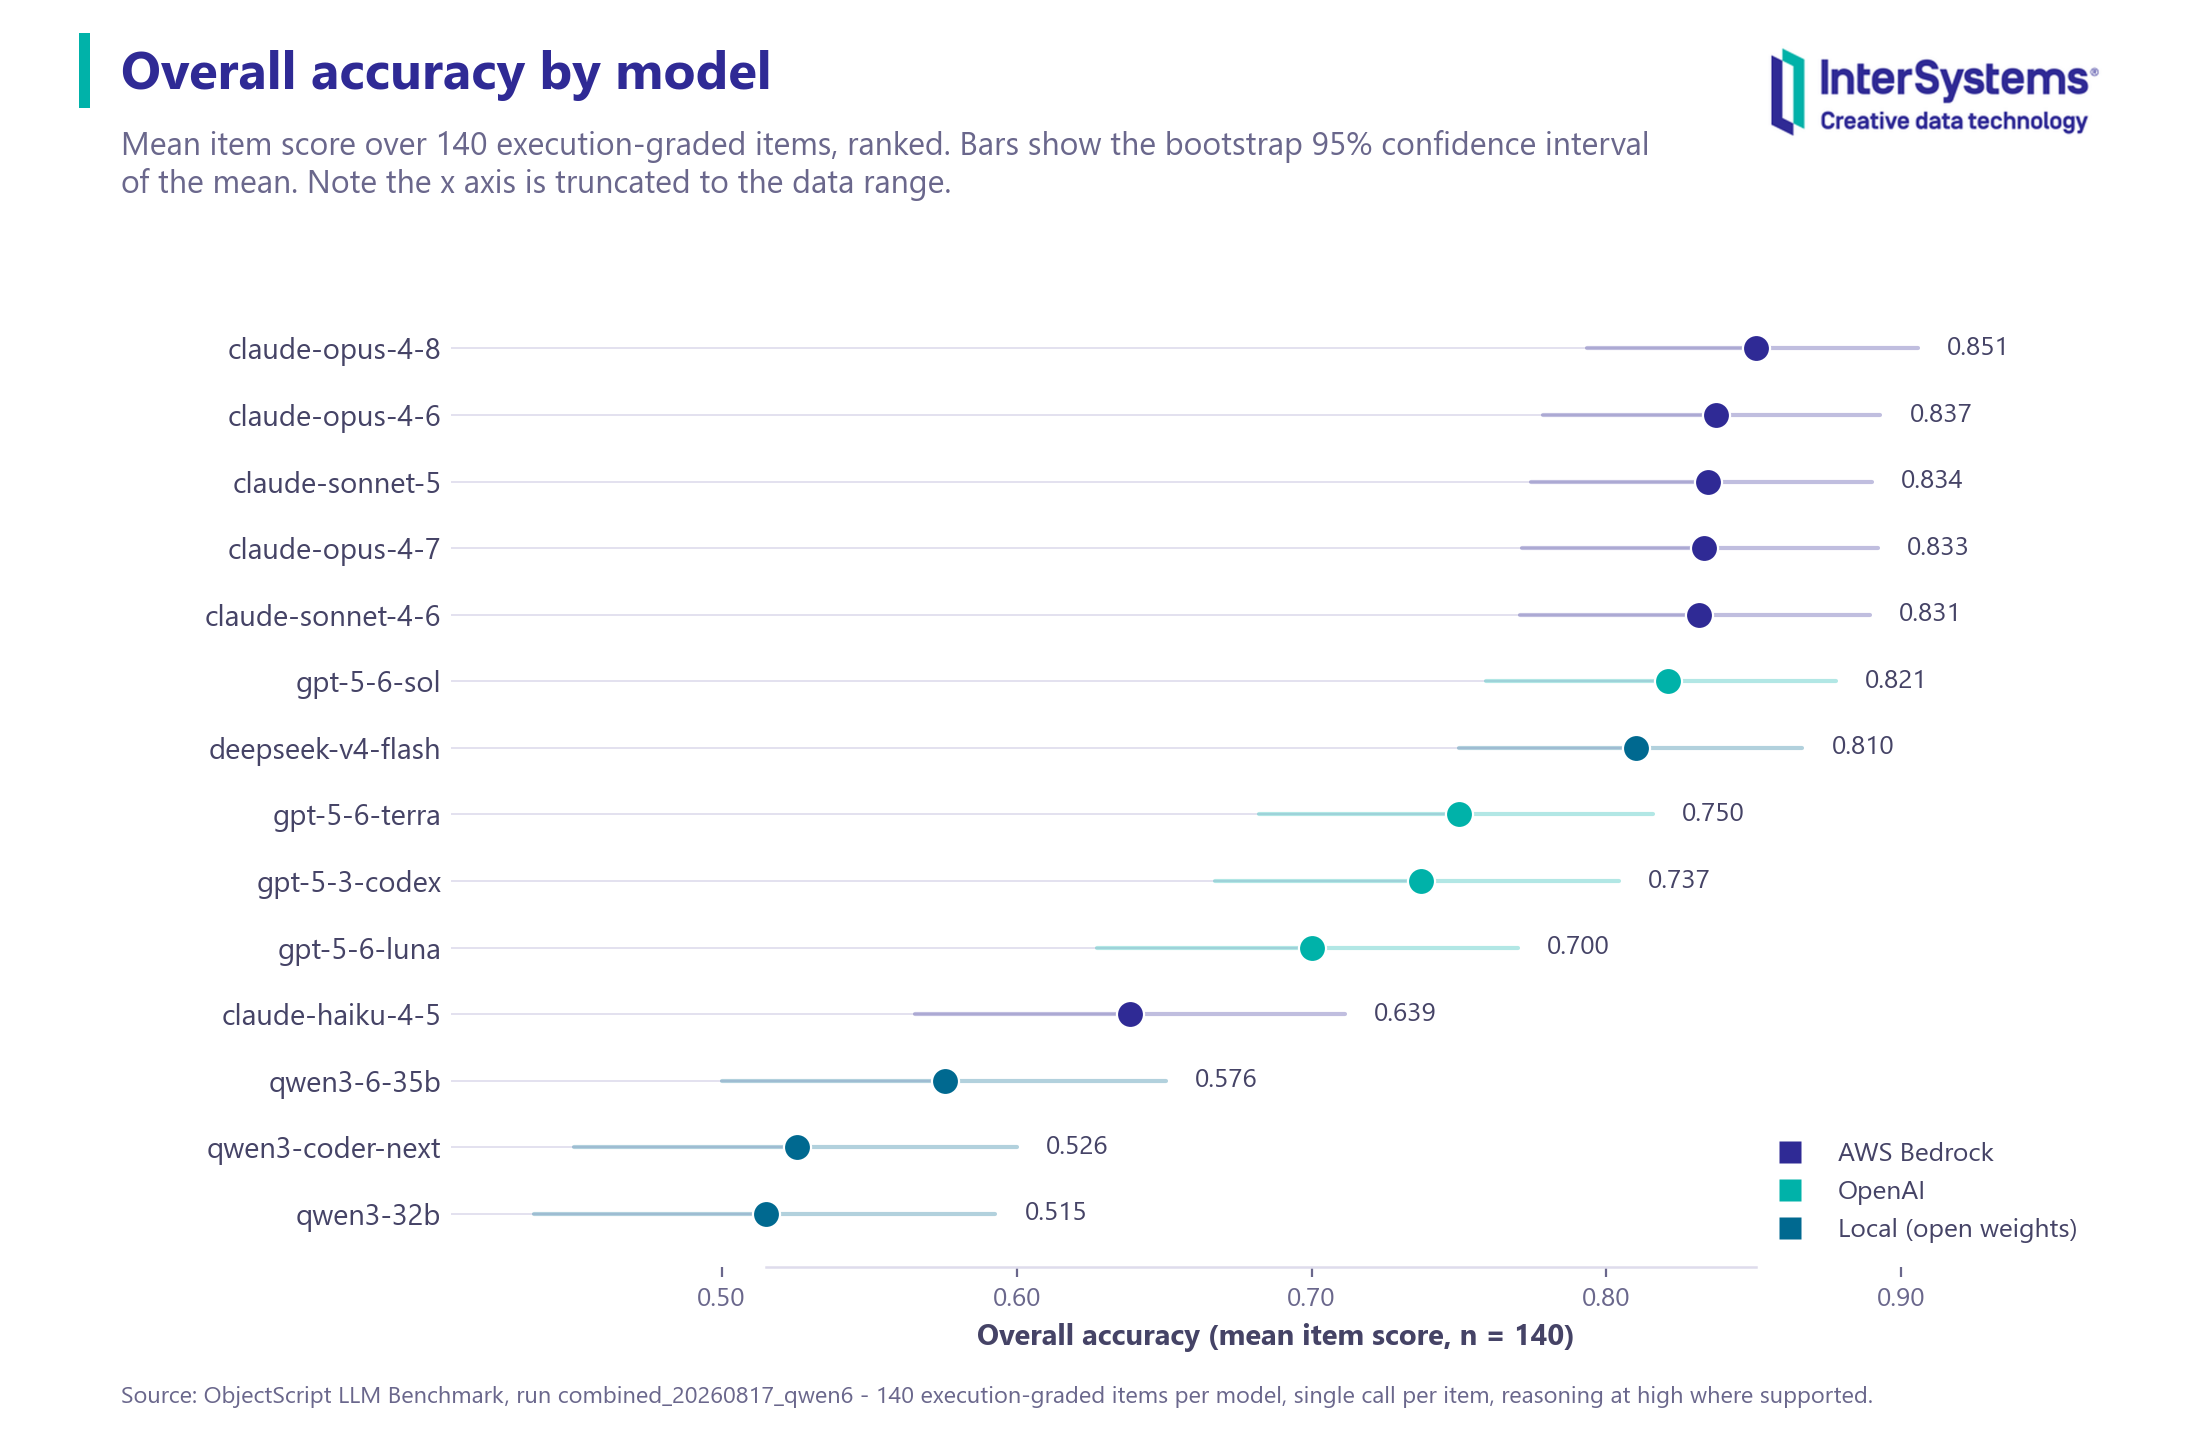
Overall accuracy by model with 95% bootstrap confidence intervals

总体准确率在0.515至0.851之间。 排名前九的模型集中分布在 0.737 至 0.

0
0 77
文章 Lilian Huang · 八月 28 10m read

本系列的第一部分。第二部分将介绍完整的工具目录。第三部分将介绍 ObjectScript 技能。第四部分将介绍基准测试以及如何衡量实际的改进效果。


隐藏在注释中的问题

托马斯·马祖尔(Thomas Mazur)关于 VS Code 生产力——Peacock、作用域工作区文件、Copilot 代理模式——的 博文《青蛙、鸡、AI 和 VS Code》 在评论区揭示了一个更尖锐的问题。皮耶特罗·迪·莱奥(Pietro Di Leo)和 Mike.W 指出,当你在 VS Code 中进行服务器端开发时, isfs:// 大多数 IRIS 生产环境所使用的“工作区”中,Copilot 只能看到编辑器中打开的文件,无法对虚拟文件系统进行索引。对于拥有数千个类的成熟 IRIS 应用程序而言,AI 的工作效果就像是透过钥匙孔观察一样。

John Murray 向大家推荐了我正在开发的项目——iris-agentic-dev——并指出目前开发者社区中尚无相关文章。因此,本文将阐述:该问题产生的原因、该工具如何解决该问题,以及如何在约五分钟内完成部署。


为什么 AI 无法“看到”你的命名空间

当你打开一个 isfs:// 工作区时,你的 IRIS 类存储在服务器上,而非本地磁盘。

0
0 57